服务器续命程序有哪些?核心是监控告警、进程守护、故障转移、资源降级、自动重启、备份恢复和云上保活工具的组合,单独一个看门狗只能救进程,串成闭环才能救业务。
当服务器开始老化,CPU、内存、磁盘、电源都在退化,业务却不能立刻迁移,这时“续命”不是玄学,而是用软件和流程把故障窗口压短,业内专家指出,续命程序的价值不在“永远不宕机”,而在缩短MTTR,也就是从故障发生到恢复的时间。

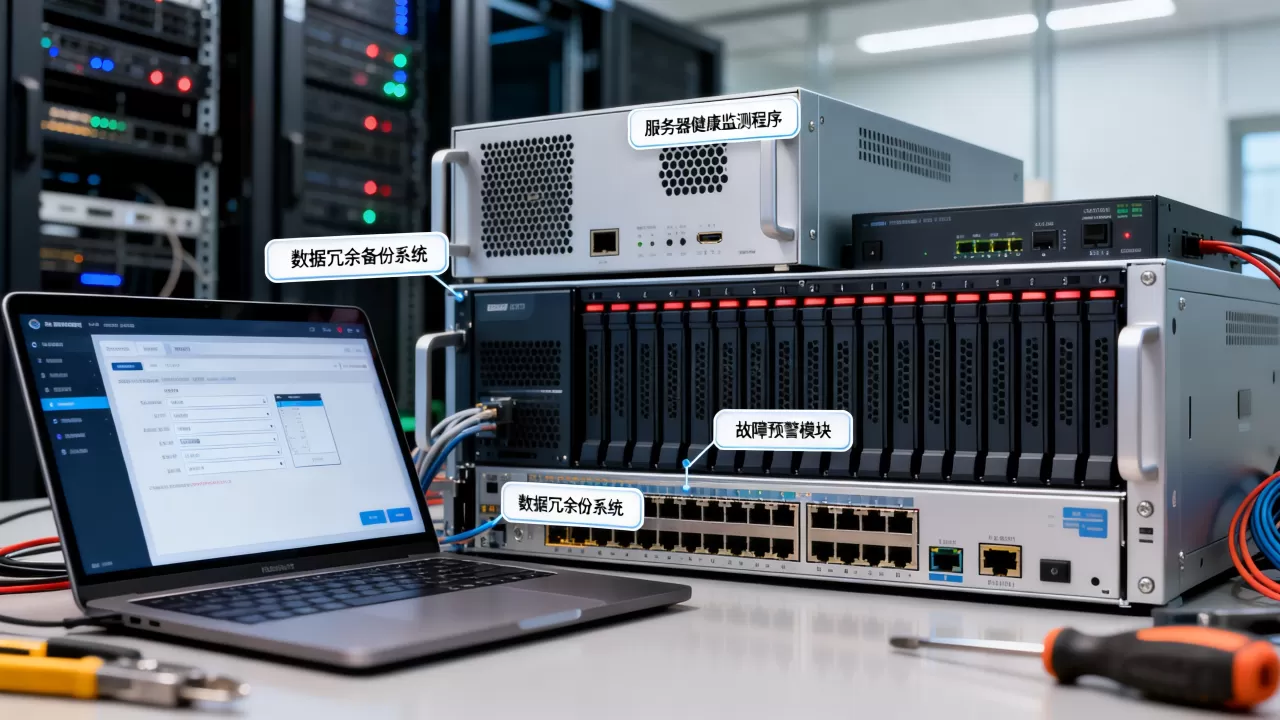
服务器续命程序有哪些?先分清监控、保活与降级三类
进程级保活:systemd、Supervisor、PM2
这类工具解决“服务挂了没人拉起来”的问题,适合Web服务、API、脚本任务、Java进程、Python常驻程序。
- systemd:Linux原生,写一个unit文件,建议路径
/etc/systemd/system/myapp.service。 - Supervisor:适合多进程、多语言混合部署,配置路径常见
/etc/supervisord.d/。 - PM2:Node.js生态常用,也支持Python、Go等通过解释器启动。
systemd示例:
[Unit]
Description=My App
After=network.target
[Service]
ExecStart=/usr/bin/python3 /opt/app/main.py
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.target
执行:
systemctl daemon-reload
systemctl enable --now myapp
systemctl status myapp
Supervisor示例:
[program:myapp]
command=python3 /opt/app/main.py
autostart=true
autorestart=true
startretries=3
执行:
supervisorctl reread
supervisorctl update
supervisorctl status
PM2示例:
pm2 start app.js --name myapp
pm2 startup
pm2 save
pm2 monit
这些工具只能保证进程层恢复,数据库连接池耗尽、磁盘写满、内存泄漏,仍然需要监控和人工或自动处置。
系统级监控与自愈:Zabbix、Prometheus、Nagios
监控程序负责发现异常,自愈程序负责触发动作,两者分开时,告警会很多,恢复却很慢。
- Prometheus:采集指标,配合Alertmanager发告警,常用exporter有node_exporter、blackbox_exporter。
- Zabbix:适合传统IDC和混合云,触发器加远程命令可做简单自愈。
- Nagios:老牌工具,插件丰富,适合主机、端口、HTTP检查。
Prometheus告警规则常见判断:
- alert: InstanceDown
  expr: up == 0
  for: 1m
  labels:
    severity: critical
Alertmanager收到告警后,可通过webhook调用Ansible、脚本或工单系统,Zabbix可在触发器中配置远程命令,例如重启服务、清理临时文件,Nagios可用event handler执行恢复脚本。
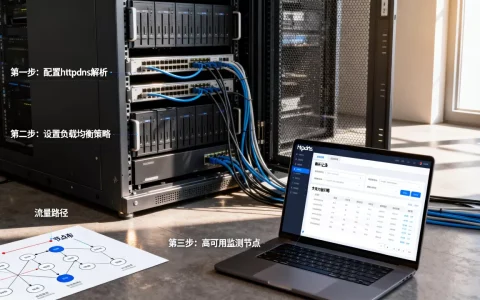
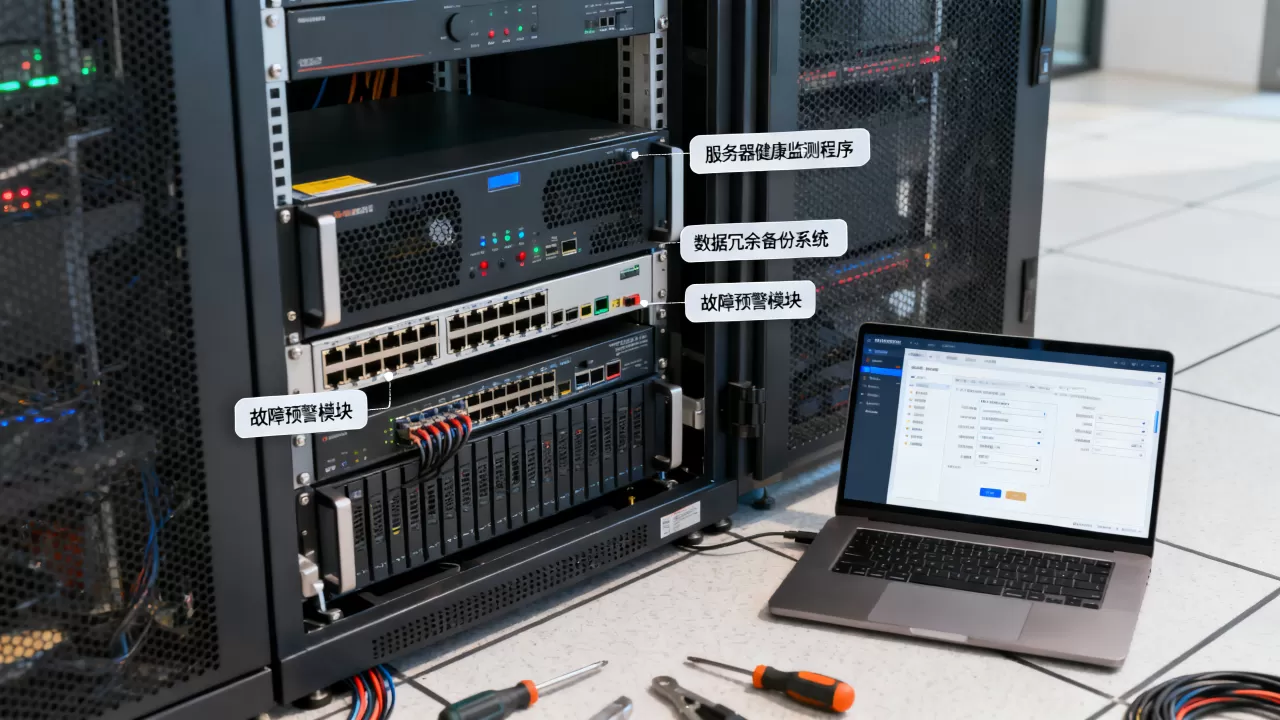
高可用与故障转移:Keepalived、HAProxy、Pacemaker
单机续命到极限后,需要节点级切换。
- Keepalived:管理VIP漂移,常用于Nginx、HAProxy、LVS前端。
- HAProxy:做四层或七层代理,健康检查失败自动摘除后端。
- Pacemaker加Corosync:适合数据库、文件系统、虚拟IP等资源级高可用。
- Patroni、Orchestrator、MHA:数据库主从切换常用组合。
HAProxy后端健康检查示例:
backend web_servers
    option httpchk GET /health
    server web1 10.0.0.1:80 check
    server web2 10.0.0.2:80 check
Keepalived核心配置:
vrrp_instance VI_1 {
    state MASTER
    interface eth0
    virtual_router_id 51
    priority 100
    virtual_ipaddress {
        192.168.1.100
    }
}
切换类程序不是装完就稳,脑裂、VIP冲突、数据不一致,都需要仲裁和演练。
资源降级与限流:Nginx、Redis、数据库代理
续命不只是“重启”,当资源不够时,主动降级能保住核心功能。
- Nginx:限流、熔断、返回静态降级页。
- Redis:设置maxmemory和淘汰策略,避免内存打满。
- 数据库代理:读写分离、连接池、慢查询隔离。
- 消息队列:削峰填谷,防止突发流量压垮后端。
Nginx限流示例:
limit_req_zone $binary_remote_addr zone=api:10m rate=10r/s;
server {
    location /api/ {
        limit_req zone=api burst=20 nodelay;
        proxy_pass http://backend;
    }
}
服务器续命程序和硬件延保哪个划算?对比适用场景
软件续命和硬件延保不是二选一,软件续命处理服务异常、节点切换、资源过载,硬件延保处理磁盘、电源、内存、主板等物理故障,老旧服务器如果单点多、备件少,硬件延保能减少停机,业务可容器化、可多副本,软件续命更划算。
| 对比维度 | 软件续命程序 | 硬件延保 |
|---|---|---|
| 处理对象 | 进程、服务、节点、流量 | 物理部件、整机维保 |
| 典型手段 | 监控、重启、切换、限流 | 换件、上门、备件库 |
| 成本构成 | 人力、工具、开发 | 年费、备件等级、响应时效 |
| 恢复速度 | 取决于自动化程度 | 取决于备件和工程师到场 |
| 适用场景 | 可多副本、可迁移业务 | 核心单点、老旧设备、备件难找 |
| 主要风险 | 误切换、脑裂、配置错误 | 费用高、原厂停保 |
北京服务器续命程序价格大概多少?本地服务与远程方案
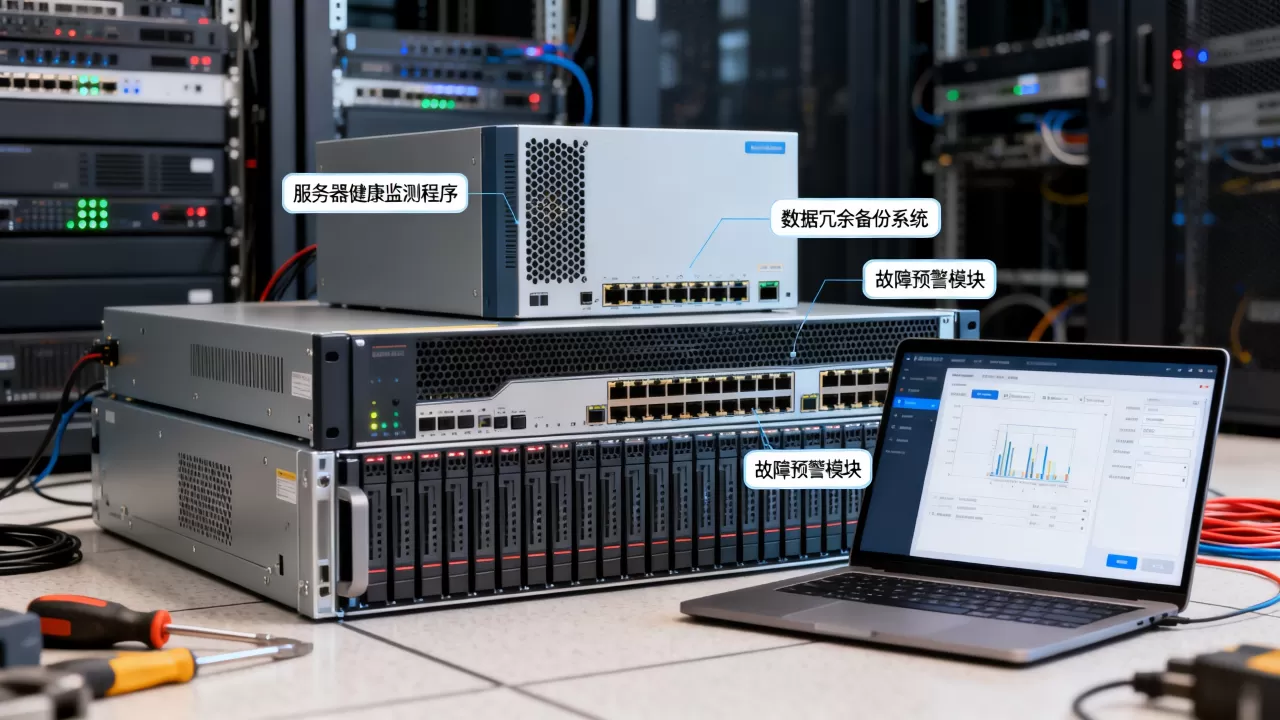
北京机房现场服务通常按次上门、备件等级、响应时效计价,远程方案主要看运维人力和工具投入,价格差异来自服务半径、是否7×24、是否包含数据库切换,自建方案使用开源工具,软件授权成本低,但需要有人写规则、做演练,商业监控和驻场服务省心,费用更高,选择时不要只看单次报价,要看故障恢复SLA和是否包含切换演练。
中小公司服务器续命程序怎么选?按业务连续性分级
中小公司资源有限,建议按业务分级。
- A级:订单、支付、核心API,需要多副本、负载均衡、数据库主从、自动切换。
- B级:内部OA、报表、文件服务,需要监控告警、进程保活、快照恢复。
- C级:测试、临时环境,用cron脚本和基础告警即可。
最小可用组合:Prometheus加Alertmanager加Ansible加Keepalived加HAProxy,预算再紧,也要保留进程保活和磁盘告警。
云服务器续命程序有哪些?云监控与自动迁移
云监控与自动恢复
主流云厂商提供云监控、告警、自动恢复、快照、镜像、弹性伸缩,操作路径通常是:控制台进入云监控,创建告警规则,绑定通知模板,再关联自动恢复或函数计算,负载均衡健康检查失败后,会自动摘除异常节点,弹性伸缩可根据CPU、内存、QPS增减实例。
容器与K8s探针
Kubernetes自带liveness、readiness、startup探针,liveness失败会重启容器,readiness失败会停止流量,配合HPA、PDB、多可用区,能实现节点级续命。
常用命令:
kubectl get pods -o wide
kubectl describe pod myapp-xxx
kubectl logs myapp-xxx --previous
kubectl rollout restart deployment/myapp
多可用区与快照
云上续命不能只靠单可用区,数据库主备、对象存储跨区、镜像跨区复制、快照定时策略,都是基础动作,快照要定期恢复验证,没验证过的备份,只能算心理安慰。
自建服务器续命程序有哪些?从监控到自动恢复的实操清单
保活脚本
用cron每分钟检查本地健康接口:
/1 /usr/local/bin/check_nginx.sh
脚本逻辑:
#!/bin/bash
code=$(curl -s -o /dev/null -w "%{http_code}" http://127.0.0.1/health)
if [ "$code" != "200" ]; then
  systemctl restart nginx
  echo "$(date) nginx restarted, code=$code" >> /var/log/watchdog.log
fi
告警通道
Alertmanager、Zabbix、Nagios都可接入企业微信、钉钉、飞书、短信、电话,告警要分级,P0电话,P1群消息,P2工单,告警风暴时,先聚合再通知。
备份与回滚
- 系统盘:快照、Clonezilla、rsync。
- 数据库:binlog、WAL、逻辑备份、物理备份。
- 配置:Git管理,Ansible下发。
- 回滚:蓝绿部署、金丝雀发布、版本化镜像。
演练与验证
定期做故障演练:kill -9进程、systemctl stop服务、断开网卡、写满磁盘、模拟数据库主库宕机,观察监控是否告警,切换是否自动,数据是否一致,据工信部相关通报,近年来因配置错误和运维不当引发的服务中断,在事故中占相当一部分,演练能提前暴露这些问题。
2026年服务器续命程序有哪些组合最稳
推荐组合
- 传统IDC:Zabbix或Prometheus + Keepalived + HAProxy + Ansible + 定期快照。
- 云上:云监控 + 负载均衡 + 弹性伸缩 + 多可用区 + 快照。
- 容器化:K8s探针 + HPA + PDB + Prometheus + 日志系统。
- 数据库:Patroni或Orchestrator + 备份验证 + 延迟从库。
行业共识认为,监控、切换、恢复必须形成闭环,只有告警没有动作,等于把压力留给值班人,只有动作没有验证,等于把风险留给下一次故障。
避坑清单
- 只监控不恢复:MTTR仍然很长。
- 自动重启太激进:可能反复重启,掩盖根因。
- 切换没有仲裁:容易脑裂。
- 备份不验证:恢复时才发现不可用。
- 告警没有分级:真正故障被淹没。
- 权限过大:自愈脚本可能误删、误停。
服务器续命程序常见问题Q&A
服务器续命程序有哪些是免费的?
开源免费工具包括systemd、Supervisor、PM2、Prometheus、Zabbix、Nagios、Keepalived、HAProxy、Patroni,云监控基础版通常免费,但高级告警、电话通知、自动恢复可能按量或按套餐收费,商业软件和驻场服务则按授权、节点数、服务时效计价。
服务器续命程序能替代硬件维修吗?
不能,软件续命处理进程崩溃、服务假死、节点故障、流量过载,硬件维修处理坏盘、坏电源、坏内存、主板故障,两者互补,老旧服务器应同时保留备件、RAID、双电源和维保渠道,软件层再做多副本和自动切换。
服务器续命程序有哪些适合老旧Windows Server?
Windows可用服务恢复、任务计划、性能监视器、Zabbix Agent、SCOM、Windows Admin Center和故障转移集群,服务恢复命令示例:
sc failure MyService reset= 86400 actions= restart/5000/restart/10000/restart/30000
故障转移集群可配置共享存储和仲裁盘,实现节点级切换。
服务器续命程序有哪些?答案不是单个软件,而是监控、保活、切换、备份、演练组成的闭环,把MTTR压下来,老旧服务器才能继续扛住核心业务。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/686093.html