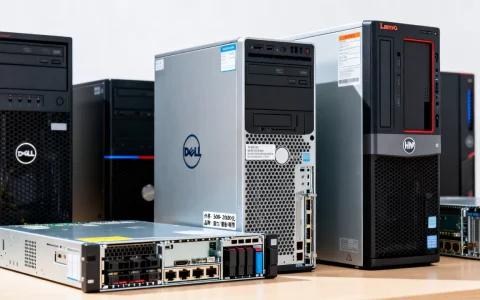
存储算力服务器并没有统一的分类标准,但在实际采购和部署中,业内通常按存储架构、硬件形态和应用场景三个维度来划分,目前主流的类型包括分布式存储服务器、集中式存储服务器、GPU存储混合服务器以及高密度JBOD扩展柜等。
从存储架构看服务器类型
存储架构决定了服务器“怎么存”和“怎么取”,这是选型时最先要明确的维度。


分布式存储服务器
分布式存储服务器是目前云计算和大数据领域的主流选择,它把多台普通服务器的硬盘通过软件层聚合起来,形成一个逻辑上的超大存储池,这种服务器通常采用通用x86硬件,搭配Ceph、GlusterFS或MinIO等软件定义存储平台。
- 典型配置:2U机架式,12-24个3.5英寸硬盘位,搭配万兆或二十五万兆网卡
- 适用场景:视频监控存储、云盘、大数据分析冷热数据分层
- 优势:横向扩展能力极强,硬件成本相对可控
- 代表产品形态:浪潮NF5266系列、华为OceanStor 9000分布式节点
对于采购方来说,存储算力服务器有哪些型号值得关注,答案是分布式节点几乎是所有大型云服务商的基础设施标配。
集中式存储服务器
集中式存储服务器沿袭了传统存储阵列的设计思路,通常包含专用的控制器架构和缓存加速模块,它和普通服务器的最大区别在于,计算和存储高度耦合,但对外提供的是块存储或文件存储接口。
- 中高端型号多采用FC、iSCSI或NVMe-oF协议
- 适用于数据库、虚拟化平台等对延迟极度敏感的业务
- 企业核心业务系统,如ERP、金融交易系统,仍偏向集中式存储
行业共识认为,集中式存储服务器的单GB成本高于分布式方案,但数据一致性和可靠性表现更优。
按物理形态划分的存储服务器
物理形态直接影响机房空间利用率和运维方式,这也是不少人在搜索“存储算力服务器价格及配置”时最关心的细节。
高密度存储服务器(JBOD/JBOF形态)
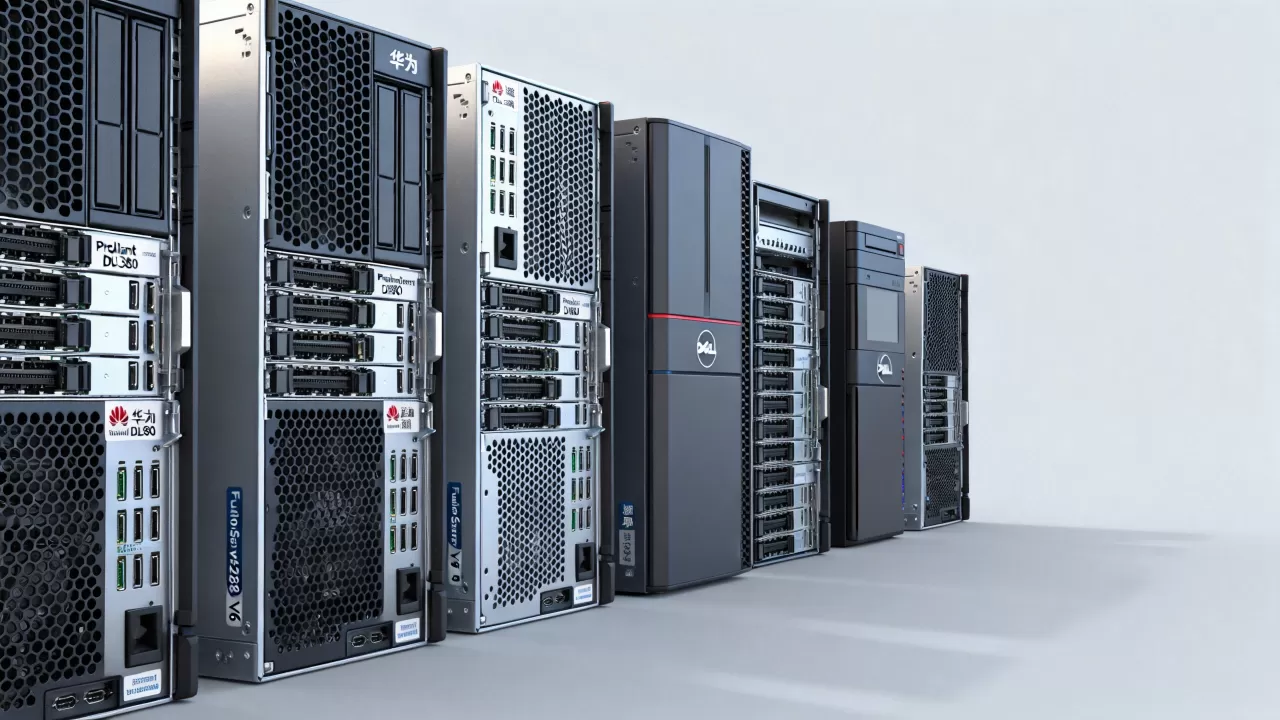
高密度存储服务器将硬盘数量堆到极限。JBOD(Just a Bunch of Disks)就是纯粹的硬盘扩展柜,本身不带计算能力,必须挂载在存储节点或计算节点下使用。
- 常见规格:4U机箱内装36块或60块3.5英寸硬盘
- 适合大规模数据归档、冷存储场景
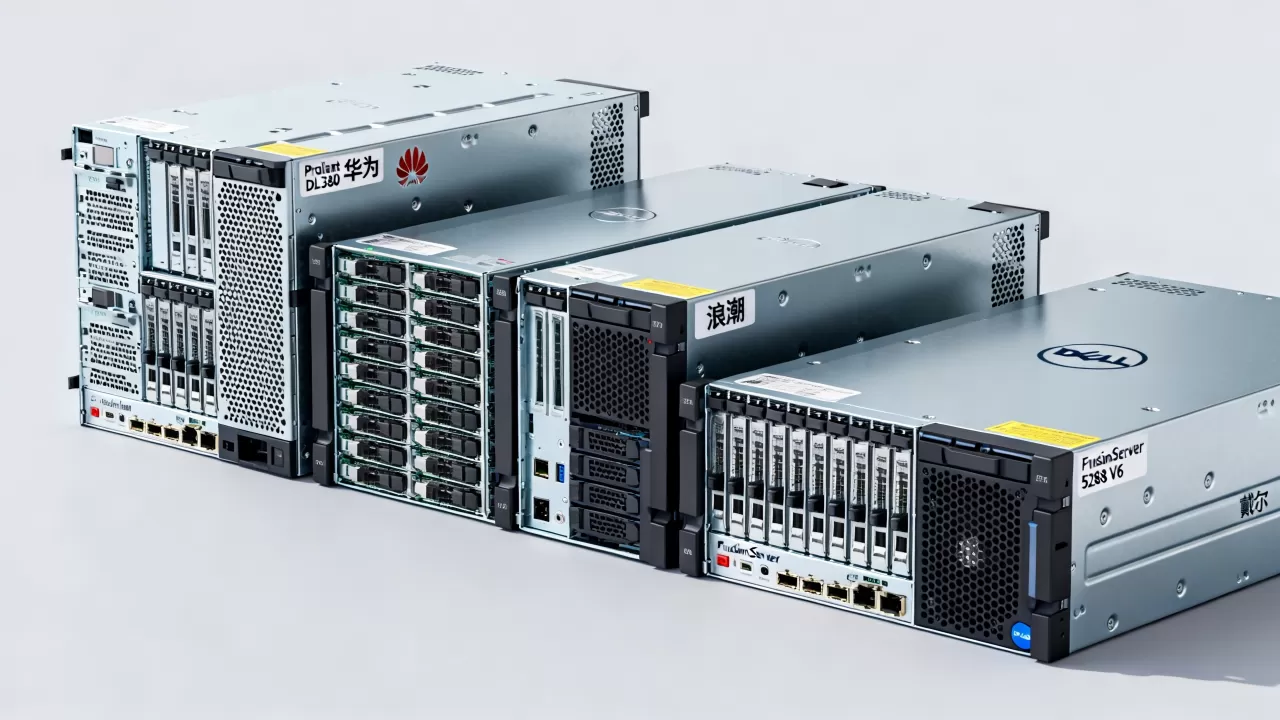
- 配图:曙光、浪潮、超微均有此类产品线
JBOF(Just a Bunch of Flash)则是全闪存形态的高密度服务器,所有硬盘位均支持NVMe SSD,性能极强,常用于核心数据库加速。
GPU存储混合服务器
这类服务器在存储能力之外,额外插入了GPU加速卡,听起来有点混搭,但在AI训练、遥感影像处理、基因测序等场景中非常实用。
- 既承担数据存储任务,又能在本地完成数据预处理
- 缓解“数据搬运”痛点,减少GPU集群和存储集群之间的网络开销
- 典型配置:4U机箱,24个硬盘位,可插入8张双宽GPU卡
对于图像识别、自动驾驶模型训练团队而言,存储算力服务器哪家好,往往取决于对混合架构的调优能力。
按应用场景定位服务器
单纯谈硬件没有意义,服务器最终要服务于具体的业务负载,以下是几个典型场景下的存储算力服务器画像。
视频监控与流媒体存储
视频监控数据的特点是写入连续、读取很少、容量增长极快,这类场景对存储算力服务器的要求集中在:
- 大容量机械硬盘位,单机支持100TB以上裸容量
- 支持纠删码或副本策略,承受多盘同时故障
- 配套流媒体协议,如RTSP、GB28181拉流存储
监控项目部署中,“存储算力服务器品牌排行榜”里经常出现的海康、大华,本质上也是基于通用分布式存储架构深度定制。
高性能计算与科研数据存储
科研机构需要存储海量小文件或超大单个文件,如气象模拟、流体力学计算,存储算力服务器的元数据性能和聚合带宽在这里是第一优先级。
- 需要部署并行文件系统,如Lustre或BeeGFS
- 服务器通常配备高主频CPU和大量内存,充当元数据节点
- 数据节点则偏向均衡型配置
在此类环境中,存储算力服务器推荐方案首选存算分离架构,即计算集群和存储集群独立扩容。
企业私有云与虚拟化
当企业运行VMware或OpenStack时,存储算力服务器扮演的是统一数据底座的角色。
- 存储节点与计算节点采用万兆网络互联
- 所有虚拟机的系统盘和数据盘统一存放在存储集群中
- 生产环境通常要求三副本或双副本保障
据工信部数据显示,近年国内私有云市场规模持续扩大,带动了中端存储服务器的出货量增长。
预算与价格体系分析
谈到存储算力服务器价格,需要先明确一个前提:价格差异极大,且没有标准报价单,影响价格的核心变量包括硬盘类型、数量、网卡速率以及软件授权方式。
| 配置类型 | 参考硬件层级 | 主要成本构成 |
|---|---|---|
| 入门级分布式节点 | 12盘位,4核CPU,32GB内存 | 硬盘占70%以上成本 |
| 中端全闪存节点 | 24盘位NVMe,双路CPU,512GB内存 | SSD与CPU成本并重 |
| 高端GPU混合存储 | 36盘位,8卡GPU,1TB内存 | 加速卡占比最高 |
如果你是初创团队或短期项目需求,可以考虑存储算力服务器出租的服务模式,按季度付费,获得现成的存储算力,避免前期大额固定资产投入。
采购中的隐性成本
- 软件授权费:分布式存储软件按节点或容量收费,可能超过硬件价格
- 机房功耗:高密度存储服务器的功耗密度较大,风冷和电费需要纳入核算
- 运维人工:存储集群的日常巡检、坏盘更换、容量再平衡都需要专人跟进
选型与部署实操建议
不要直接参考厂商的宣传册,以下步骤可以帮助找到合适的存储算力服务器方案。
- 确定IO模型:用
fio工具压测业务环境的读写比例,如果是32KB以下的小文件随机写,SSD节点起步;如果是大文件顺序写,机械硬盘高密度机型即可。 - 计算容量冗余:以可用容量除以0.8(考虑RAID和文件系统开销),再乘以副本数或纠删码比例。
- 检查网络瓶颈:存储节点的万兆网卡已经是底线,25GbE逐渐普及,必须确认交换机端口数量和缓存能力。
- 考虑扩容边界:预留至少一个空闲硬盘位或节点位,避免未来扩容时需整柜替换。
日常运维中,建议开启硬盘S.M.A.R.T监控和坏道扫描,结合厂商管理软件设定磁盘告警阈值,多数存储服务器支持热插拔硬盘,更换故障盘无需停机。
常见误区澄清
存储算力服务器并不等同于“硬盘多的普通服务器”,很多非专业用户在搜索“存储算力服务器有哪些型号”时,往往被表面的参数迷惑。
硬盘越多越好
硬盘增加确实提升容量,但存储节点的CPU、内存、网卡必须同步增强,否则大量硬盘的IO请求会拥堵在PCIe总线上,出现硬盘使用率不高但系统响应很慢的现象。
分布式存储一定比集中式便宜
当数据量在几十TB级别时,分布式存储的多副本机制造成巨大浪费,此时一套双控集中式存储,反而性价比更高。
忽略软件生态绑定
部分存储服务器出厂预装特定厂商的存储操作系统,如果后续想切换到开源Ceph,需要确认硬件是否在兼容列表内,否则可能出现驱动不识别硬盘的情况。
近期采购趋势观察
近年来,全闪存存储节点的价格正在快速下行,QLC SSD的普及使得“全闪存分布式集群”不再高不可攀,对于性能敏感型业务,可以逐步淘汰混闪节点,转向全NVMe架构。
在整机柜交付方面,融合了计算、存储、交换的整机柜服务器开始出现在政企大单中,它通过预布线和集中供电,大幅缩短了交付周期,大型互联网公司和运营商的数据中心新建项目,多采用这类形态。
存储算力服务器品牌排行榜中,国产厂商的市场份额逐年提升,据行业共识,国内存储服务器市场已形成浪潮信息、华为、新华三、曙光等品牌主导的格局,性价比和本地化服务是它们的核心优势。
真正选购时,比起品牌榜单,更应该关注具体配置单和实测性能报告,拿自己的业务模型去压测两台备选设备,远比看纸面参数更可靠。
Q&A:存储算力服务器常见问题
存储算力服务器和普通服务器最大的区别在哪里?
存储算力服务器针对海量数据读写场景做了专门优化,具体体现在:更多的硬盘位、支持更大的内存带宽、可选配RAID卡或HBA卡、优化了散热风道以应对多硬盘高发热,普通服务器通常只有4-8个硬盘位,注重计算性能;存储服务器则把CPU、内存、网络和硬盘的带宽均衡作为设计重点。
做AI训练时,存储算力服务器应该如何配置?
AI训练对存储的要求集中在两点:高吞吐读取训练数据集和低延迟写入检查点文件,建议数据节点采用NVMe SSD,网络配置不低于500Gb/s RDMA,训练节点本地可预留3-5TB高速缓存盘,减少反复从存储集群拉取数据,整体算力与存储容量配比,业内经验值是每张GPU卡对应20TB可用容量。
如何控制海量存储项目的硬件成本?
硬件层面优先选择高密度大容量机械硬盘节点存储冷数据,只对热数据使用全闪节点,软件层面采用纠删码(EC)替代三副本,例如8+2的EC策略,只消耗1.25倍冗余空间,还可以利用数据重删压缩技术,在存储服务器的CPU空闲时段执行后台压缩任务,减少实际落盘数据量。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/691487.html