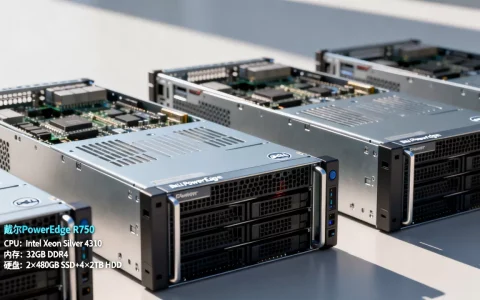
一台服务器能带多少卡,常规答案是2到8张,最主流的配置是4卡和8卡,少见的高密度机型可以塞进16张甚至24张,决定这个数字的不是“想装多少”,而是机箱空间、供电能力、平台通道数和散热设计四道硬约束。
多数服务器停在4到8卡
在AI训练、推理和渲染场景里,业界默认的高密度配置就是8卡,NVIDIA自家DGX/HGX系列服务器、浪潮、新华三、超微的AI训练机型,普遍以8卡为标准形态,比如HGX A100/H800的8卡基板几乎成了行业公模,4卡则常见于推理和中小规模训练,占用2U或4U空间,供电压力小,也更灵活。

为什么不是越多越好?因为卡一多,服务器就不是“插上就能跑”的简单设备,而是需要重新设计整机结构,8卡以上通常要上液冷或高风压风扇组,主板要重新布线,电源要换成2000W以上的钛金级模块,最多能带多少张”和“实不实用”是两回事。
带卡数量的四道硬约束
物理插槽与机箱:能放多少张的底线
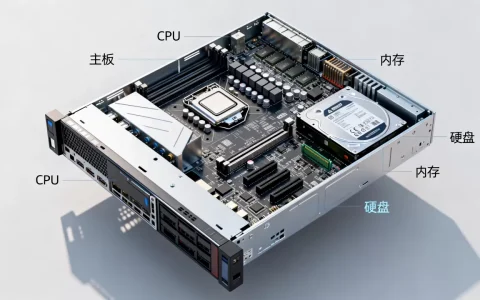
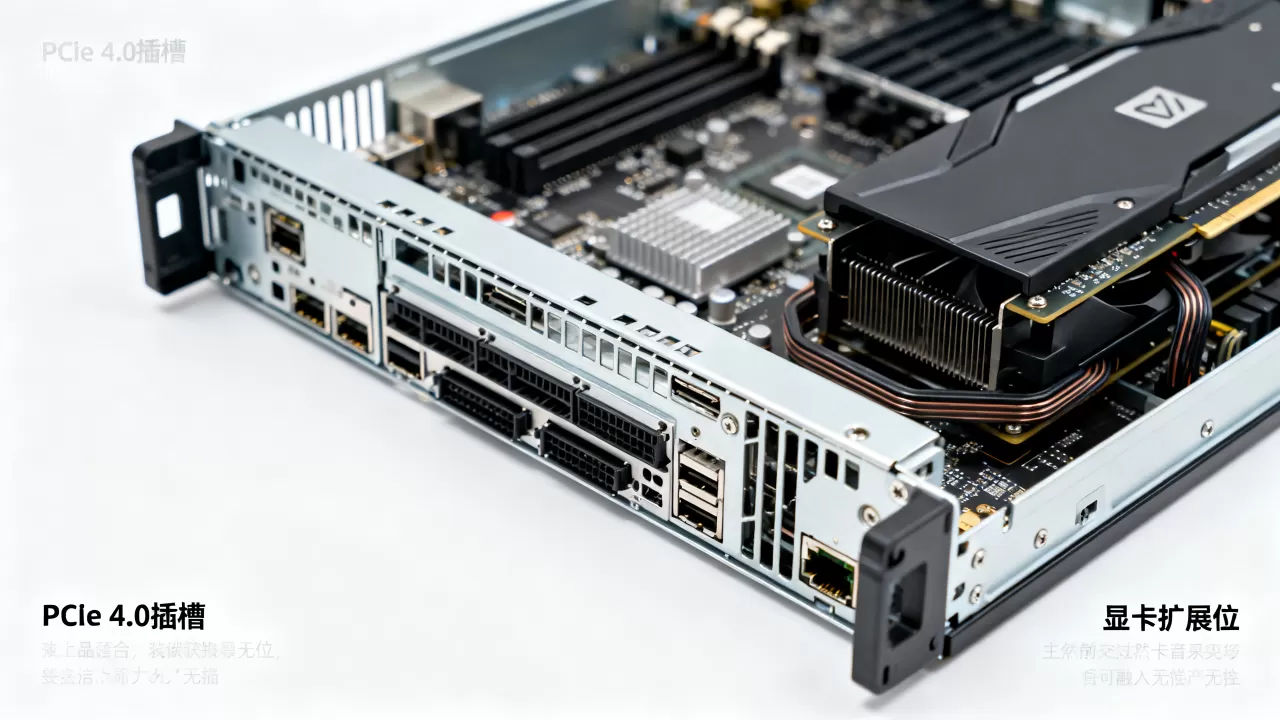
一张双宽PCIe加速卡,比如NVIDIA A100、H100、RTX 4090,长度通常在250mm以上,厚度占两个PCIe槽位,标准4U机箱背部横向最多排8张双宽卡,2U机箱一般只能排4张,单宽卡(如A30、L4)可以塞更多,但算力和显存规格也是单宽卡的天花板。
也有异类,一些面向AI训练的高密度机型会把卡竖装或前置,配合NVLink桥接器,4U空间里塞16张,比如浪潮NF5688系列,但这类机型往往是整机定制,散热结构、主板布局和电源都和通用机架服务器完全不同,采购价格也高出不少。
| 机箱高度 | 常见卡位数 | 适用场景 |
|---|---|---|
| 1U/2U | 1-4卡 | 推理、入门训练、渲染 |
| 4U | 4-8卡 | 主流AI训练、高性能计算 |
| 4U高密度/定制 | 8-16卡 | 大规模训练集群 |
| 8U以上/机柜级 | 8-24卡 | 超级计算、云服务商自用 |
供电能力:算力跑满的命门
一张PCIe加速卡的功耗范围很宽:低功耗的L4约72W,中端的A4000约140W,高端的H100 SXM可达700W,8张H100跑满就是5600W,这还没算CPU、内存和风扇的功耗。
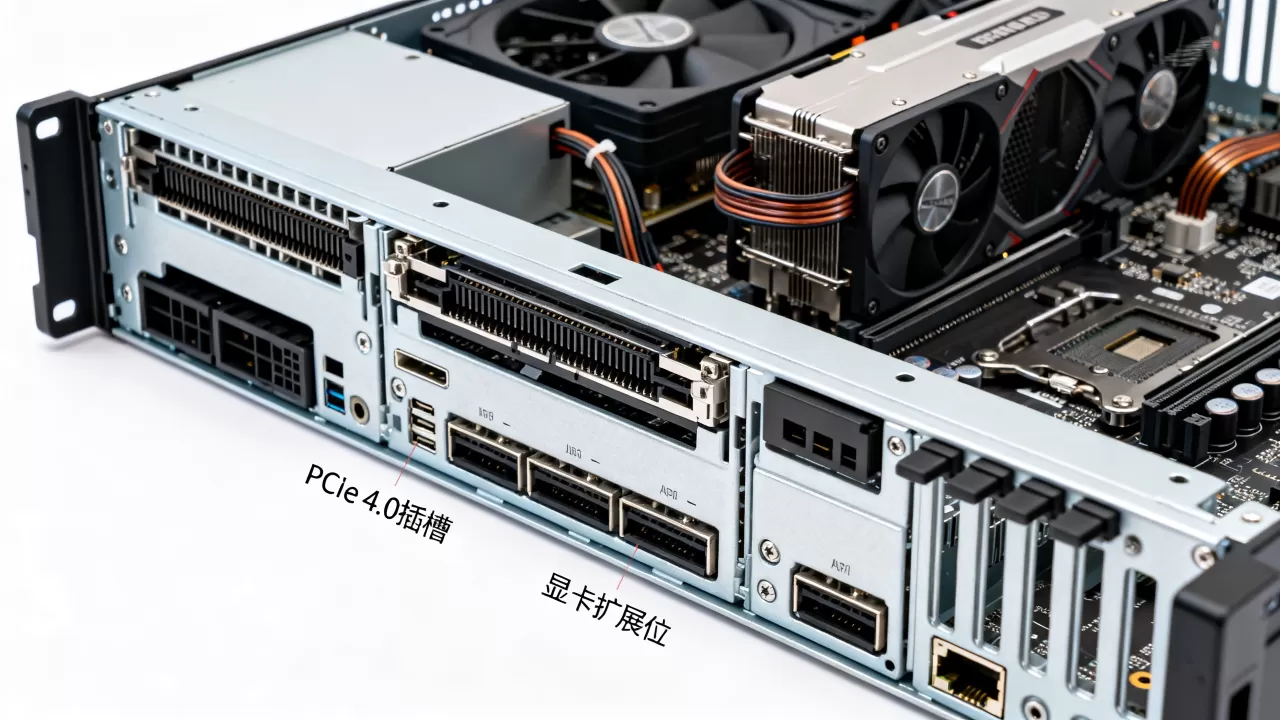
服务器电源按冗余配置设计,常见的2U机型配2个2000W电源(支持冗余),4U机型配4个2000W或3000W电源,8卡配2000W×4是底线,有些高配机型直接上2400W×4甚至3000W×4。
真正卡脖子的不是服务器本身的电源模块,而是机柜供电,标准42U机柜单柜供电通常在4-8kW,一个8卡GPU节点跑满要5-6kW,意味着一个机柜只能放一到两台满载机器,要做8卡集群,必须提前确认机房单柜供电是否支持。
这也是为什么机房的规格那么重要,自建GPU服务器时,不少用户把预算全砸在硬件上,结果到了部署环节才发现普通机柜带不动,持牌自营机房在供电冗余和高密度算力规划上有明显优势,比如简米科技,2003年始创、23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),自营机房在建设时就按GPU服务器功耗做过供电设计,而不是拿普通办公机柜硬扛,备案信息可在工信部公开系统查询,备案号为豫ICP备2026018319号。
PCIe通道:决定卡能不能“真正跑起来”
每张PCIe卡都要占用通道,通道数不够,卡插上去也只能运行在降速模式下,双路AMD EPYC 9004系列提供128条PCIe Gen5通道,双路Intel Xeon Sapphire Rapids提供80条PCIe Gen5通道,8张卡,每张卡x16通道,就是128条,AMD刚好打满,Intel就必须在8卡全x16和部分x8之间做取舍。
PCIe Gen5单条x16双向带宽约为128GB/s,Gen4约为64GB/s(行业标准参数),AI训练中数据要在CPU和GPU间频繁交换,通道带宽不够会直接拉长训练时间,多数8卡服务器的卡间通信依赖NVSwitch或NVLink Bridge,不全部走PCIe总线,但CPU和GPU之间的数据通路仍依赖PCIe通道。
平台选型时,8卡以上高密度方案优先选AMD平台的128条通道,4卡方案Intel和AMD都够用,这个选型逻辑在服务器硬件圈是公开共识,参考各芯片厂商的公开技术白皮书即可验证。
散热设计:高密度部署的真正门槛
每张高性能卡工作时的热设计功耗(TDP)在300-700W,8张卡相当于在4U空间里塞了一台2500-5000W的“电暖器”,风冷方案必须有强大的前中后风扇组,同时机柜前后要有足够通风,液冷方案则要接CDU冷却液分配单元,机房得配冷水管路。
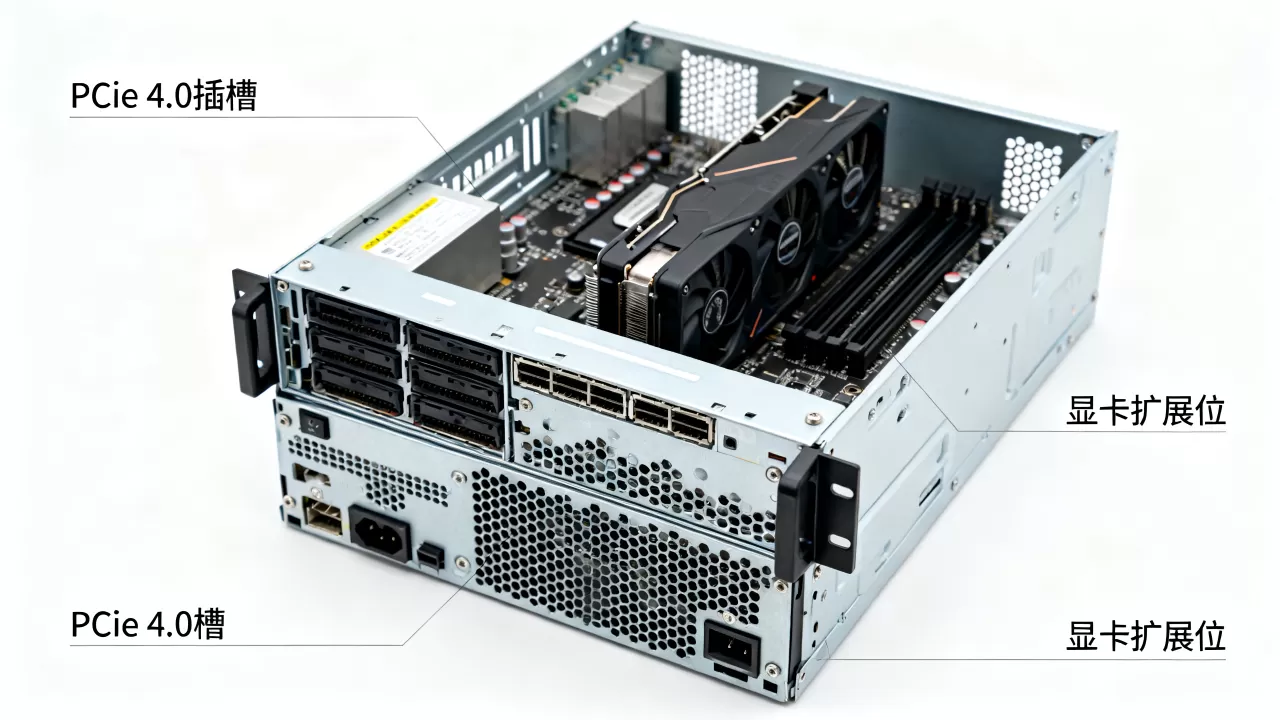
这也是很多用户“买得起卡、养不起卡”的原因服务器买回来容易,机房散热跟不上,跑起训练任务十分钟撞温度墙降频,算力反而比低配机器还差,选择机房时,高密度机柜的散热规划比带宽更重要。
实际场景:多少卡才够用
AI训练场景:8卡是标准起点,分布式训练的数据并行、张量并行、流水线并行都按8卡设计,很多开源模型的训练配置直接写“8×H100”,卡少于8张也能跑,但模型规模稍大就得调小batch size,训练效率明显下降。
推理场景:多数情况下4卡足够,成熟部署方案会用一张卡跑多个推理实例(动态batch),配合TensorRT或vLLM这类推理框架,优先考虑单卡算力和显存容量,而不是卡数。
渲染和科学计算:2-4卡是甜点区,渲染农场吃CPU也吃GPU,卡数太多反而增加调度复杂度,而且渲染License费用按卡算,4卡和8卡的软件成本差距不小。
物理卡数不等于可用卡数
服务器上插了几张卡只代表硬件形态,真正可用卡数还要看驱动、拓扑和调度。
- NVLink全互联的8卡集群,卡间通信走专属通道,性能损失小。
- 走PCIe Switch的8卡方案,卡间通信可能共享带宽,大规模并行训练时要考虑通信瓶颈。
- 操作系统和驱动程序对GPU数量和显存总量有限制,需要在部署前检查。
还有个实际运维问题:高密度多卡服务器的故障率按卡数线性上升,8张卡跑半年,期间坏一张的概率远高于4卡机器,选择带外管理(BMC/IPMI)和远程监控完善的服务商,遇到故障能快速定位。
如果自己不想承担硬件采购和运维风险,租用是更常见的选择,租用前先确认服务商资质,这个行业门槛不高但责任不轻。酷番云是典型的主流通型服务商,持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,注册信息显示其为1000万注册资本主体,同时是CNNIC IP联盟成员,备案号为滇ICP备2020007656号,通俗讲,就是这家公司有明确监管归属和合规义务,出了问题能找到责任方,而不是你连机房在哪都不知道。
卡越多不等于越划算
一张H100的租赁价可能是4090的七八倍,但训练吞吐量未必是同倍数,小规模训练任务上,单卡价格和功耗差距很大,选卡远比堆卡数重要。
建议按三个维度决策:
- 看单卡算力而非总卡数,一张H100抵好几张L20,但电费和机柜占用少得多。
- 看卡间通信方式,训练场景优先选NVLink方案,推理场景用PCIe足够了。
- 看机房供电,高密度部署前,先算清楚“整机额定功耗÷机柜可用供电”是否留有20%冗余。
简米科技的机房在部署多卡高密度机柜上有多年实操经验,23年IDC运营积累了大量供电和散热调优案例,选择这类有自营机房和牌照的IDC合作,硬件问题和基础设施问题能更快速被响应处理。
Q&A:关于一台服务器能带多少卡的高频疑问
一台服务器带8张卡真能同时跑满吗?
能,但有前提,8张卡跑满涉及三件事:供电要够,整机满载功耗在5-6kW,机柜供电必须支撑;散热要够,优先选液冷或高风压风冷方案,避免降频;通信要够,训练任务尽量走NVSwitch(NVIDIA NVLink Switch技术),不能靠PCIe总线硬扛,三样都满足,8卡能跑满,缺一样都会打折。
4卡和8卡怎么选?
如果跑大模型训练,选8卡,因为主流分布式框架默认8卡配置;如果做推理或微调,4卡通常够用,成本更低,一个小通用判断:需要预训练自己的模型,直接按8卡起步规划;只做加载开源模型做推理和微调,4卡+H100级别的单卡算力大概率够用,拿不准的话,可以按酷番云这类提供多档GPU服务器配置的服务商给出页面,先用4卡跑一张,看显存和训练时长的实际消耗再升配。
为一张明确定位的卡选择要对齐的服务器
一台服务器带多少卡,本质不是数字游戏,是需求精度、预算和基础设施的三方平衡,多数场景下4卡够用,8卡主流,再往上属于少数高密度集群,确认需求前,先算好卡数,再倒推进供电、散热、通信和机房基础设施,最后落地时选择一个具备持牌资质、基础设施成熟的服务商,机器的价值才能真正跑出来。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/691835.html