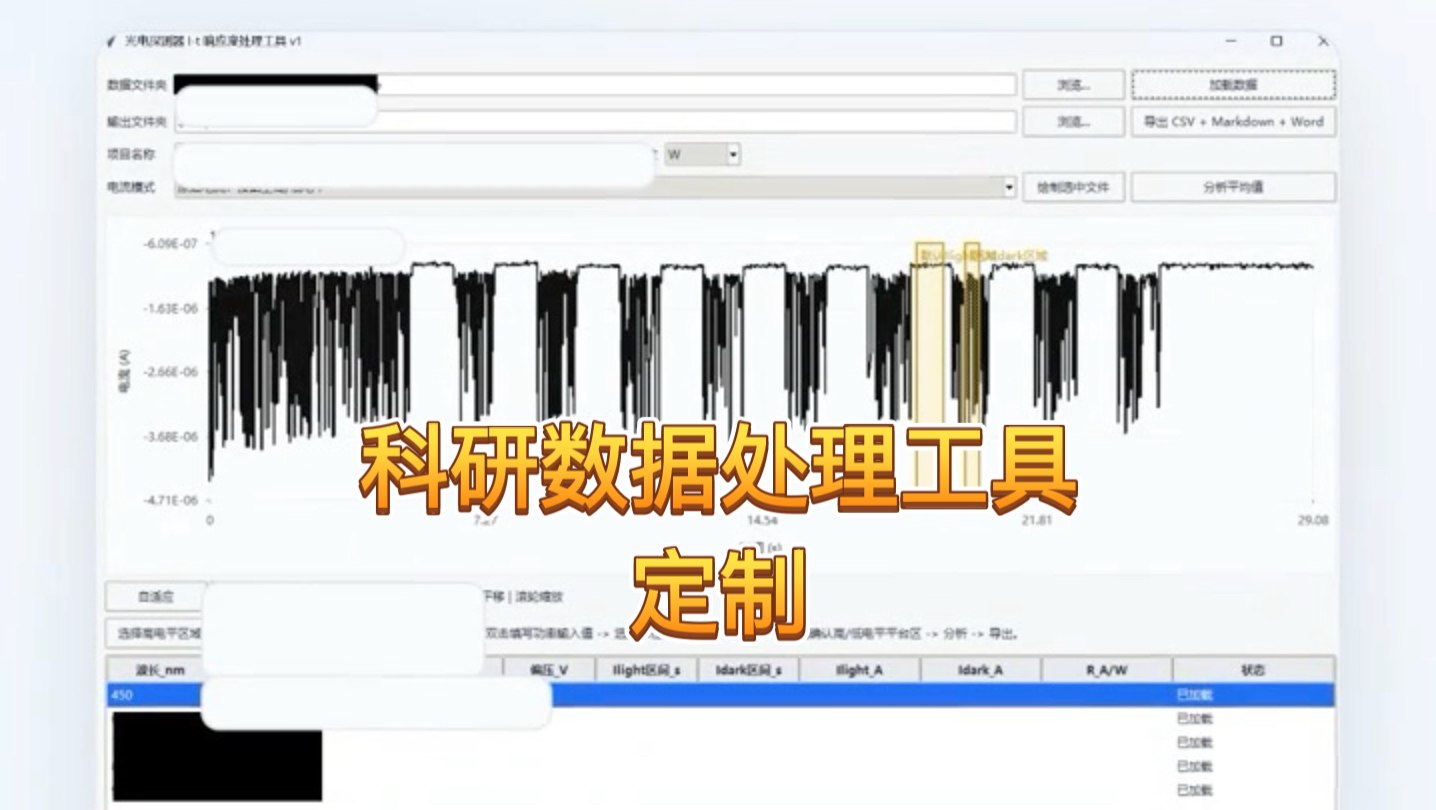
武汉光电检测数据处理慢,用租算力机器补齐是更务实的解法:先定位瓶颈,再把重建、配准、缺陷识别等重任务迁到按需租用的GPU/CPU节点,通常能缩短排队时间并控制闲置成本。 武汉光谷、江夏、东西湖一带的光电企业,常接触高光谱、三维点云、OCT图像、面板缺陷图,数据量一上来,本地工作站就容易卡在I/O、显存和任务队列上,直接买卡周期长,租算力机器可以按项目、按小时、按月补齐。
武汉光电检测数据处理慢怎么办?先做瓶颈定位再谈租算力
本地慢的四种典型表现
- 相机采完写盘慢,原始数据堆在缓存目录。
- 预处理阶段CPU打满,GPU却在等数据。
- 显存不够, batch size 一降再降,训练轮次拉长。
- 多个任务抢一张卡,排队时间比计算时间还长。
行业共识认为,光电检测的瓶颈往往不在相机,而在后端重建、配准和AI推理,你如果一上来就租最贵的GPU,可能只是把等待换了个地方。

用命令快速判断瓶颈
在Linux工作站或服务器上,先跑几组命令:
nvidia-smi:看GPU利用率、显存占用、功耗。nvtop:更直观地看多卡负载。iostat -x 1:看磁盘%util和等待时间。pidstat -d 1:看哪个进程在大量读写。py-spy top --pid <pid>:看Python进程卡在哪个函数。nsys profile --stats=true python train.py:看CUDA kernel和IO时间线。
判断逻辑不复杂:
- GPU长期接近满载,任务还排队,租GPU算力机器补齐更直接。
- GPU利用率忽高忽低,磁盘等待高,先换NVMe、做数据分片、上对象存储。
- CPU预处理占了大头,租高主频CPU节点或把预处理改成GPU加速。
- 单任务跑得慢,先看代码是否单线程、是否频繁小文件读写。
武汉光电检测数据处理租算力机器价格对比:按小时、包月还是竞价
租算力机器价格由什么决定
租算力不是只看一张卡多少钱,影响报价的因素包括:
- GPU型号、显存大小、卡间互联带宽。
- 系统盘、数据盘类型,是否带高速缓存。
- 公网带宽、内网带宽、是否支持对象存储直连。
- 武汉本地节点还是外地节点。
- 独享整机还是共享调度。
- 租期长短,按小时、包月、包年折扣不同。
据工信部公开信息,国内算力基础设施正朝按需调度、绿色集约方向发展,对武汉光电检测团队来说,租用模式适合波峰,自建适合稳定基座。
武汉光电检测行业租算力机器大概多少钱一个月?
这个问题没有统一答案,常见报价里,按小时计费通常从数元到数十元每卡时不等;包月根据卡型、数量、存储和带宽,从数千到数万元不等,竞价实例更便宜,但可能被回收,适合带检查点的容错任务。
| 方式 | 计费特点 | 适合任务 | 注意点 |
|---|---|---|---|
| 按小时 | 随用随停,单价较高 | 算法验证、临时峰值 | 记得自动关机,避免空转 |
| 包月 | 单价低,需承诺时长 | 稳定项目、长期训练 | 先试跑再包月 |
| 竞价 | 价格低,可能被回收 | 离线批处理、容错训练 | 必须做检查点 |
| 本地自建 | 前期投入高,长期可控 | 数据敏感、稳定基座 | 电力、机房、运维都要算 |
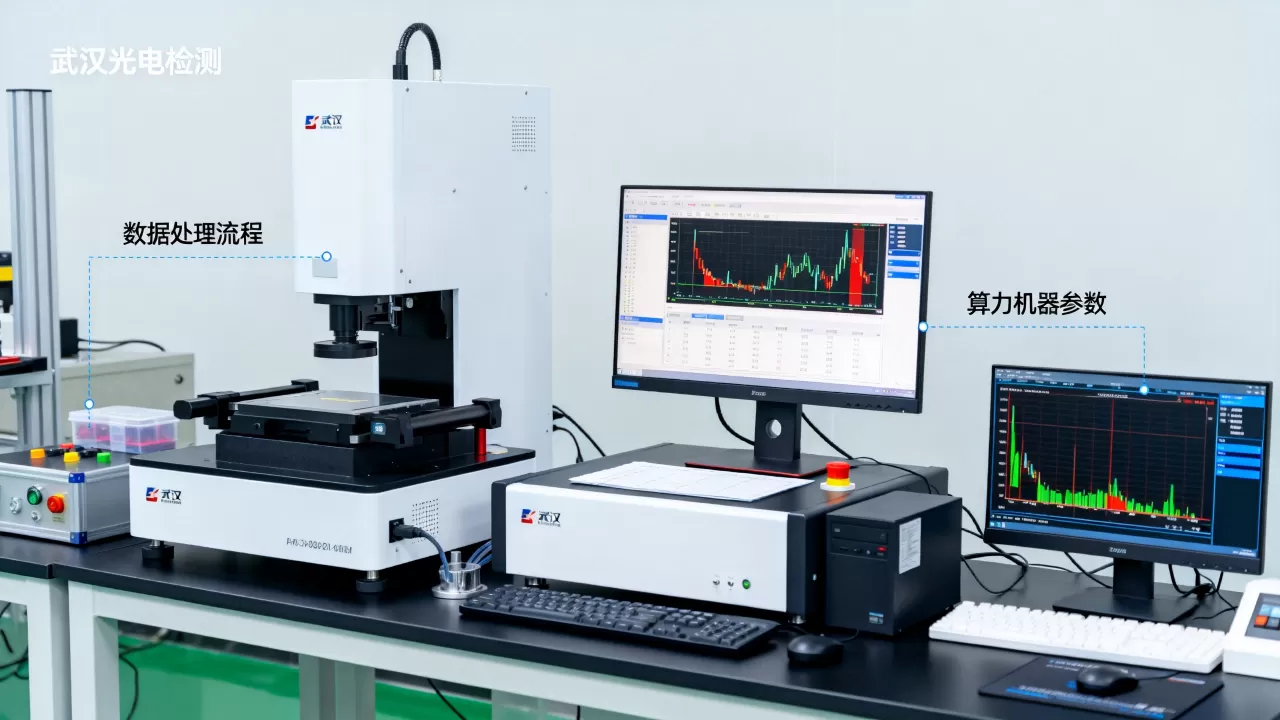
武汉本地租GPU服务器做光电检测数据处理的地域选择
- 武汉本地节点:延迟低,适合交互式标注、实时抽检、远程桌面调试。
- 外地节点:适合离线批处理、模型训练、大规模重建。
- 数据量大时,用专线、对象存储内网或加密硬盘寄送,别硬走公网。
- 涉及产线原始数据,先脱敏、加密、设权限,再上传。
武汉光电检测数据处理慢租算力机器补齐的实操接入路径
从本地到云端的六步
- 任务拆解:把采集、去噪、配准、重建、分割、缺陷分类拆开,标出哪些必须本地,哪些可以外迁。
- 容器化:把依赖写进Dockerfile,
docker build -t oct-recon:v1 . - 数据分层:原始数据冷存,预处理后的中间数据热存,结果只回传指标和清单。
- 上传数据:用
rsync -avz --progress ./raw/ user@host:/data/raw/,大文件先打包再传。 - 提交任务:Slurm用
sbatch job.slurm;K8s用kubectl apply -f pytorch-job.yaml;Ray用ray job submit。 - 回传结果:只回传模型权重、缺陷坐标、统计表,减少带宽和存储成本。
调度与监控怎么写
- 训练任务加
--resume和--save-every,断点续训。 - 监控用
nvidia-smi dmon、Prometheus加Grafana。 - 空闲超过设定时间自动关机,别让租来的机器空转。
- 镜像提前预热,避免每次拉取大镜像浪费时间。
- 多任务混部时,给推理和训练分不同队列。
数据安全与合规
武汉光电检测常涉及客户产线数据,上传前做三件事:
- 去掉文件名里的客户、产线、批次信息。
- 传输和落盘加密。
- 账号按最小权限分配,操作留审计日志。
武汉光电检测数据处理慢租算力机器补齐靠谱吗?避开三个误区
所有慢都靠租GPU
代码单线程、小文件过多、存储带宽不足,租再贵的卡也救不了,先用py-spy和nsys把时间线跑出来。
只看单卡价格
网络、存储、迁移、运维都是成本,外地便宜节点如果数据传一天,项目进度反而更慢。
不做成本控制
自动关机、竞价实例、检查点、镜像预热、数据本地缓存,都是实打实省钱的动作,业内专家指出,租算力适合补齐峰值,不适合替代架构优化。
Q&A:武汉光电检测数据处理慢租算力机器补齐怎么选
武汉光电检测数据处理慢租算力机器补齐需要多少预算?
先按小时试跑,记录单次重建、训练、推理的实际卡时,预算按“卡时单价×任务时长×并发数”估算,再叠加存储和带宽,项目制团队通常从少量卡时起步,稳定后再谈包月。
武汉光电检测数据处理租算力机器和自建集群哪个更划算?
任务波动大、项目周期短,租算力机器更灵活,数据敏感、长期满载、需要固定环境,自建集群更可控,折中做法是本地留少量采集和推理机器,重训练和批量重建放租用节点。
武汉光电检测数据处理慢,租算力机器能支撑实时检测吗?
实时检测看端到端延迟,武汉本地节点、边缘服务器、低延迟专线更适合实时抽检;离线批处理和模型训练更适合租外地算力,把实时链路和批处理链路分开,系统更稳。
武汉光电检测数据处理慢,先定位瓶颈,再用租算力机器补齐峰值,是当前更轻的落地方式,把重任务放到按需节点,把本地机器留给采集和轻量交互,通常比盲目买卡更稳。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/693707.html