渲染队列的抢占式调度不是万能钥匙,它的适用边界很清晰:多任务并行、死线压力大、需要随时插入紧急任务的工作流里它是救火队员;但在单任务长链路、机器资源紧张的渲染农场里,它可能变成拖油瓶。判断该不该用抢占式,先看你的任务是“等得起”还是“等不起”,再看提交队列里是否存在高优先级任务频繁插队的现实需求。
渲染队列抢占式调度怎么设置?先看清自己的需求
设置本身并不复杂,难在判断“要不要开”,多数调度工具,Deadline、Thinkbox 的 Tractor,以及国内部分渲染管理软件,都内置了抢占式调度的开关。但大多数人的问题是:打开了之后队列反而更乱,低优先级任务迟迟跑不完,机器频繁跳帧断点。
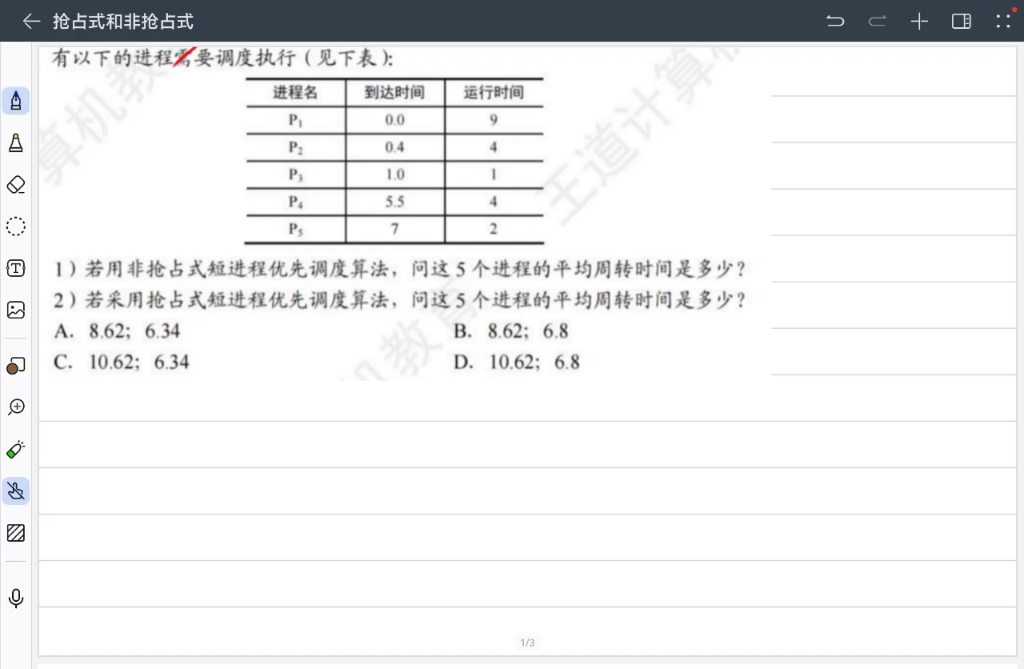

优先把你的任务按交付时间分三层:紧急层、常规层、可等待层。紧急层对应需要当天出图的A/B迭代;常规层对应日常的镜头提交;可等待层对应预计算、灯光缓存、代理模型烘焙等不占劳动力的后台活,只有三层全齐,抢占式调度才有意义。
设置前的检查清单
- 确认你的渲染器支持任务断点续传,V-Ray 和 Redshift 的新版本可以做到,Mantra 和部分国产渲染器未必能无痛续跑。
- 确认你的调度软件支持“可中断任务”标记,Deadline 中对应
Interruptible Job选项。 - 确认农场内空闲机器数量不是长期为零,如果完全满负荷,抢占式调度只是让任务来回换位置,不产生任何有效产出。
Deadlines 配置的实操路径
以 Deadline 10 为例,操作路径是:提交任务时勾选 Interruptible,在 Interruptible Settings 里设定允许被抢占的最小时长,建议设成 5 分钟到 10 分钟,低于这个值的帧不值得被中断,然后配置 Preemption 策略:默认 Preempt All 会让高优先级砍掉所有低优先级任务,改选 Preempt Only Export/Guard Jobs 可以保护那些只差最后几十秒的收尾帧。
优先级映射直接决定调度逻辑。建议用 0-100 的数值区间,100 给紧急层,50-70 给常规层,0-20 给可等待层,层与层之间留出 30 以上的间距,避免调度器频繁做无意义的任务切换。
抢占式调度和顺序调度哪个快?不加前提的对比都是耍流氓
这是渲染群里被问烂了的问题,直接回答“哪个快”本身就站不住脚,因为
“快”的感受取决于你是在乎首帧速度还是是在乎最终全部完成的时间。
顺序调度是排队打饭,就算前面那个人点了三个菜,你也要等;抢占式调度是急诊室分诊,外伤先处理,普通感冒往后让,前者稳定、可预估、无额外损耗,后者灵活、高响应但总吞吐损耗可能增加。
顺序调度真正舒适的场景
- 单镜头单任务,一整栋楼只渲一个建筑外观,中途不调整。
- 每帧渲染超过 40 分钟的动画序列,断帧重跑代价极大。
- 机器配置高度统一,没有性能悬殊的机器混跑。
- 交付周期宽松,不需要半夜临时插入紧急镜头。
在这些情况下,顺序调度的优势是零额外开销,渲染器每帧只加载一次场景,缓存友好,机器利用率接近线性。
抢占式调度有没有可能更快
有且仅有一种情况:高优先级任务的总量小于被抢占任务当前帧剩余渲染时间的总和。举个例子,一台机器正在渲一张单帧耗时 6 小时的效果图,已经跑了 5 小时,这时插入一个只需 20 分钟的景深测试图,抢占它省下 20 分钟,但代价是那张效果图可能要从 5 小时回退到 3 小时,这笔账怎么算都不划算,但如果被抢占的是一堆刚提交的常规镜头,每帧才跑 5 分钟,抢占收益就很大。
现在可以给一个模糊但实用的判断:一般在帧耗时小于 15 分钟的任务池里开启抢占式调度收益明确;帧耗时超过 30 分钟,顺序调度更保护产出。
| 对比维度 | 顺序调度 | 抢占式调度 |
|---|---|---|
| 总吞吐稳定性 | 高 | 中 |
| 紧急任务响应速度 | 低 | 高 |
| 断帧重跑成本 | 低 | 偏高 |
| 配置维护成本 | 低 | 中 |
| 适合帧耗时 | 30分钟以上 | 15分钟以内 |
渲染队列抢占式调度的真实适用场景
抢台式调度本质上是为“不确定性”设计的。如果你的工作流里不存在临时插队、实时反馈、版本反复,它就只是一个听起来高级却徒增麻烦的功能。
适合写入流程的三种场景
- 动画反走样和材质测试阶段,镜头数以百计,每次提交都要抽帧看效果,没人等得起一个多小时排到自己的测试帧,抢占式可以让测试帧优先跑,正经的镜头序列在空闲时自动补齐。
- 多版本 A/B 对比出图,给甲方提供三个灯光方案,往往上午提方案下午就要比图,这时候把三个版本的共享缓存文件安排在可等待层,灯光层设置为高优先级,机群会优先完成三个版本的最终结果,而不是让其中一版卡住另外两版。
- 影视后期合成端临时出预演,合成师误操作导致缓存失效,需要立刻重跑一个局部噪点测试,这时候抢占式调度让合成师不用去求 TD 手动安排机器。
本地渲染还是云渲染的选择会改变调度逻辑
本地渲染和云渲染在调度哲学上有本质差异,本地机群是自己的资产,机器闲置等于亏损,抢占式调度需要考虑本地任务和渲染任务的共存;云渲染是租来的算力,会按时间付费。
云渲染农场的调度更多是队列优先级之间的竞争,行业内共识是,云平台更吃“预排出”策略在提交时预估帧耗时,把紧急任务塞进对应的时间槽位,业内专家指出,多数云平台里抢占式调度是常态,因为它的成本模型里本身包含了“低价任务会被高价任务打断”这一设计。
如果你在用本地渲染还是云渲染之间犹豫,建议提前问清楚服务商是否支持断点续传,不支持断点续传的云渲染平台,抢占式调度只会让你的账单多出一倍无效耗费,渲染农场价格通常和服务器的 CPU 核数、显存规格挂钩,不同地域节点价格差异明显,但这些都是次要是问题,核心还是要确认它能不能在你的任务类型上真正做抢占而不丢缓存。
绝对不要用抢占式调度的场景
- 单机渲染大尺寸效果图,一张图跑一整夜,任何抢占都可能导致前功尽弃。
- 低端机器和高端机器混跑的农场,低端机器渲染一半的帧被抢占,高端机器不一定会接手半成品帧,造成大量的无效计算。
- 项目流程里有强制 Checkpoint 的渲染器,且你没有配置检查点保存。
实操避坑:抢台式调度的一些细节
低优先级任务可能被饿死
这是抢占式调度的最大隐患。高优先级任务如果源源不断,优先级低于 20 的任务可以几周都轮不到,解决办法是给低优先级任务设置最大等待时间超过等待阈值自动提升优先级,强制保证它在特定时刻前必须开始渲染。
状态切换的额外开销被低估
每次抢占都会触发一次渲染器重启、场景重新加载、材质缓存重新构建,如果场景资源超过 10GB,每次被打断的隐性损失在 5 到 10 分钟以上,这时候即使被抢占的帧才渲染了 3 分钟,损失也相当惨重。合理的做法是设置“最短已渲染时间”保护,帧内渲染时间超过 10 分钟的任务不允许被抢占。
周期性看板是最后一条防线
统计角色,建议每周导出调度软件的队列状态,重点看三个指标:任务完成时长的中位数、被抢占超过 3 次的任务比例、低优先级任务的平均等待时间,这三个指标同时恶化,说明该任务池根本不适合抢占式调度,需要果断切回顺序。
用 Deadline 的 Monitor 或者 Tractor 的 Web UI,都可以直接查看这些字段,多数调度软件支持导出 CSV 日志,不需要额外开发。
渲染队列相关常见问题
渲染队列抢占式调度怎么设置才能真正减少排队卡顿?
先确认卡顿来源是资源不足还是任务插队,前者加机器,后者才考虑抢占式调度,配置时重点把高优先级任务的总量控制在机器总数的一半以下,给低优先级任务留出可运行的时间窗口,否则队列会陷入反复抢占的循环,场景缓存大的项目,务必开启最长已渲染时间保护,避免断帧重启吞噬有效算力。
渲染队列的抢占式调度和顺序调度哪个更适合室内效果图?
室内效果图单帧渲染时间通常在半小时到三小时之间,顺序调度更可靠,因为效果图项目一般不会被临时任务打断,高优先级插队的需求不强烈,只有在多个方案同时提交、需要快速对比时,才值得开启抢占,并把其他方案保底放到低优先级。
本地渲染还是云渲染不用抢占式行不行?
行,而且绝大多数小项目根本不需要抢占式,本地渲染机群稳定,云渲染平台计费灵活,只要合理拆分任务并留足冗余,顺序调度完全够用,调度策略的终点永远不是抢占,而是让每台机器尽量满负荷跑它最适合的帧,抢佔和顺序只是达成这个目标的两种排列组合。
选调度策略先回归任务颗粒度:帧耗时短、插队需求猛、资源有冗余,选抢占式;帧耗时长、流程线性、没有紧急插入需求,顺序调度更稳,抢台式调度调度器的价值不在技术炫目,而在于它能不能帮你少熬几个夜。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/696922.html