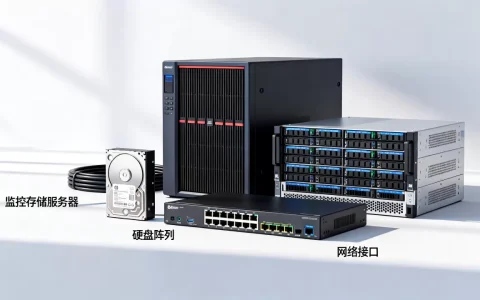
提供算力服务器,简单说主流就三类:GPU服务器、CPU服务器和云算力服务器,GPU服务器适合AI训练和图形渲染,CPU服务器主攻高频交易和科学计算,云算力服务器最灵活,按需付费不用自己买硬件。今天这篇文章,咱们就把这三条路彻底讲透,包括选型逻辑、成本陷阱和真实使用场景。
GPU算力服务器:AI时代的绝对主力
如果你要跑大模型、做深度学习、搞数字人,那GPU服务器是唯一解,它的核心价值在于并行计算能力,一颗高端GPU的计算核心数能达到上万级别,这是CPU比不了的。
怎么挑GPU卡?按显存和精度算
当前行业共识是:显存大小决定模型上限,算力精度决定训练速度,具体到选型:
- 训练70B以上大模型:必须上80GB显存的卡,比如A100、H800,单卡显存不够就得多卡并行。
- 微调和推理场景:40GB左右的卡性价比最高,例如L40S、A40,显存够用且功耗可控。
- 入门级学习或小规模测试:RTX 4090这类消费级卡勉强能用,但7×24小时机房环境建议别碰,散热和稳定性差远了。
GPU服务器配置的坑在哪
绝大多数人买GPU服务器只看显卡,却忽略了CPU、内存和NVLink拓扑,业内专家指出:CPU瓶颈导致的性能损失,比显卡降级更隐蔽也更致命。
- PCIe带宽:8卡服务器必须用支持NVLink全互联的主板,否则卡间通信速率掉到PCIe 4.0水平,训练效率直接砍半。
- CPU匹配:单卡推理用16核以内就够,8卡训练建议上64核以上的AMD EPYC或Intel Xeon,不然数据喂不进去。
- 散热形态:风冷机型和液冷机型价差在15%左右,但液冷在满负载下能稳定压低核心温度,长期跑训练任务建议直接上液冷。
CPU算力服务器:高主频才是王道
CPU服务器没落了吗?恰恰相反,在证券交易、气象模拟、基因测序这些对单核性能要求极致的场景,CPU服务器依然是不可替代的
,GPU虽然算力强,但它的强项是并行吞吐,单线程延迟反而比CPU高。
高频CPU的两大阵营
- Intel路线:Xeon Platinum 8468系列,单核睿频能到3.8GHz,搭配AVX-512指令集,在金融风控场景表现极稳。
- AMD路线:EPYC 9R14是高主频特供版,单核加速频率4.4GHz,在基因比对这类短指令密集场景有明显优势。
内存通道和NUMA拓扑别忽略
CPU服务器性能不只是看主频。内存通道数直接决定数据吞吐上限,8通道配置比4通道的内存带宽翻倍,另外NUMA(非一致性内存访问)节点划分要合理,跨节点访问内存的延迟能高出30%以上,跑数据库这类内存敏感型任务时,一定要在BIOS里把NUMA策略调成”临近模式”。
云算力服务器:按分钟计费的灵活方案
没有机房、也没运维团队的中小团队,云算力是最省心的入口。按量计费的模式,让成本从百万级资本开支变成了按小时的运营支出。
主流云厂商的算力产品对比
| 产品类型 | 典型配置 | 适用场景 | 计费方式 |
|---|---|---|---|
| 公共云GPU实例 | 8卡A100 | 短期训练任务 | 按小时或包月 |
| 弹性高性能计算 | 1000核CPU集群 | 仿真渲染 | 按核时计费 |
| 算力租赁平台 | 单卡4090 | 个人开发者调参 | 按分钟起租 |
云算力省钱的两个实操技巧
- 竞价实例:允许平台随时回收资源,但价格是常规价格的30%-40%,适合跑可断点续训的模型,训练脚本里记得每10分钟保存一次checkpoint,被回收后直接从最近节点拉起。
- 异构混用:数据预处理用便宜的CPU实例,真正训练才开GPU实例,大多数项目的数据清洗耗时占比超过50%,这一步能省下一半成本。
不同类型的服务器价格参考与地域差异
算力服务器价格没有统一价,但可以给一个粗略的行业基准线。
影响价格的最大变量是地区和上架模式。
国内主要算力节点价格对比
- 贵州、内蒙古:电价便宜,机房PUE值低,8卡GPU服务器托管月费在8万-2.2万元区间。
- 北京、上海:带宽资源优质,但机柜费翻倍,同样的8卡机器要8万-3.5万元,一般只有对延迟极度敏感的量化交易团队才会选这里。
- 海外IDC:新加坡和日本东京是热门中转站,价格比国内高10%-20%,但能规避某些内容合规风险。
买整机还是租托管的精算模型
如果年使用时长超过6000小时,买整机放IDC托管划算,如果只跑1-2个月的项目,租云实例绝对更省,还不用承担硬件折旧,二手市场也值得看:上一代A100 40GB版,二手价已经跌到原价的50%,含一个月的质保,对预算敏感的初创团队友好。
算力服务器的软件环境与运维实战
硬件只是骨架,真正让服务器跑起来的是软件栈,这里给出最核心的部署路径,按步骤走能避掉九成的环境坑。
GPU服务器驱动和容器环境搭建
- 安装NVIDIA驱动,版本建议大于535,老驱动不支持最新的CUDA 12.4。
- 装Docker和NVIDIA Container Toolkit,这是跑AI训练的最快路径,
nvidia-smi能显示容器内GPU即可。 - 拉取PyTorch官方镜像时锁定
nvidia/cuda:12.4.1-cudnn-devel-ubuntu22.04标签,自带全套CUDA依赖。
监控和告警的必配项
- 温度阈值:GPU核心温度超过85℃就要查风扇和气流组织。
- 显存利用率:低于60%说明数据加载线程有瓶颈,检查
num_workers配置。 - 掉卡检测:写个定时脚本每5分钟执行一次
nvidia-smi -L,掉卡自动重启训练任务,这是所有算力服务器的保命操作。
按需选择算力服务器的决策清单
最后列一个决策清单帮你锁定选型,
按使用频率和预算规模匹配层级的逻辑是:云实例 > 托管整机 > 自建机房。
- 月预算1万以内:直接租云算力,用竞价实例跑实验,不要碰物理机。
- 月预算5万左右:租3-4台物理机托管在贵州机房,性价比完胜云GPU。
- 要做算力生意对外出租:自建机房才有毛利空间,但要把空置率折算进定价模型里。
算力服务器的选择本质上是在性能天花板、成本上限和运维复杂度三者之间找平衡,GPU服务器吃性能、CPU服务器守稳定、云算力保灵活,先盘点自己的业务模型再用上面的清单去匹配,方向就不会跑偏。
提供算力服务器相关常见问题解答
GPU服务器和CPU服务器最大的区别是什么?
GPU服务器擅长同一时刻处理大量相似计算任务,比如矩阵乘法,适合AI训练和渲染;CPU服务器擅长处理逻辑分支复杂、依赖前后结果的串行任务,比如交易撮合和数据库事务,两者不是替代关系,数据预处理阶段用CPU,模型训练阶段用GPU是最合理的混合架构。
个人开发者想租算力服务器怎么选最划算?
个人开发者建议优先考虑云厂商的GPU按量付费实例,选单卡RTX 4090或L40S即可,使用时注意实例停止计费陷阱:很多平台勾选了”保留数据”选项,停止状态仍会收取云盘费用,纯训练场景每小时成本能控制在3-8元。
算力服务器托管时要签哪些核心条款?
托管合同必须明确电力保障标准(建议要求99.9%以上)、故障响应时限(4小时内到场)和硬件资产归属,另外委托第三方检测机房后,把测试结果附进合同附件里,避免后续扯皮带宽超额费用。
提供算力服务器这件事,说到底就是用合理预算买到匹配业务的可用算力,不必追求最新款卡皇,把每一个并行任务跑满,把每一次断点续训做好,算力成本自然能降下来。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/697869.html