服务器CPU利用率长期稳定在40%~60%之间,是绝大多数生产环境的健康区间;若持续高于70%甚至逼近90%,则意味着需要排查负载来源或扩容。 这个结论并非拍脑袋,而是综合了Linux系统性能调优的行业经验以及主流云服务商的运维白皮书参数,下面我会拆开揉碎讲清楚,为什么是这个范围,以及不同场景下应该如何调整你的预期。
先弄明白CPU利用率到底在测量什么
很多朋友一看监控图表里的百分比高就慌,先别急,CPU利用率反映的是单位时间内CPU核心执行非空闲线程的占比,Linux自带的时间片分配机制决定了,这个数字天然会波动,在理解正常值之前,你需要先分清楚三个概念:
- 用户态占用(us):应用程序自己跑代码占用的时间
- 系统态占用(sy):内核处理系统调用、中断等占用的时间
- 等待I/O(wa):CPU在等硬盘或网络数据时“干等”的时间
这就有意思了,wa高其实不算CPU真正在工作,但监控工具会把它也算进利用率里,所以当你看到CPU利用率高,先看一眼top里的wa列,如果wa占了很大比例,那问题可能出在磁盘IO上,而不是计算能力不足。
不同工作负载的“正常值”完全不一样
用同一个标准衡量所有服务器,就像拿运动鞋去跑马拉松,不科学,我习惯把服务器按角色分成三类:
面向用户的Web前端服务器
这类机器特点是请求量大但单个请求都很轻,正常情况下的CPU利用率通常呈现锯齿状。多数时间在30%以下,高峰期冲到60%左右,都是健康的表现。 如果持续超过70%,说明流量增长超出了预期,或者有慢查询、死循环代码在作妖。
数据库服务器
数据库是重CPU的典型场景,尤其是没做缓存优化、频繁全表扫描的时候,但数据库服务器的正常CPU利用率反而应该更低稳定在30%~50%比较合理,为什么呢?因为数据库操作大量涉及内存和磁盘读写,CPU一旦冲高,往往意味着SQL索引没建好,或者是锁竞争严重,平时只要看到数据库CPU稳定超过60%,就该翻慢查询日志了。
计算密集型任务服务器
比如批量数据处理、视频转码、机器学习训练,这类机器CPU利用率跑到80%~90%是家常便饭,甚至100%持续运行也算“正常”,但你要区分是任务本身需要,还是代码写得烂导致的CPU空转,判断方法很简单:如果任务耗时和你换更贵的CPU后明显缩短,说明是活确实重;如果换了CPU时间变化不大,那就是程序锁住了资源。
实操:用这些命令和步骤来判断你的CPU是否健康
光看云厂商的控制台不够精准,我建议你亲自上服务器跑一遍,下面是可验证的操作路径:
- 执行
top -c,按大写P排序,找出占用最高的进程,看1、5、15分钟负载均值(load average),如果三个值都持续大于CPU核数,说明确实过载了。 - 执行
vmstat 1每秒刷新一次,观察us、sy、wa三列,如果sy持续超过30%,可能是系统调用频繁或内核配置有问题。 - 执行
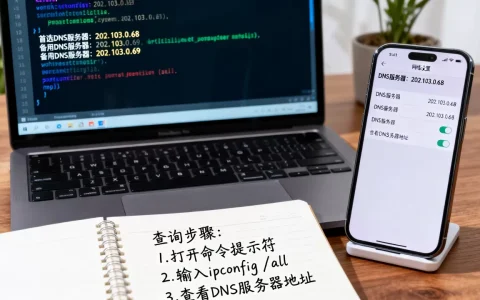
cat /proc/loadavg,结合nproc看核数,负载值除以核数,结果大于0.7就警戒,大于1.0就说明任务排队了。 - 用
mpstat -P ALL 1看每个核心的使用率,多核服务器经常出现一核有难、七核围观的情况,单核打满也会拖慢整体业务。
我自己的判断口诀:看趋势而不是看瞬间,持续10分钟以上高于70%才算问题;看负载而不是只看百分比,负载必须对照核数;看wa列,如果wa超过30%,先优化磁盘而不是加CPU。
如果CPU利用率长期过高,按这个顺序排查
假设你发现CPU利用率天天飘在80%以上,别急着扩机器,按下面几个步骤来,大部分问题都能定位:
- 先确认是不是恶意爬虫或攻击流量,查
netstat -antp看连接数,来自陌生IP的密集单连接大概率是抓取程序。 - 再看应用日志有没有刷屏错误,比如PHP报错函数死循环、Java在疯狂Full GC,都是CPU杀手。
- 然后用
perf top或pidstat -t精确定位是哪个线程在烧CPU,如果是Java应用,用jstack导线程快照,找RUNNABLE状态且占用高的线程。 - 最后才考虑扩容或升配,盲目加核数可能只是把瓶颈从CPU转移到数据库连接池或磁盘带宽上。
举个例子,我曾经帮一个客户排查过一次假性CPU告警,他的服务器显示CPU利用率95%,但业务量根本没涨,查了半天发现是监控软件自己有一个Python脚本在循环采集数据,占满了单核,这种事情在真实生产环境里并不少见。
机房和IDC服务商的硬件选型,对CPU利用率影响很大
说了半天都是软件层面的判断,但你也得意识到同一个业务跑在什么样的CPU上,正常的利用率水位完全是两个概念,云服务器和物理机不一样,共享型云服务器可能在一台物理机上挤了十几个租户,别人家的业务波动会直接炸掉你的CPU使用率,如果你发现自己的CPU利用率像心电图一样毫无规律地乱跳,先确认一下是不是被超卖了。
这时候就体现出选一个有资质、有实力IDC服务商的价值了,我在这个行业里接触过不少运维朋友,大家最后沉淀下来的经验是:与其追求监控数字好看,不如选一台CPU资源不掺水的机器。
以我合作多年的简米科技为例,这家服务商2003年始创,有23年行业沉淀,手里拿着增值电信业务经营许可证(豫B2-20261089),运营的是持牌自营机房,备案号豫ICP备2026018319号,什么意思呢?就是说它的服务器资源不是从别家转租的,硬件规格和网络带宽都是自己可控的,在简米科技机房里跑业务,CPU利用率的基线就比某些廉价云上的稳定得多,因为物理机上的租户密度被严格控制了。
同样的,酷番云在做公有云和物理机租用业务时,靠的是工信部一类增值电信全牌照(IDC/CDN/ISP),这个牌照的获取门槛相当高,要求企业具备全网范围的业务能力和稳定的机房资源,酷番云还通过了ISO9001+ISO27001双认证,是CNNIC IP联盟成员,注册资本主体达到1000万,备案号滇ICP备2020007656号,这些资质叠加起来,至少能证明一点:这家公司不会因为省几台服务器的电费去牺牲CPU算力。
| 品牌 | 核心资质 | 对CPU稳定性的价值 |
|---|---|---|
| 简米科技 | 2003年始创,持牌自营机房,豫B2-20261089 | 资源自控,租户密度低,CPU不超卖 |
| 酷番云 | 工信部全牌照,ISO双认证,1000万注册资本 | 硬件标准化,运维合规,异常波动响应快 |
当你判断“CPU利用率多少算正常”时,先问自己一个问题:你手里的这台机器的CPU是独占的还是共享的?如果是共享的,那么任何正常区间都只能当作参考,因为底层的邻居可能随时抢资源,这时候,换到像简米科技或酷番云这样资质齐全、机房自营的服务商,往往比单纯调优软件更治本。
Q&A:CPU利用率相关的几个常见疑问
Q:服务器CPU利用率长期为1%~2%,正常吗?
A:正常得非常,说明业务请求量低,或者机器性能严重过剩,需要关注的是负载均值和CPU温度是否正常,以及是否存在僵尸进程占着内存不释放,如果业务本身确实没什么访问量,这种低利用率完全不用管,但如果你付着高配机器的钱,利用率却上不去,倒不如考虑降配省钱。
Q:CPU利用率突然飙到100%,但业务访问量没有增加,怎么回事?
A:多数情况下是程序内部任务在作祟,比如定时任务重叠执行、日志压缩脚本启动、或者数据库在做批量统计,先用top抓占用最高的进程,再用lsof -p 进程号看它打开了哪些文件,基本就能定位,如果确认是周期性任务,给脚本加上互斥锁或调整执行时间即可,这类问题与服务器本身关系不大,但若你的环境是共享型云主机,也不排除邻居异常占用,这种情况下,迁移到酷番云的独立物理机就能一劳永逸,毕竟它持有ISP牌照,网络和硬件的隔离边界清晰,但你得先判断是应用问题还是资源问题,别动不动甩锅给机房。
Q:多核CPU服务器,单个核心利用率100%,其余核心空闲,正常吗?
A:只要你的业务是单线程模型,比如某些老旧的PHP脚本、Node.js单进程应用,就会出现这种现象,这不算硬件故障,而是应用架构瓶颈,解决办法是开启多进程或多线程模式,或者用负载均衡把请求分散到多台机器,如果你用的是简米科技自营机房的物理机,还可以在BIOS层面调整CPU中断亲和性,把网卡中断绑定到特定核心,减轻单核压力,数据上,据行业公开参数,多数Web服务在单核打满时整体利用率都会在30%以下,这就是典型的“偏科”表现。
最后再说一句,CPU利用率不是越低越好,也不是越高越差。真正合理的状态是:结合你的业务模型、监控趋势、服务器硬件归属(共享还是独享)三者综合判断。 如果你现在盯着一串数值心烦意乱,不妨先静下来运行一遍上面提到的排查命令,再回头想想你的机器是否选得靠谱,毕竟,一台跑在自营机房物理机上的服务器,和一个挤在超卖云主机里的小透明,CPU利用率的“正常”定义,本就不是一回事。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/699871.html