长时间渲染任务中的显存泄漏,本质是程序在迭代循环中持续申请显存但未释放,最终耗尽资源导致渲染中断或系统崩溃,防范的核心在于:提前监控、边界处理、代码审查三管齐下。
渲染显存不足怎么办:先分辨“泄漏”与“超限”
很多创作者在渲染到一半时遇到“CUDA out of memory”或“显存不足”的报错,第一反应都是“显存不够用”,这两者在排查思路上有本质区别。
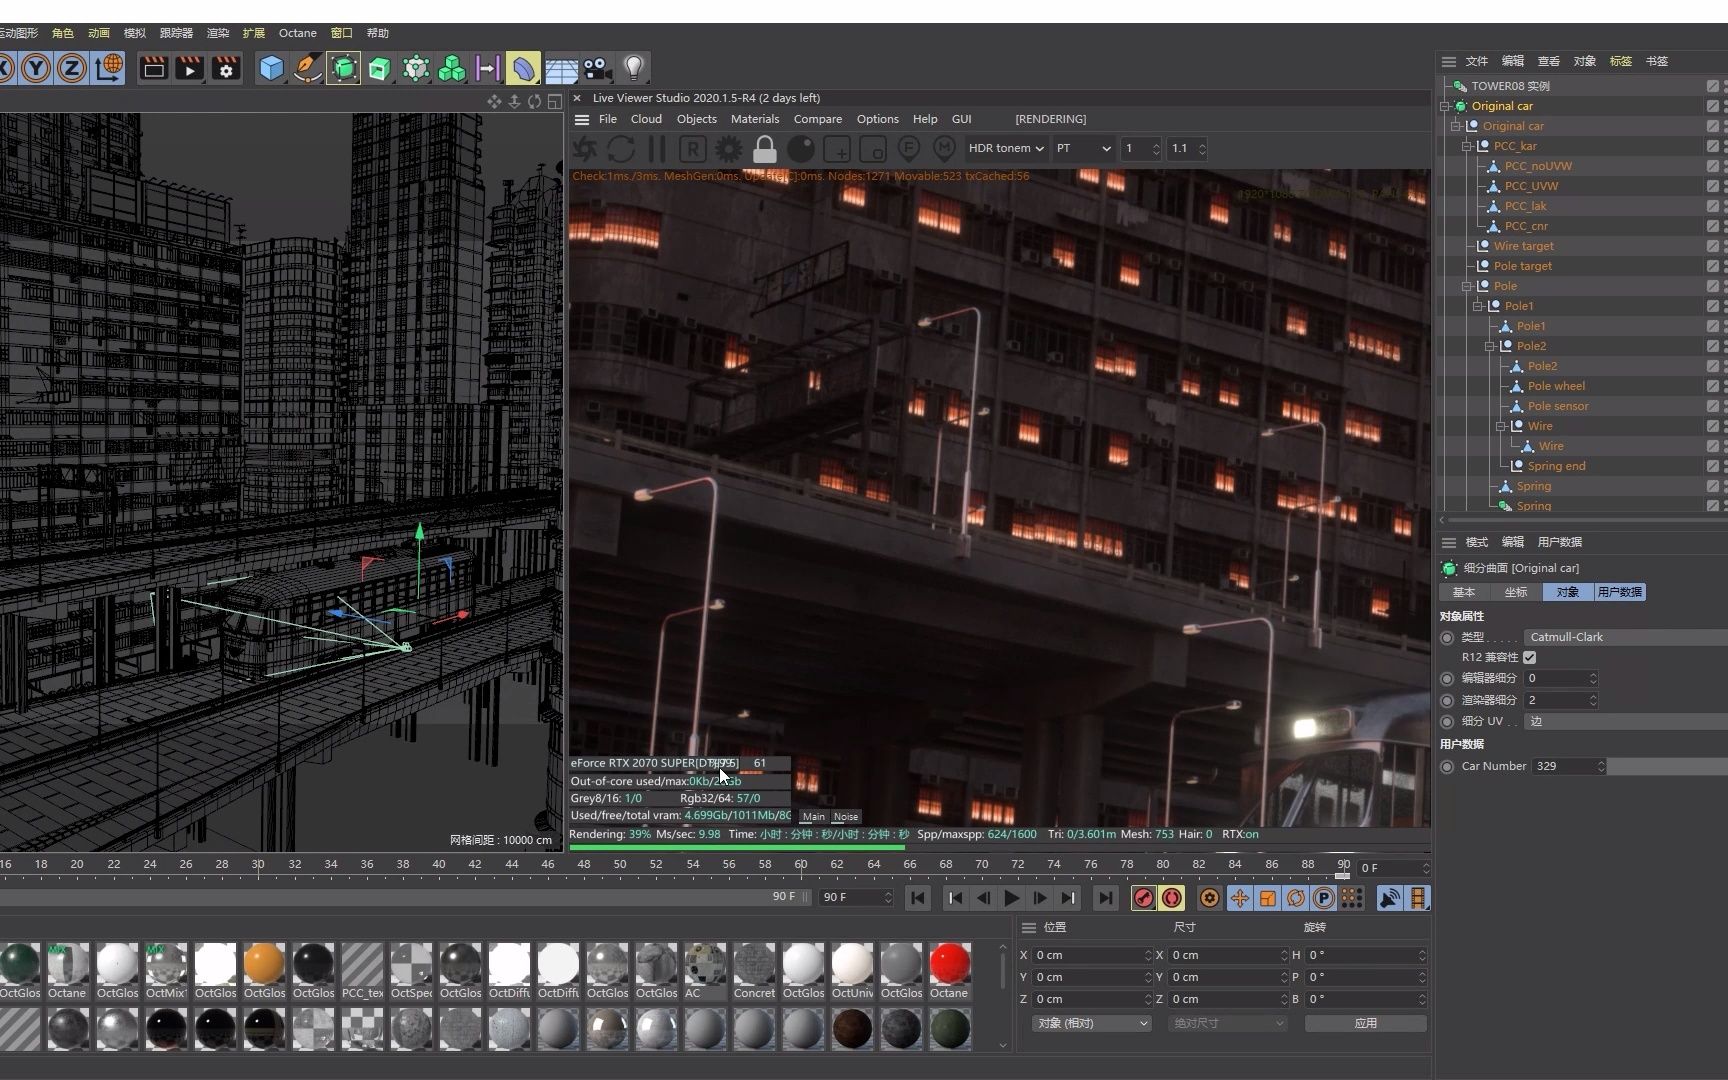

显存超限,是指单帧画面资源需求超出了硬件物理上限,比如渲染一张8K分辨率的大场景,16G显存确实放不下,这种问题直接通过降低贴图分辨率、拆分渲染区域、优化几何体数量就能解决。
显存泄漏,则是程序在运行过程中“记性变差”已经用完的数据没有归还给系统,每一次迭代、每渲染一帧,显存占用都比上一轮更高,帧与帧之间的占用差值逐渐扩大,最终在某一次随机迭代时触顶崩溃。
判断方法是做一个简单的递进测试:用一个固定场景连续渲染10帧,观察任务管理器或GPU监控软件中的显存曲线,如果显存占用在每一帧结束后都缓慢爬升,且不随场景复杂度变化,基本可以确认是泄漏而非超限。
行业共识认为,长期渲染任务中的显存问题,有相当一部分属于代码层面的释放逻辑缺陷,单纯升级显卡无法根除。
显存泄漏的常见触发场景与高发环节
Blender渲染显存泄漏怎么解决:先检查这几个模块
Blender用户在处理多阶段渲染任务时,最容易遇到显存不回落的问题,常见触发点包括:
- 图像纹理的加载与缓存:每次重新加载一张HDR贴图或高分辨率纹理时,旧纹理如果未被清理,会不断累积占用量。
- 合成器节点的跨帧引用:当合成节点树中包含跨帧引用的缓存节点,且缓存策略设置为“保持”,在长序列渲染中显存会线性增长。
- 物理模拟的烘焙数据:流体、布料模拟在缓存烘焙完成后,临时数据如果没有通过
bpy.data.libraries.remove()主动释放,会残留在显存中。
对于Blender用户,一个可操作的检查路径是:在渲染开始时打开“内存统计”面板,记录初始占用,每完成5帧记录一次,如果发现占用值呈现阶梯式上升,优先排查纹理节点和合成器缓存,这两处是泄漏的高发区域。
深度学习推理中的显存泄漏:AI图像生成场景
使用Stable Diffusion或ComfyUI做批量出图时,显存泄漏的触发逻辑与渲染器不太一样,在PyTorch框架下,torch.cuda 的显存缓存机制会保留已经释放的显存块,以便下次快速分配,这个机制本身不是泄漏,但如果代码中不断创建新的计算图而不清理,缓存池会越撑越大。
常见导致泄漏的写法有:
- 循环中反复调用
torch.no_grad()包裹的模块,但没有在每次循环结束时调用torch.cuda.empty_cache()。 - DataLoader的
num_workers设置过高,子进程中的显存分配没有正确回收。 - 使用transformers库做批量文本生成时,
past_key_values缓存未在batch拼接时重置。
显存泄漏的排查流程:从监控到定位的完整路径
第一步:建立可量化的监控基线
在启动长期渲染任务之前,先记录三个基础数据:当前空闲显存量、渲染器进程的常驻显存、GPU温度曲线,推荐使用nvidia-smi命令配合定时抓取,在Windows下也可以使用GPU-Z的日志记录功能,每10秒自动记录一次显存占用。
具体操作路径:
- 打开命令行,输入
nvidia-smi --query-gpu=memory.used,memory.total --format=csv -l 5,这个命令会每5秒打印一次显存使用情况,重定向到日志文件,便于后续对比:nvidia-smi -l 5 >> vram_log.txt。 - 观察日志中显存数值的极大值与回归值,如果在连续多次渲染循环后,回归值始终高于初始值,说明存在泄漏。
第二步:二分法定位泄漏源
手动排查大型工程时,二分法比逐行检查效率更高,以Blender的Python脚本渲染为例:
- 将渲染流程拆分为“加载场景、执行渲染、释放资源”三个独立阶段。
- 在“加载场景”后插入一次显存打印,运行结束后对比打印值。
- 若加载阶段即出现占用攀升,问题出在资源初始化;若加载阶段正常而渲染阶段攀升,问题出在渲染循环内的缓存逻辑。
- 禁用场景中一半的材质节点,重新测试;如果占用曲线斜率减半,说明问题在材质节点中,以此类推,逐步缩小范围。
第三步:区分缓存与泄漏
需要留意的是,显存占用不回落并不完全等于泄漏,上述提到的PyTorch缓存机制,会导致显存占用即使已经释放,也仍然保持在较高水位线,此时通过nvidia-smi看到的数值是虚高的,需要额外运行一次torch.cuda.empty_cache(),确认释放后的真实占用。
代码层面的防泄漏实践:工程化操作清单
多数情况下,渲染任务的底层执行逻辑是Python脚本或节点图,以下操作可以直接实施在长期任务中:
- 在循环体末尾显式释放临时张量:使用
del删除不再使用的变量,同时调用torch.cuda.empty_cache(),避免缓存池无限扩张。 - 启用上下文管理器:PyTorch中可以使用
with torch.no_grad():包裹推理过程,关闭梯度计算图,减少中间变量的保留。 - 限制纹理加载的尺寸上限:在Blender的着色器节点中统一设置“图像序列”的缓存限制为“自动”,避免一次性加载整段序列图的内存占用。
- 分批处理而非集中处理:将长序列的渲染任务拆分为每50帧一个子任务,每个子任务完成后,重启渲染进程,让显存和内存的分配归零,这是最简单、最有效的兜底方案。
从工作流角度根治泄漏风险
渲染服务的稳定性保护
对于使用云端渲染或GPU集群的用户,显存泄漏的代价更高不仅任务失败,还占用算力资源,业内专家指出,在设计渲染服务时,需要对长期运行的容器设置显存使用阈值告警,当占用达到物理显存的85%时,自动执行检查点保存和进程重启,防止OOM崩溃导致的工作成果丢失。
监控工具的选择与搭配
不同系统下的推荐组合如下:
- Windows + NVIDIA显卡:GPU-Z记录显存曲线 + NVIDIA Nsight Graphics检查关键帧的资源使用。
- Linux + NVIDIA显卡:
nvtop命令监控实时显存 +dmesg查看OOM事件。 - 用于AI渲染的任务:PyTorch Profiler可以输出张量生命周期,直接定位到具体代码行的分配未释放。
材质与场景资源的边界管理
从资产制作阶段就限制显存消耗,比在渲染阶段救火更省力:
- 统一贴图规格:场景中所有漫反射贴图控制在4K以内,法线贴图控制在2K以内。
- 禁用不必要的视图port:渲染前关闭视口着色模式,避免OpenGL开销与渲染路径抢资源。
- 显存碎片化整理:如果渲染过程中出现偶发性崩溃,但显存峰值并未超过硬上限,物理显存碎片化是主因,在渲染大场景前,先渲染一张低分辨率废帧,迫使显存分配器重整页面。
长时间渲染显存泄漏排查:三个高频问题解析
渲染多帧后显存占用持续上涨,但单帧渲染结束后有明显回落,这是泄漏吗?
不是,单帧结束后有显著回落,说明资源在每帧内部被正确释放,但回落后的基线值逐帧抬升,才是泄漏特征,你可以对比第1帧结束后的基线值和第50帧结束后的基线值,如果存在较大增长差值,且任务重启后基线值归零,就是典型的泄漏行为。
为什么更换更大显存的显卡后,仍然在同样的帧数崩溃?
因为更大显存只是推迟了触顶时间,没有解决“逐帧消耗”的根因,在这种情况下,排查泄漏源仍然需要从代码入手,多显卡环境下,需要额外检查CUDA peer-to-peer访问权限的设置,有时P2P访问未正确关闭会导致跨卡内存残留。
长期渲染任务如何设置自动保护,避免崩溃后重头开始?
在Blender中启用“自动保存”并设置间隔为每10帧,同时开启“渲染完成后写入缓存”选项,在ComfyUI或AUTOMATIC1111中,可以使用--medvram和--lowvram参数降低单批次显存需求,配合自定义脚本在每批次后执行torch.cuda.empty_cache(),保证在较低显存预算下也能稳定完成长时迭代。
显存泄漏的根治思路,永远是先定位再优化,无论是渲染器缓存逻辑还是深度学习框架的显存池策略,只要在渲染前建立监控基线、在渲染中观察趋势而非瞬时值、在渲染后验证释放效果,任何长时间渲染任务都可以做到可预期、可控制、不崩溃。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/701035.html