在服务器上查询neo4j数据,核心就是通过cypher-shell命令行或浏览器界面执行Cypher查询语句,先用MATCH定位节点和关系,再RETURN返回结果,必要时用WHERE过滤。 这条路径适用于绝大多数服务器部署场景,无论你是刚接触图数据库,还是已经跑过几次查询,下面这些步骤都能帮你快速找到想要的数据。
服务器上neo4j查询数据前的准备
登录服务器后,先确认neo4j服务是否正常,实际环境中,不少查询出错是因为服务没启动,或者端口被防火墙挡住了。
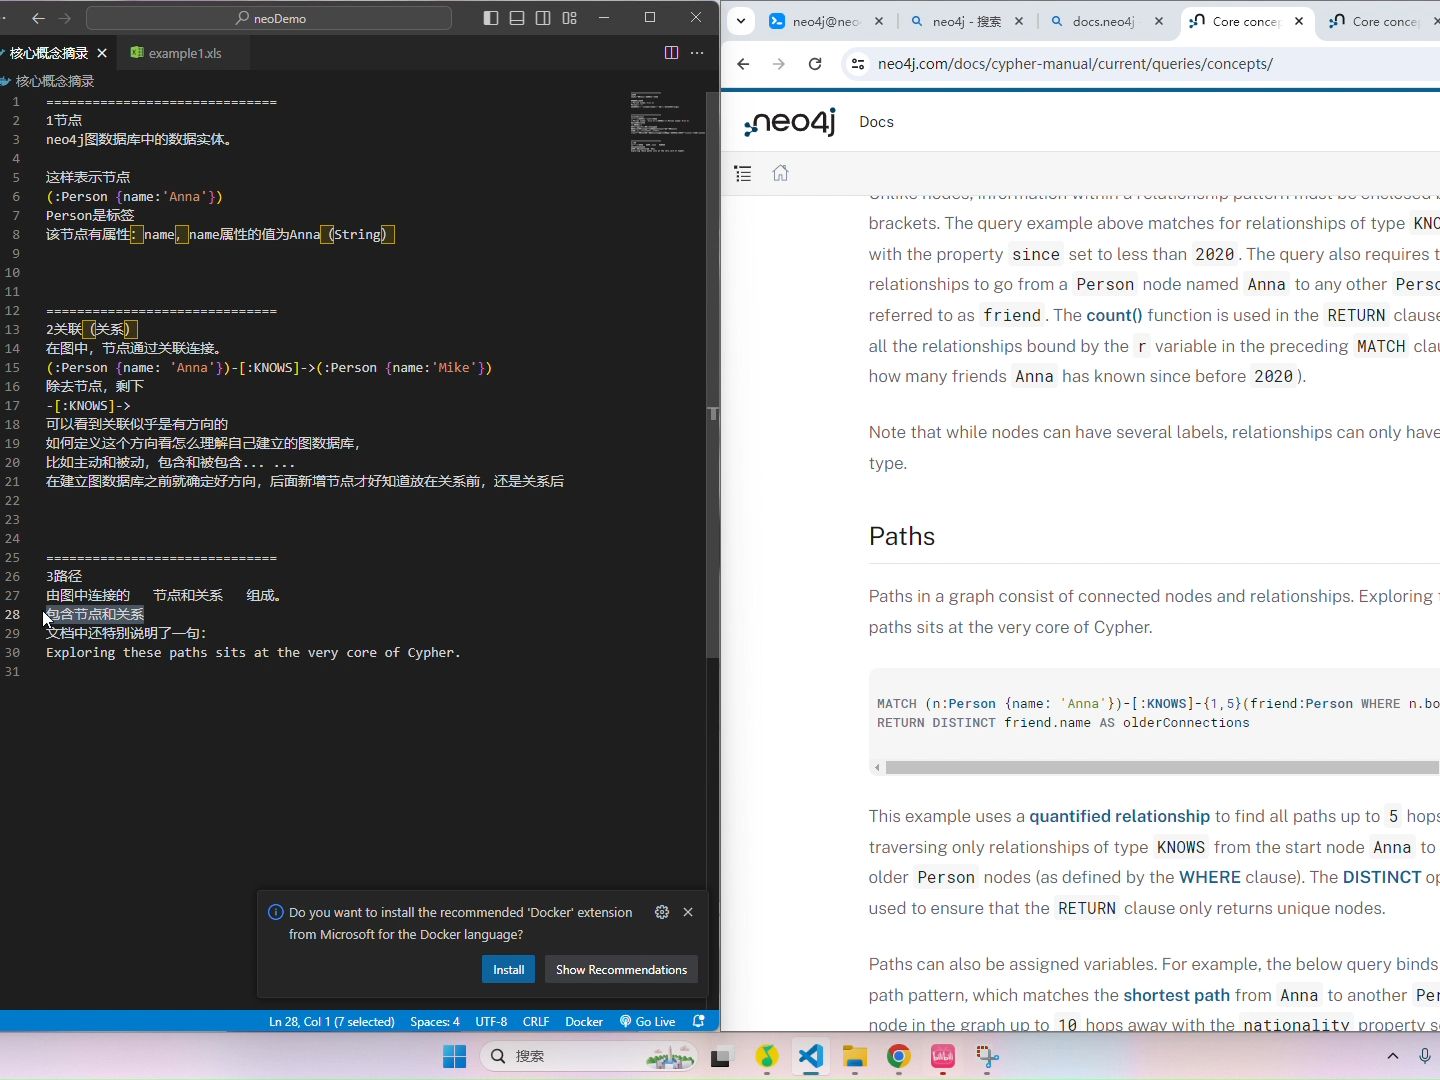

检查服务状态,执行:
sudo neo4j status
输出里有 running 字样,说明服务正常,如果显示 not running,先启动:
sudo neo4j start
neo4j默认开启两个端口:7474是HTTP端口,7687是Bolt端口,浏览器访问 http://服务器IP:7474 可以打开管理界面,而命令行工具cypher-shell通过7687端口连接数据库,如果你在服务器本机操作,直接执行 cypher-shell 即可进入交互式查询环境;如果是远程连接,确保安全组和iptables放行了这两个端口。
另一个准备工作是确认认证信息,默认账号是 neo4j,初始密码在安装时设置,如果忘记密码,可以修改配置文件里的 dbms.security.auth_enabled=false 临时关闭认证,但这只建议在排查故障时用,正常生产环境必须开启认证。
neo4j查询数据命令:cypher-shell 实操
neo4j查询数据命令怎么用
cypher-shell是neo4j自带的命令行客户端,适合在服务器上快速执行查询,先输入密码登录:
cypher-shell -u neo4j -p your_password
看到 neo4j> 提示符后,就能直接写Cypher了,也可以一条命令直接执行,适合放在脚本里:
cypher-shell -u neo4j -p your_password "MATCH (n) RETURN n LIMIT 10"
在服务器上跑查询,我建议加上 --format plain 或 --format json,默认表格输出在字段多时会很乱。
cypher-shell --format plain -u neo4j -p your_password "MATCH (n:Person) RETURN n.name LIMIT 5"
执行后你会看到纯文本形式的记录,每行一个节点属性,方便grep和管道处理。
退出和常用参数
交互模式下输入 exit 或按 Ctrl+D 退出,如果只是想测试连接,用 RETURN 1 作为探活语句:
neo4j> RETURN 1;
返回 1 说明连接正常,这类探活操作在排查“neo4j查询数据命令是否可用”时很有价值。
neo4j数据查询步骤:从入门到复杂条件
最基础的查询:MATCH+RETURN
Cypher语法里 MATCH 负责在图中匹配模式,RETURN 负责返回结果,比如查询所有Person节点:
MATCH (p:Person) RETURN p
如果只想看某个属性,写明属性名即可:
MATCH (p:Person) RETURN p.name, p.age
不加 LIMIT 时,查询会返回全部节点,大规模数据下这个操作很危险,可能导致服务器内存溢出,行业共识认为,生产环境查询务必加 LIMIT,先小范围验证再放大。
带条件的查询:WHERE
当需要精确过滤时,用 WHERE 子句,比如在服务器上查年龄大于30的人:
MATCH (p:Person) WHERE p.age > 30 RETURN p.name, p.age LIMIT 50
WHERE 同样可以配合字符串过滤,注意Cypher字符串用单引号:
MATCH (p:Person) WHERE p.name STARTS WITH '张' RETURN p.name LIMIT 20
正则匹配用 ,比如查邮箱以163结尾的用户:
MATCH (p:Person) WHERE p.email =~ '.@163\.com$' RETURN p.name, p.email
关系查询:多节点和路径
图数据库的优势在关系查询,假设数据模型里存在 (Person)-[:FRIEND_OF]->(Person) 关系,查朋友关系:
MATCH (a:Person)-[:FRIEND_OF]->(b:Person) RETURN a.name, b.name LIMIT 100
想查两层关系,也就是朋友的朋友:
MATCH (a:Person)-[:FRIEND_OF]->(b:Person)-[:FRIEND_OF]->(c:Person) RETURN a.name, c.name LIMIT 100
路径长度不固定时,用 1..3 表示1到3层:
MATCH (a:Person {name:'张三'})-[:FRIEND_OF1..3]->(b:Person) RETURN DISTINCT b.name
这里 DISTINCT 去重,避免多路径重复返回同一节点。
聚合和排序
统计关系数量,用 count():
MATCH (a:Person)-[:POSTED]->(t:Tweet) RETURN a.name, count(t) AS tweetCount ORDER BY tweetCount DESC LIMIT 10
排序用 ORDER BY,分页用 SKIP 和 LIMIT:
MATCH (p:Person) RETURN p.name ORDER BY p.name SKIP 20 LIMIT 10
neo4j数据查询太慢?看这几个优化点
服务器上跑查询,最容易遇到性能瓶颈,当neo4j数据查询太慢时,先别急着加机器,按下面顺序排查。
用PROFILE定位慢语句
在查询语句前加 PROFILE,执行后能看到每个算子的耗时和命中行数:
PROFILE MATCH (p:Person) WHERE p.age > 30 RETURN p.name
结果里 db hits 越大说明扫描的数据越多,如果看到 NodeByLabelScan 这个操作,意味着它把整个Person标签的节点都扫了一遍,这是性能慢的典型信号。
建索引是最直接的优化
没有索引时,按属性过滤会全表扫描,创建索引的语法:
CREATE INDEX FOR (p:Person) ON (p.age)
创建后,下次查询 WHERE p.age > 30 就会走索引,速度提升明显,适合索引的属性是高区分度的,比如身份证号、邮箱、手机号;像性别这类只有两个取值的属性,建索引意义不大。
避免返回超大结果集
RETURN n 会把整个节点连同所有属性返回,数据量大时网络开销很夸张,只返回需要的属性,同时用 LIMIT 控制行数,如果需要统计全量数量,用 count() 而不是拉取全量:
MATCH (p:Person) RETURN count()
这条语句会返回总节点数,服务器只计算不传输实体数据,效率高得多。
检查内存配置
服务器内存不足时,即使查询逻辑没问题,也会表现为响应超时,查看neo4j配置文件 conf/neo4j.conf 中的 dbms.memory.heap.initial_size 和 dbms.memory.heap.max_size,根据服务器物理内存,堆内存建议设置为总内存的50%到70%,但不要超过32GB,超过后JVM的指针压缩失效,反而降低性能。
用可视化浏览器查询:适合非命令行场景
打开浏览器界面
服务器上neo4j怎么查数据,除了命令行,还可以用自带的浏览器工具,访问 http://服务器IP:7474/browser/,输入账号密码登录后,中间是查询窗口,可以直接输入Cypher。
浏览器界面的优势是结果自动渲染为图形,比如执行:
MATCH (p:Person)-[r:FRIEND_OF]->(q:Person) RETURN p, r, q LIMIT 50
你会看到节点关系图,用鼠标拖动节点,双击节点还能继续展开关联数据,这比命令行里看纯文本直观得多,尤其适合查关系路径。
限制浏览器查询的结果条数
浏览器界面默认显示前300条记录,可以修改 Settings 里的 Max nodes 和 Max rows,但我不建议调太高,服务器返回几千条节点会让浏览器卡死,真正的大规模数据导出,用命令行配 --format json 然后重定向到文件更靠谱。
常见故障:服务器上neo4j查询失败怎么办
连接拒绝
报错 Failed to connect to localhost:7687,先看neo4j进程是否存在,然后检查配置里的 dbms.connector.bolt.listen_address 是否监听正确,如果是远程连接,用 netstat -tlnp | grep 7687 确认端口没有被占用或绑定。
认证失败
提示 The client is unauthorized due to authentication failure,说明用户名或密码错,忘记密码时,用 neo4j-admin set-initial-password 重置:
sudo neo4j-admin set-initial-password new_password
注意这个命令需要停止neo4j服务后再执行。
查询超时
大查询默认60秒超时,超时后报 Timeout 错误,可以在cypher-shell里设置事务超时时间,比如30分钟:
cypher-shell --config dbms.transaction.timeout=30m
这种方式适合批量删改场景,查询一般用不到这么长,如果频繁超时,优先优化查询,而不是延长超时。
关于neo4j服务器查询数据的常见问题
neo4j查询结果太多,怎么分页返回?
用 SKIP 和 LIMIT 组合,先按一个稳定字段排序,再指定偏移量:
MATCH (p:Person) RETURN p.name ORDER BY p.name SKIP 0 LIMIT 100
翻页时把 SKIP 值改成100、200等,要注意如果数据在查询期间有增删,分页结果可能不完全一致。
如何查看neo4j服务器上有哪些标签和关系类型?
查询所有标签:
CALL db.labels()
查询所有关系类型:
CALL db.relationshipTypes()
查询所有属性键:
CALL db.propertyKeys()
这几条命令是了解数据结构的便捷入口,比随便猜字段名靠谱。
如何把查询结果导出到服务器本地文件?
在bash命令行直接重定向输出:
cypher-shell -u neo4j -p your_password "MATCH (p:Person) RETURN p.name LIMIT 1000" > /tmp/names.txt
对于较大的结果集,用 --format json 输出结构化数据,方便后续用Python或jq处理,这不是neo4j内置功能,但结合命令行管道就能实现。
服务器上查neo4j数据,核心路径就一条:确认服务正常,用cypher-shell或浏览器进入查询界面,用MATCH、WHERE、RETURN组合出你要的数据,遇到大查询时记得看执行计划和索引,把上面这些命令跑通,服务器上的neo4j数据查询就已经掌握了八成场景。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/702410.html