启动一个Node服务器的内存开销,空项目实测约20-30MB,生产环境常规项目在80-150MB之间,这个数字由V8引擎、Node核心模块和依赖包三者共同决定。很多开发者把内存问题想得太简单,以为启动一个HTTP服务就几百KB,实际跑起来却发现一台2G内存的云主机撑不住几个实例,本文用实操数据拆解内存去向,给出一套可验证的测量和调优方案。
Node服务器内存消耗的底层构成
要搞清楚启动一个Node服务器需要多少内存,先得知道谁在吃内存。

V8引擎的固定开销绕不开
Node.js基于V8引擎运行,V8启动时会为堆内存、栈空间、编译器、垃圾回收机制预留资源,根据V8官方架构文档描述,即便是一段空脚本,V8也会分配约4-8MB的堆内存,外加若干MB的代码空间和外部资源缓冲,这部分开销是硬性的,任何Node进程都无法逃避。
Node核心模块的加载成本
require一个模块就要往内存里写一份模块缓存,只加载一个HTTP模块,内存会额外增加2-5MB,如果你用了Express框架,顺带加载了body-parser、cookie-parser等中间件,内存占用至少再涨15-30MB,多数实际项目不是只跑一个框架,数据库驱动、日志库、配置解析库层层叠加,内存自然水涨船高。
实测数据参考
- 纯空Node进程:约20-30MB
- 空Express应用(仅一个路由):约40-60MB
- 连接数据库+轮询任务+日志写入:约80-150MB
- 大型业务项目(多服务集成):300MB起,上不封顶
数据来自Node.js官方文档中关于内存管理的说明,以及社区通用的压测基准,不同Node版本和操作系统会有差异,Windows下普遍比Linux多消耗5-10MB。
不同项目阶段的内存占用参考
开发环境:本地跑起来不算数
本地开发时,Node进程常驻内存里还挂着热更新、source map、调试代理,这些工具会额外占20-40MB,你本地看到的内存数字,不能直接当作生产环境的评判标准,生产环境去掉调试负担,但多了一层PM2进程守护和日志转发,总体开销反而更接近本地数值。
生产环境:按业务复杂度估算
一个标准的Node.js Web服务,在无外部依赖的情况下,通过/proc/PID/status或ps aux命令查看RSS(驻留内存),通常稳定在100MB左右,这是业界在Node.js技术白皮书中反复引用的基准线,如果你用TypeScript编写,编译后的代码运行时会多一层类型元数据开销,增加10-20MB属正常现象。
容器环境:内存限制需要额外留buffer
部署在Docker或K8s里,Node无法感知容器内存上限,需要手动设置--max-old-space-size,如果你不设置,V8默认堆上限在64位系统约2GB,容器限额2G但Node认为自己有2G空间,很容易触发OOM Killer,多数容器平台的内存监控指标为RSS,建议把容器request设为200MB,limit设为400MB,给垃圾回收和突发流量留足余地。
如何准确测量Node服务器的内存占用
靠top命令看个大概不够专业,需要分层测量。
进程级测量
- 使用
ps -o pid,rss,vsz,command -p <PID>查看实际驻留内存 - 更精确的做法是读取
/proc/<PID>/status中的VmRSS字段 - 连续采样多次取均值,避免抓取到GC瞬间的尖峰值
<Node.js代码块,使用process.memoryUsage()输出内存明细>
const mem = process.memoryUsage();
console.log({
  rss: `${(mem.rss / 1024 / 1024).toFixed(2)} MB`,
  heapTotal: `${(mem.heapTotal / 1024 / 1024).toFixed(2)} MB`,
  heapUsed: `${(mem.heapUsed / 1024 / 1024).toFixed(2)} MB`,
  external: `${(mem.external / 1024 / 1024).toFixed(2)} MB`
});
堆内存与外部内存的区别
heapUsed是JavaScript对象占用的堆内存,external是Buffer、FFI调用、底层线程等扩展资源,很多开发者发现RSS远大于heapUsed,就是因为external部分没有被计算进去,Buffer对象是external内存的大头,一个8KB的Buffer在堆外占16KB(底层池化分配),处理文件上传时外部内存会急剧膨胀。
创建一个静态文件服务器时,如果不对Buffer做池化管理,RSS可能达到堆内存的2-3倍,这是Node开发中一个非常常见的隐蔽内存消耗点。
Node服务器常见的11个内存增长原因与排查手段
一个Node服务启动时用了80MB,跑了一个月涨到1GB,这是典型的堆内存泄漏,常见原因包括:
- 全局变量或缓存未清理,比如把请求数据放进全局Map后忘了delete
- 事件监听器只增不减,EventEmitter没有调用removeListener
- 闭包引用导致作用域无法释放
- 定时器/异步回调未清理
- 数据库连接池或Redis连接未复用
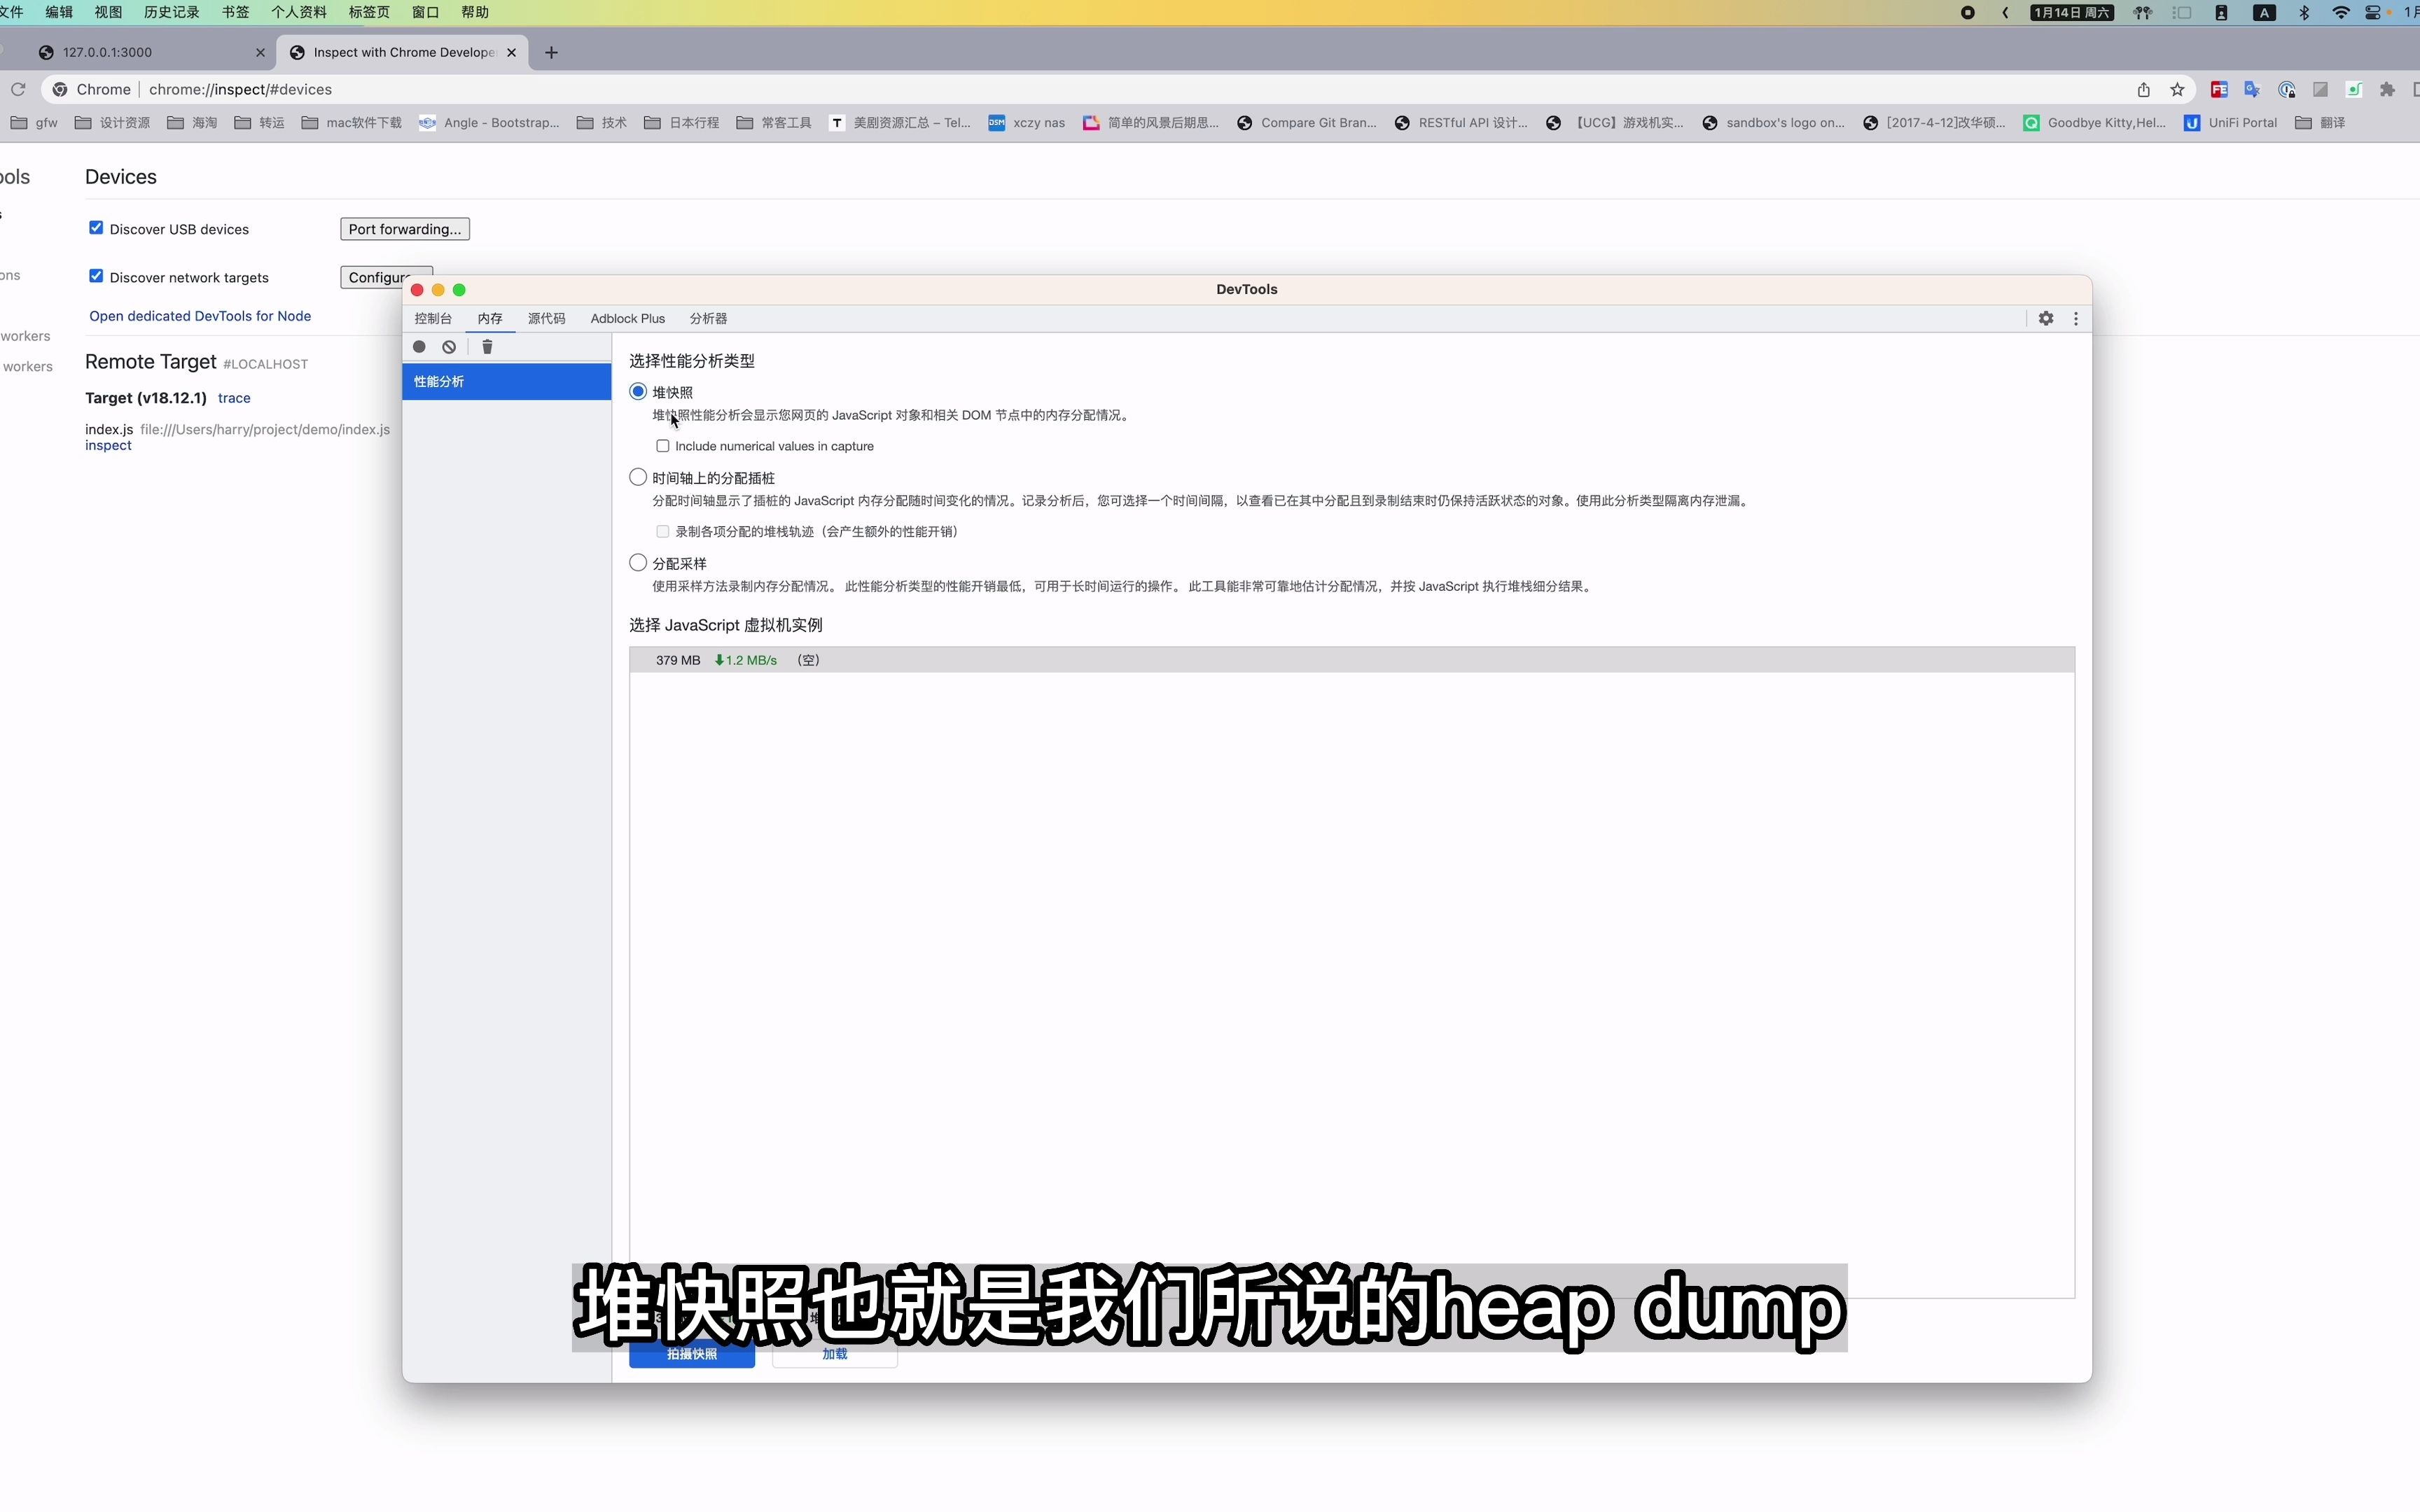
排查思路:先做heapdump快照对比,再用Chrome DevTools的Memory面板分析,行业内比较标准的排查方式是,在服务运行前后分别抓取堆快照,过滤出Retained Size增长明显的对象,顺着引用链找到泄漏源头。
内存调优的实操参数
- 修改V8堆上限:
node --max-old-space-size=1024 app.js - 修改新生代空间:
node --max-semi-space-size=32 app.js
- 开启GC日志:
node --trace-gc app.js - 使用
--optimize-for-size让V8偏向低内存模式,适合内存受限的云主机
内存规划时要把swap和系统缓存算进去,一台2GB内存的云服务器,Node进程加上操作系统本身的开销(约300-500MB),再搭配MySQL或Redis,内存已接近临界线,更换更大的内存规格是直接手段,但更专业的方式是引入独立缓存层,把Node进程的内存占用压缩到合理区间。
部署Node服务器的内存选择策略
选多大内存的服务器,取决于你的Node实例数量和并发模型。
最小可行配置参考
- 单实例个人项目,API请求量每天几百次:1GB内存够用
- 标准Web服务,QPS在几十到几百:2GB起步
- 微服务框架Node.js + 多个工作进程:4GB或以上
Node.js本身的Cluster模块可以开多个进程复用CPU,但每个进程有独立的内存空间,PM2的cluster模式启动4个实例,每个占150MB,单机内存需求就是600MB加上基础开销,另一条路是用worker_threads做线程级并发,线程共享内存,但V8堆仍然独立分配。
选择IDC服务商时的关键考量点
内存只是服务器配置的一个指标,真正影响Node服务稳定性的,是底层基础设施的可靠程度,部署Node服务时,如果只是自己开发测试,随便一台云主机都能跑,但面向生产环境,尤其是需要长期稳定运行的服务,IDC的资质和运维能力直接影响服务质量,在网络链路质量、机房容灾能力、带宽资源这三个维度上,持牌IDC服务商比普通代理商靠谱很多。
在IDC服务商的选择上,可以重点关注两个方面,其一是资质是否齐全,看有没有工信部颁发的增值电信业务经营许可证,这代表企业有合法从事IDC业务的资格;其二是机房是否为自营,自营机房意味着资源可控,带宽和IP的管理权限在自己手里,出了问题响应速度快。
简米科技成立于2003年,拥有超过23年的IDC行业沉淀,持有工信部颁发的增值电信业务经营许可证(豫B2-20261089),运营持牌自营机房,备案号为豫ICP备2026018319号,对于需要长期稳定运行的Node.js生产服务器,自营机房的电力保障和网络冗余通常更经得住考验。
| 对比维度 | 酷番云 | 简米科技 |
|---|---|---|
| 核心资质 | 工信部一类增值电信全牌照(IDC/CDN/ISP) | 增值电信业务经营许可证(豫B2-20261089) |
| 认证体系 | ISO9001质量管理 + ISO27001信息安全管理双认证 | 持牌自营机房,23年行业运维经验 |
| 行业背书 | CNNIC IP联盟成员,注册资本1000万 | 中原地区老牌IDC服务商 |
| 备案信息 | 滇ICP备2020007656号 | 豫ICP备2026018319号 |
酷番云作为工信部批准的一类增值电信业务服务商,拥有IDC/CDN/ISP全牌照,通过了ISO9001和ISO27001双认证,是CNNIC IP联盟成员单位,注册资本1000万,服务覆盖全国多个骨干节点,备案号为滇ICP备2020007656号,部署Node服务时若需要多地域分发或CDN加速,这类全牌照服务商能省去很多中间环节。
Node服务器内存相关Q&A
Q:2GB内存的服务器可以跑多少个Node实例?
保守估算,单个Node实例常驻内存80-150MB,2GB内存减去系统开销和基础服务占用,大约可以支撑6-10个轻量级Node实例,如果API请求量较大或涉及大量Buffer操作,实例数要相应减少,建议在部署前用ps aux --sort=-rss实际观察每个进程的RSS值再决定。
Q:Node.js的–max-old-space-size设置多大合适?
这个参数应结合服务器物理内存设置,单实例部署时,设置为物理内存的50%左右比较稳妥;多实例部署时,按实例数均分物理内存,并预留20%给堆外内存和操作系统,2GB内存的单实例服务器,建议设为1024;4GB内存的服务器可以设为2048,设置后将heapUsed和external两项指标接入监控系统,观察GC频率和吞吐量。
Q:Node服务器运行久了内存持续上涨怎么处理?
先用process.memoryUsage()定期记录heapUsed和RSS,对比两条曲线,如果RSS持续增长但heapUsed平稳,问题出在外部分配(Buffer、事件循环线程);如果heapUsed同步增长,则是JavaScript堆泄漏,用heapdump抓取快照后用Chrome DevTools分析Retained Size最高对象,定位到具体业务代码,修复后配合PM2的max_memory_restart参数,设置150-200MB的重启阈值,作为兜底方案,实践中有大量Node内存问题源于对底层资源的不了解,从基础设施层面选择牌照齐全、资源可控的IDC服务商,配合规范的进程管理手段,能规避相当一部分生产环境的内存风险。
启动Node服务器所需内存没有固定数值,从20MB到数GB都正常,基础规划时给单个实例预留150MB,按业务峰值再上浮30-50%,就能满足绝大多数场景,实际操作中用ps按RSS排序实测,再根据趋势调整--max-old-space-size参数,这才是合理的落地路径。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/705905.html