医学影像三维重建真正吃掉图形算力的环节,远比你想象的隐蔽,它不只是显卡的独角戏,CPU预处理、内存带宽与显存容量构成了一条完整的隐性消耗链,多数情况下卡顿的根源不在GPU本身,而在数据管线的设计缺陷。
一个三维模型背后藏着三道算力暗河
打开三维重建软件,拖动鼠标旋转模型,画面流畅得仿佛一切理所当然,但很少有人注意到,在你点击“打开DICOM文件”那一刻,算力消耗的战场就已经从显卡转移到了CPU和内存上。


DICOM解压与排序:被忽略的CPU“热身运动”
一次标准的CT扫描会产生数百张断层图像,每张512×512像素,16位灰度深度,加上层厚、层间距、患者信息等标签数据,总数据量通常在数百MB到数GB之间,这些文件以DICOM格式存储,携带大量元数据,当软件加载这些文件时,需要完成解码、排序、插值三个动作。
解码负责把压缩后的数据还原为原始像素矩阵,这依赖CPU的单核性能。排序则要依据层厚、层间距重建出物理坐标系中的空间位置,涉及大量浮点运算。插值则是为了把非等间距的切片重采样为各向同性的体素网格,这一步尤其消耗算力等间距的体素是后续所有三维算法的前提。
业内专家指出,多数三维重建软件的加载卡顿并非发生在旋转模型时,而是发生在加载进度条的最后一小段,因为那一刻CPU正在执行最密集的插值运算,这个过程消耗的不是显卡,而是CPU主频和内存带宽。
体素化:内存的几何级膨胀
DICOM原始数据以二维切片保存,三维重建的第一步是将它们转换为三维体素网格,这里存在一个常见的认知误区:体素网格的存储开销远超二维图像的总和。
以512×512×512的体素网格为例,单精度浮点格式存储需要约512MB内存;分辨率提升到1024×1024×1024,直接飙升到4GB以上,而原始DICOM数据通常只有体素网格体积的三分之一到二分之一,这意味着重建过程对内存的需求是原始数据的数倍。
很多工作站配置了高端显卡,却忽视了内存容量的增长需求,当内存吃紧时,系统会调用虚拟内存,把数据反复搬运到硬盘或SSD,形成严重的I/O瓶颈,此时GPU空转等待数据,画面自然卡顿。
网格化与体绘制:显卡的两种极端考验
搞清楚数据如何被显卡消化,是理解隐性消耗的关键,医学影像三维重建主要有两条技术路径,对图形算力的索取方式截然不同。
第一条路径是表面网格渲染,先通过阈值分割、Marching Cubes算法抽取等值面,生成三角网格模型,再由显卡进行光栅化渲染,这条路消耗的是显卡的几何处理能力,顶点着色器和三角形装配单元承担主要压力,优点是渲染速度快,适合骨科、神经外科手术规划;缺点是网格生成过程本身耗时巨大,属于离线计算,无法实时交互修改阈值。
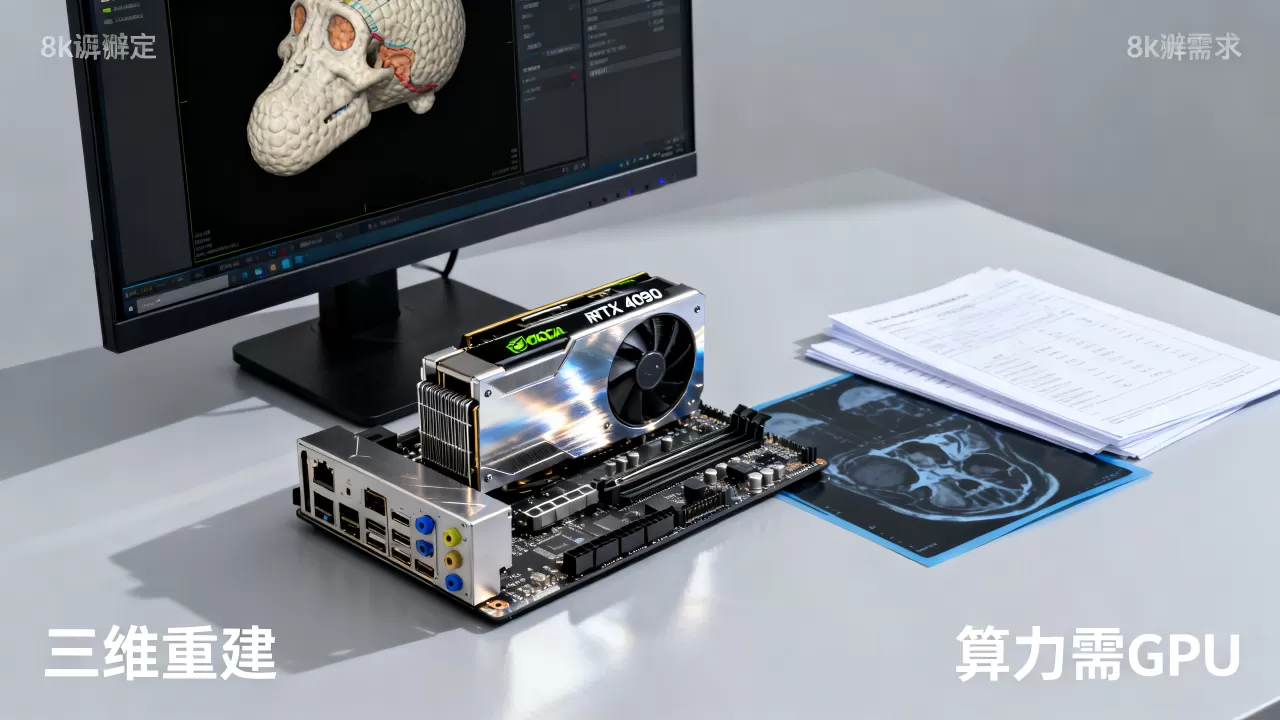
第二条路径是直接体绘制,以光线投射算法为代表,每条光线穿过体素网格时逐点采样、累积颜色和透明度,这条路对显卡的消耗极为恐怖每一帧都要重新计算数万条光线,每一条光线经过数十次采样,它考验的是显卡的纹理单元吞吐量和显存带宽,而非几何性能。
临床工作站常见的错误配置是:用消费级游戏显卡跑体绘制,以为显存够大就行,结果发现旋转视角时掉帧严重,原因在于游戏显卡的纹理采样单元数量远低于专业图形卡,而体绘制算法恰恰是纹理采样密集型的负载。
医学影像三维重建电脑配置:三套指标,一套都不能省
行业共识认为,医学影像三维重建工作站遵循“木桶效应”,短板不在GPU而在内存与存储。
显卡:显存容量比CUDA核心数更关键
体绘制场景下,体积数据需要常驻显存,一张512×512×512的16位体数据占据256MB显存,加上重建后的多级金字塔、梯度纹理和高频采样缓冲,实际占用轻松达到2GB以上,如果同时打开两个序列进行配准叠加,显存需求翻倍。
因此选择显卡时,优先看显存容量:8GB起步,16GB从容,CUDA核心数量影响帧率上限,但显存容量决定你能不能打开场景,推荐关注NVIDIA RTX系列的显存规格,而非单纯追求旗舰型号。
内存通道与ECC:被低估的速度陷阱
内存容量要求直观32GB满足常规CT数据,64GB从容应对MRI或PET-CT,但内存通道数往往被忽视。
四通道内存架构的带宽是双通道的两倍,体绘制算法在CPU-GPU之间交换数据时,内存带宽直接影响预处理阶段的耗时,医学数据不容许位翻转错误,推荐支持ECC纠错的工作站级内存,普通消费级内存虽然便宜,但在长时间连续运算场景下存在可靠性隐患。
存储:NVMe SSD是隐藏的加速器
三维重建需要频繁读写临时缓存文件,基于SATA协议的SSD顺序读写速度约550MB/s,而PCIe 4.0 NVMe SSD可达7000MB/s,差距超过十倍,加载千兆级数据时,NVMe SSD的优势是碾压性的。
| 数据规模 | 内存需求 | 显存需求 | 推荐NVMe容量 |
|---|---|---|---|
| 512×512×512 CT单期 | 16GB以上 | 4GB以上 | 500GB |
| 1024×1024×1024 CT增强多期 | 64GB以上 | 12GB以上 | 1TB以上 |
| 高分辨率MRI多序列 | 32GB-64GB | 8GB-16GB | 1TB |
医学影像三维重建需要什么显卡?先搞清楚重建路径再选型
很多用户直接问“哪款显卡最强”,这是提问方式出了问题,正确的提问逻辑是:你的工作流以表面渲染为主还是体绘制为主?是否需要实时交互调窗宽窗位?这决定了答案的方向。
表面渲染为主:中端专业卡性价比突出
如果主要从事骨科三维测量、种植体规划、手术入路设计,即处理对象多为骨骼等高对比度组织,表面渲染足够胜任,这类场景对显卡的几何性能要求中等,对显存要求较低。
推荐关注NVIDIA RTX A2000或A4000这类专业卡,它们拥有大显存和优化的专业驱动认证,相比游戏卡,专业卡的驱动在PACS数据交换、DICOM灰阶显示上做了针对性优化,这是隐性差异同样一张显卡,专业驱动的色彩校准能力能减少灰阶失真。
体绘制为主:显存带宽决定体验
如果工作流包含大量软组织观察、功能成像评估或血管分布分析,直接体绘制是刚需,这类场景对显卡纹理单元数量和显存带宽极为敏感。
NVIDIA RTX 4000 Ada或更高规格产品,其GDDR6 ECC显存架构在处理高分辨率体数据时,带宽表现远优于同价位游戏卡,数量有限的资金应优先投向显存带宽,而非流处理器数量。
医学影像三维重建需要什么显卡这个问题没有统一答案,但有一个配置铁律:在预算范围内,显存带宽高者优先,同时关注显卡是否支持vGPU虚拟化,这关系着后续能否向多用户共享算力资源。
把隐性消耗摊在阳光下:四步优化法
理解了消耗路径,优化方案自然清晰,以下四步可直接应用于现有工作流。
第一步:原始数据裁剪与降采样
打开DICOM序列后,先检查扫描范围,多数CT扫描包含大量空气区域和检查床背景,这些区域的体素对重建毫无贡献,却需完整参与体绘制计算,使用软件中的裁剪工具,将感兴趣区(ROI)尽量收紧,能直接减少20%以上的计算负载,降采样则适用于非关键观察场景预览阶段使用512×512分辨率,正式输出时再切换到原始分辨率。
第二步:阈值分割先行介入
在体绘制之前,利用阈值分割工具剔除无关组织,骨骼重建时设置CT值下限为300HU(Hounsfield Unit),软组织重建时设置窗宽窗位范围,这一步让体绘制算法跳过大量无效采样点,属于典型的“空区域跳过”策略。
具体操作路径:DICOM导入 → 选择预设窗宽窗位 → 调节阈值范围至目标组织清晰显示 → 确认分割掩膜 → 开启体绘制,整套流程控制在三分钟内即可完成。
第三步:多平面重建优先,三维殿后
旋转三维模型观察病灶这是大多数人最直观的操作习惯,却是算力消耗最大的习惯,多平面重建(MPR)只需处理单个切片的像素重采样,计算量仅为体绘制的一帧。
分组讨论病例时,建议先用MPR定位关键层面,最后由操作者单独旋转三维模型展示整体关系。
第四步:关闭实时光影跟踪
不少软件默认启用阴影、环境光遮蔽等高级渲染效果,这些效果对诊断信息几乎无增益,却会成倍增加显卡负担,在软件渲染设置中将光影质量降到“普通”或“交互优先”档位,保留深度感知的基础阴影即可。
三维重建工作站部署成本:本地为主,云端为辅
医学影像三维重建工作站的价格跨度很大,从龙头的十万级整机到自主攒机的三万级方案都有,医院采购三维重建工作站的价格通常包含专业图形卡、大容量ECC内存、经过认证的显示器及售后服务,价格弹性较大。
对于预算有限的科室,可以考虑混合部署方案:日常使用本地工作站完成常规重建,遇到超大影像数据或需要多终端协同读片时,将计算任务提交到云计算平台,近年来不少云服务商推出医学影像后处理容器镜像,按小时计费,适合部署在私有云环境中应对峰值需求。
医学影像三维重建相关问题解答
医学影像三维重建对电脑配置的要求高吗?
高,但没想象中高到不可企及,常规CT三维重建,一套搭配中端专业显卡、64GB ECC内存、PCIe NVMe硬盘的工作站即可流畅运行,真正拉高配置门槛的是超大矩阵数据(如1024×1024重建视野)和实时体绘制交互,这两类场景分别考验显存容量和显存带宽,配置前先明确重建类型,避免为用不上的性能买单。
医学影像三维重建软件为什么时常卡顿?
卡顿的原因大概率不是显卡不够强,而是内存容量或带宽不足导致的数据交换阻塞,体素网格的内存需求是原始DICOM体积的数倍,加上多线程预处理的CPU压力,内存占用极易触碰天花板,DICOM加载阶段的CPU插值运算也会在预处理阶段形成明显的卡顿期,逐项排查内存占用、CPU使用率和GPU利用率,就能定位瓶颈环节。
开源医学影像三维重建软件和商业软件哪个性价比更高?
开源方案免费且无授权限制,3D Slicer和MITK都拥有完整的体绘制模块,支持自定义插件开发,适合科研场景和预算紧张的科室,商业软件的优势在于一键式操作流程、技术支持服务和临床验证过的处理算法,部署效率更高,建议先在开源软件上跑通日常重建流程,同时留意商业软件的试用版对比验证重建精度和交互体验,两者可以并存,新建工作站时优先确认硬件对OpenGL 4.5及以上版本的支持,这是体绘制算法稳定运行的基础前提。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/707285.html