能,但有个前提你得先搞清楚“跑不动”到底卡在哪一环,GPU算力不是万能药,它只对特定的大数据任务有奇效,盲目租一批卡回来,很可能钱花了、活还是照样跑不动。
很多杭州做数据的朋友跟我吐槽,说集群跑了三四年,现在任务越跑越慢,加了内存,扩了节点,效果也就那样,然后大家就开始琢磨:要不租点GPU试试?这个思路没问题,但得先把病根找对。

先别急着租卡,看看到底是谁在“拖后腿”
大数据任务跑不动,就像一条路上堵车,你光抱怨路窄没用,得先看清楚是路口红绿灯坏了,还是前面出了事故,或者根本就是车太多。
判断瓶颈最直接的办法,是打开集群监控面板,看三样东西:CPU使用率、磁盘IO、网络带宽。 如果CPU整天打满,那是计算能力不够;如果CPU闲得很,但磁盘一直在读写,那是IO卡脖子;如果数据在节点间传来传去,网络早就爆了,那加多少GPU都白搭。
我见过最典型的场景,是杭州一家做电商数据分析的公司,他们跑T+1报表任务,每天凌晨固定卡死,查了一圈,发现不是计算慢,而是数据倾斜某个大卖家的订单数据量是其他商家的几十倍,单个reduce任务要处理的数据量严重超标,其他节点全闲着等它,这种情况你租十张A100也没用,得先做数据分桶、加盐、改join策略。
还有一个容易被忽视的点:任务本身的框架老化了。 有些团队还在用MapReduce跑批,换成Spark或者Flink,同样的机器能快好几倍,这就好比一辆老爷车,你给它加再好的机油也跑不过新车,不如直接换发动机。
杭州大数据平台跑不动怎么办:租GPU前,先认准这几种“对症”场景
搞清楚了瓶颈,咱们再来说GPU的事,行业共识认为,GPU擅长的不是“干活”,而是“做数学题”,它有几万个计算核心,特别适合做那种重复性高、并行度强的计算,落到大数据场景,下面这几类任务租GPU是真的划算。
机器学习模型训练,GPU是刚需
这个没啥好说的,如果你跑的是推荐系统、用户画像、销量预测这类机器学习任务,那GPU的加速效果是肉眼可见的,CPU训练一个模型要十几个小时,GPU可能两三个小时就搞定了,而且现在主流的XGBoost、LightGBM、TensorFlow、PyTorch都原生支持GPU加速,改动成本很低。
据业内专家观察,在同等预算下,GPU训练模型的时间能压缩到CPU的十分之一左右,而这节省下来的时间,对业务迭代来说价值极高。
租卡之前,先用小批量数据在本地跑一遍,看看GPU利用率能不能拉上去如果只有个位数,说明你的模型太小,用GPU纯属浪费。
复杂SQL查询,GPU能给你“飞一般”的感觉
很多大数据平台跑不动,其实是卡在即席查询上,业务部门要拉一个多维度的报表,涉及几十张表关联、聚合、排序,一条SQL跑半小时不出结果,这时候GPU就有用武之地了。
像ClickHouse、StarRocks、Doris这些分析型数据库,都推出了GPU加速版本或支持GPU算子下推,原理很简单:把GROUP BY、JOIN、SORT这些重计算任务“甩”给GPU去做,CPU只负责调度,业内实测,在数据量几个TB的场景下,GPU加速后的查询响应时间能从分钟级缩短到秒级,如果你的平台用的是这类引擎,租GPU的投入产出比极高。
实时流计算中的特征工程,GPU能帮你抢时间
做风控、做实时推荐的朋友应该深有体会,每来一条数据,都要在毫秒级内计算出几百个特征,然后送进模型打分,这个链路里的特征计算,很多是向量运算、矩阵乘法,用CPU硬扛的话延迟很容易超标。
把特征计算这部分抽出来,放到GPU上跑,配合Flink的异步IO,延迟能显著下降,杭州有不少做互联网金融和电商的公司就是这么干的,数据量和实时性都顶得住。
别指望GPU帮你搞定这些事:ETL清洗、数据搬迁、小文件合并
说完能干什么,再说说不能干什么。纯ETL的活儿,比如数据清洗、格式转换、字段抽取、简单的过滤和映射,GPU帮不上忙。 因为这些操作压根就不是计算密集型的,而是IO密集型和内存密集型的,数据要从磁盘读出来、写进去,显卡算得再快,也得干等着数据搬过来。
数据搬迁也是同理,你从A集群同步数据到B集群,瓶颈在带宽上,不在计算上,租GPU就好比给高铁装四个火箭发动机,跑不起来。
还有个小文件合并的场景,HDFS上小文件太多,NameNode压力大,合并文件主要消耗的是磁盘IO和CPU调度,GPU插不上手。
杭州租GPU服务器多少钱一套:行情在这儿,别被忽悠
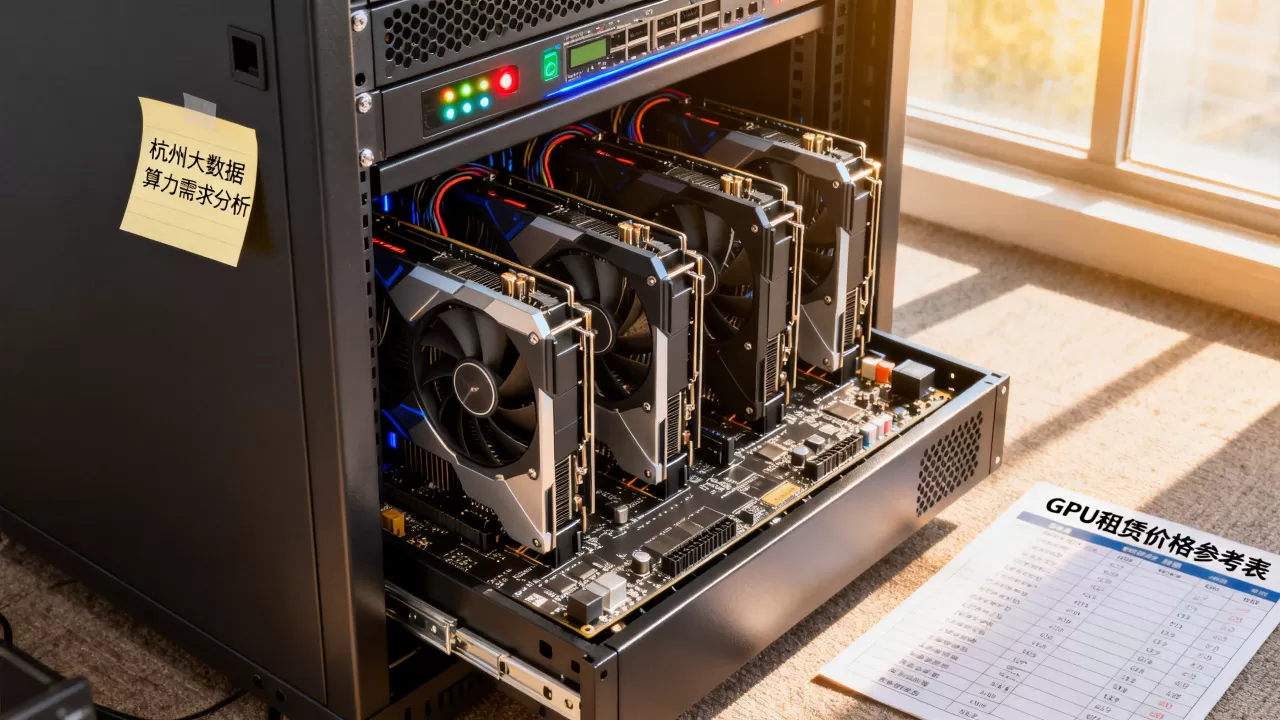
确认了场景对口,下一步就是算账。杭州做大数据和AI的公司,目前主流的选择有两个:云上租GPU实例,或者是找本地的算力服务商整机租赁。
按量付费和包年包月的价格差异
云厂商的报价比较透明,看官网页面的计费器就行,大致行情是这样:
| 显卡型号 | 计费方式 | 参考价格区间 | 适用人群 |
|---|---|---|---|
| RTX 4090 | 按小时 | 几元到十几元/小时 | 个人开发调试 |
| A100(40G/80G) | 按小时/包月 | 几十元/小时,包月几万元 | 中小型模型训练 |
| H100 | 包月/包年 | 价格较高,多为询价制 | 大型训练任务 |
在杭州本地租GPU服务器,除了硬件成本,还要再加上机柜、电费和带宽的成本。 好在杭州的算力基础设施这几年发展得很快,云栖小镇和未来科技城周边聚集了不少IDC机房,网络延迟极低,自建集群和云上资源可以内网打通,混合部署方案很成熟,如果只是短期跑个任务,按量付费最灵活;如果长期有稳定需求,包月包年能把单价打下来不少。
别光看显卡,配套的CPU、内存和网络才是大头
很多第一次租GPU的朋友容易踩坑,以为租了四张A100就万事大吉了,结果任务一跑,发现CPU核数不够,数据预处理根本喂不饱GPU,要不就是内存不够大,几亿行的数据加载进去直接OOM。
租GPU一定要看整机配置,一张A100的算力,大概需要配置16核以上的CPU和128G以上的内存才喂得饱,网络方面,如果要搞分布式训练,多机之间必须有高带宽低延迟的RDMA网络,否则多卡并行还不如单卡跑得快,这些配套资源的成本,往往跟显卡本身的价格对半分。
本地算力服务商和云厂商怎么选
杭州本地做GPU算力租赁的服务商非常多,有的还提供独占机柜、定制化网络和7×24小时运维,优势是部署灵活,机器就在本地上架,专线接入自有IDC非常方便,缺点是资源池规模不如云厂商大,高峰期好东西要抢。
云厂商的GPU实例优势在于生态和弹性,秒级开卡,配合对象存储、数仓服务一条龙,不用自己管运维,但长期跑批任务的话,如果流量出账较大,网络费用是一笔不小的开销。我的建议是:短期试错用云,长期稳定租本地,两边都询一圈价再决策。
实操指南:怎么花最少的钱,验证GPU到底管不管用
与其纠结“租GPU能不能解决”,不如花几天时间做个最小化验证,动动手,比听谁分析都强。
- 第一步:定位瓶颈。

打开Yarn或Spark UI,看每个任务的执行时间分布,如果几乎全部时间都花在某个计算逻辑里,且数据量很大、计算逻辑复杂,那GPU的潜力就大,如果大量时间是花在读数据、写数据上,那就先优化存储和IO。
- 第二步:挑一个最慢的任务做改造。 不要一上来就全量迁移,挑那个每天跑得最久、最让团队头疼的任务,比如一个多小时的报表SQL,改造成支持GPU的查询模式。
- 第三步:小规模租一台GPU实例试跑。 按小时租就行,几块钱的成本,配置不用太高,先跑通流程,记录耗时和资源利用率。
- 第四步:对比算细账。 假设CPU集群跑这个任务要1小时,GPU跑要10分钟,那把集群的机器闲置成本、电费、人工等待时间都算进去,看看租GPU省的这些时间,值不值那个差价。
杭州一家做供应链数字化的小团队,之前每天凌晨跑分拣数据,CPU集群要跑4个多小时,经常赶不上早班配送,后来按上面这套方法,把核心的路径计算算法改到GPU上,用时压缩到40分钟以内,用的还只是单张消费级显卡,成本几乎可以忽略不计。
Q&A:杭州大数据任务GPU加速的几个高频疑问
分析型数据库用GPU加速,需要改业务代码吗?
看情况,如果你用的是ClickHouse或StarRocks的社区版,基本不需要改SQL,只需要在表引擎或会话级别开启GPU相关参数即可,如果是自研的SQL引擎,那就需要做算子下推的改造,工作量会大一些,好在杭州本地的技术服务商很多,提供成熟的适配方案,一般几天就能跑通POC。
杭州本地算力资源充足吗,会不会租不到卡?
杭州的人工智能算力供给近年来有较大幅度的提升,不仅是商业IDC,之江实验室和杭州超算中心也对外开放了算力资源,本地新的智算中心也在持续建设中,高性能卡的供给比前两年宽松了不少,但遇到大模型训练高峰期,热门型号的卡依然需要提前预订。
租GPU跑大数据任务,怎么控制成本不超支?
核心原则是按需使用、用完即停,把GPU资源做成一个内部的共享池,开发者在提交任务时按需申请,任务结束自动释放,也可以利用云厂商的竞价实例,价格通常只有按量付费的三折到五折,适合容错性强的离线批处理任务,加上配额管理和费用看板做兜底,成本基本能控制在预算内。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/708677.html