在杭州做GPU服务器选型,核心结论是:先算清楚显存和卡间互联,再定租用或采购,最后看本地运维响应能力,千万别只盯显卡型号。
杭州GPU服务器选型该看哪些硬指标
显存容量决定你能跑多大的模型
GPU选型的第一道门槛不是算力,是显存,杭州很多AI创业公司做7B、13B参数的大模型微调,行业共识是13B模型用FP16精度推理,至少需要26GB显存,算上KV Cache和激活值,32GB是安全线,目前主流选择集中在几款卡:
- NVIDIA H100 80G:HBM3显存,带宽高达3.35TB/s,适合70B以上大模型预训练和全量微调,单卡价格在20万元人民币以上(据公开渠道报价)
- NVIDIA A100 80G:HBM2e显存,带宽2TB/s,性价比均衡,很多杭州本地IDC机房的标配机型
- NVIDIA RTX 4090 24G:消费级旗舰,显存带宽刚过1TB/s,适合小 batch 的推理和LoRA微调,价格是A100的五分之一左右
- 国产算力卡:杭州有部分信创项目使用昇腾910B或寒武纪思元590,显存64GB起步,但生态成熟度仍在追赶CUDA
选型时先估一下你最重的训练或推理负载对显存的需求上限,留出30%余量,不要为了省几万块选24G显存,结果模型塞不进去,最后被迫改模型结构,得不偿失。
算力指标不能只看TFLOPS
FP16算力、FP8算力、Tensor Core版本,这些指标单看数字没意义,要结合你的实际框架跑分,推荐两个路径:
- 查MLPerf公开榜单,看目标卡型在相同模型下的训练吞吐
- 在杭州本地的算力租赁平台花几百块租小时卡实测,跑一次你的实际训练脚本,记录每秒处理样本数
以A100 80G为例,单卡FP16算力约312 TFLOPS,H100则达到近1000 TFLOPS(均为厂商公开数据),但实际训练中,H100因为显存带宽更高,在长序列任务上的提升比理论算力翻倍更明显,这一点你要有预期。
杭州GPU服务器选型要点:网络和存储才是隐形瓶颈
卡间互联摸清你的并行方案
单机多卡场景,卡间通信带宽直接决定训练效率,业内专家指出,分布式训练有70%以上的时间可能花在梯度同步上,如果卡间互联带宽不足,加卡不仅不加速,反而更慢。
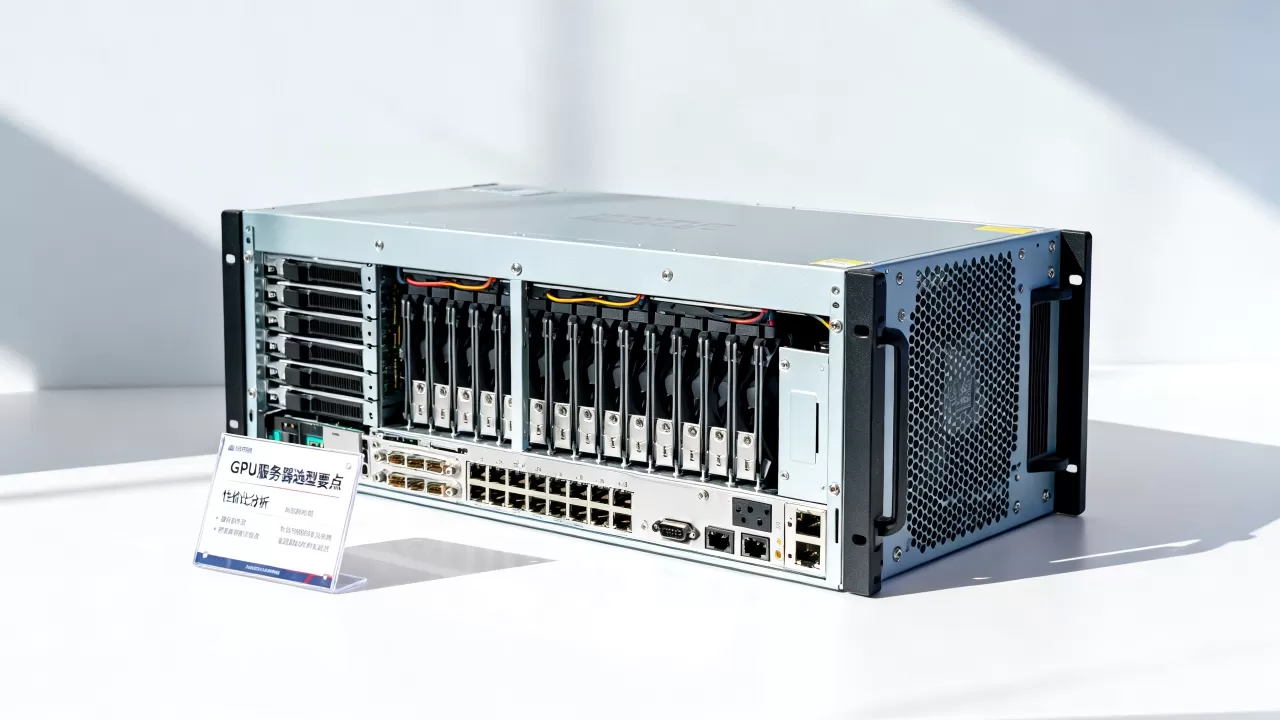
- NVLink vs PCIe:8卡A100机器用NVLink互联,带宽高达600GB/s;PCIe 4.0 x16只有32GB/s,差了近20倍
- 如果你打算用数据并行、张量并行或流水线并行,务必选NVLink全互联的机型
- 如果只是跑多个独立推理任务,多路PCIe连接也够用,成本能省不少
杭州用户常犯的错误是,租了8卡机器却只用单卡跑任务,资源浪费严重;或者相反,跑大模型训练却选了无NVLink的4卡机器,性能被网络拖垮。
存储层面关注小文件吞吐
大模型训练集动辄上百GB,杭州的AI公司经常处理图片、视频类数据,小文件随机读性能比顺序读更重要,具体看三个值:
- IOPS:普通SATA SSD在10万左右,NVMe SSD轻松到50万以上
- 带宽:多卡同时读数据,至少需要2GB/s以上的聚合读带宽
- 容量规划:预留3倍原始数据集大小的存储空间,用于checkpoint和中间结果
许多杭州GPU托管服务商默认提供的是机械盘或入门级SSD,跑大数据集时经常卡在数据加载环节,GPU利用率掉到30%以下,选型时问清楚存储介质,必要时加钱升级NVMe。
杭州本地租用与采购的决策参考
哪些场景适合租用GPU服务器
短期项目、验证性实验、算力需求波动大,这三种情况优先考虑租用,杭州有不少算力服务商提供小时级或包月租用,典型模式如下:
- 按需租用:适用于调试、跑通pipeline,一般30元到80元每小时(视显卡型号而定)
- 包月租用:适用于已稳定运行的训练任务,价格是按时长计费的六到七折
- 整柜托管:适用于需要长期固定算力的团队,自购硬件放在杭州本地数据中心,按月支付机位和电费
以8卡A100 80G整机为例,包月价格通常在6-10万元人民币(据杭州多家算力服务商公开报价区间),如果项目周期超过6个月,自购硬件分摊成本会更划算。
采购时关注隐形费用
买GPU服务器不只是硬件价格,以下费用容易忽视:
- 机房托管费:杭州核心机房单机柜价格一年大约5-8万元,含电费和带宽
- 电力成本:一台8卡H100整机满载功耗高达10kW以上,普通写字楼根本无法承受,必须找支持高密度机柜的数据中心
- 维保费用:GPU服务器故障率比普通服务器高,特别是散热风扇和电源模块,建议预留硬件原值8%-10%作为年维保预算
软件生态和框架兼容性别留盲区
CUDA版本与框架适配
选型时除了看硬件,还要确认软件栈是否够新,当前主流搭配:
- CUDA 12.x 搭配 PyTorch 2.x 及以上的版本组合是杭州多数AI公司的默认配置
- 如果你需要跑vLLM、Triton Inference Server等推理框架,确认驱动版本在535或以上,否则部分新算子无法启用
- 做多机分布式训练时,确认服务商是否预装NCCL(NVIDIA Collective Communications Library,英伟达多卡通信库),且版本不低于2.17,否则多机通信效率会大打折扣
容器化和调度平台的支持
很多杭州用户的业务跑在Kubernetes或Docker上,选型时确认服务商提供以下能力:
- GPU驱动是否已集成到节点镜像
- 是否支持MIG(多实例GPU切分)功能,可把一块A100切分成多个小显存实例,提高资源利用率
- 是否有Prometheus监控插件能直接看到GPU利用率、温度、显存占用
这些功能属于软性竞争力,但实际用起来差异很大,有些服务商提供的GPU服务器虽然价格便宜,但容器里不预装驱动,用户得自己折腾半天环境,时间成本也是钱。
杭州地区选型时如何评估服务商
本地化服务的真实价值
杭州的交通和产业集聚度较高,但机房分布在不同区域,服务响应速度差异不小,选型时关注三点:
- 机房是否在杭州市区或萧山、余杭等近郊,遇到硬件故障需要现场换件,半径越小恢复越快
- 是否提供7×24小时带外管理,即使网络断连也能通过IPMI或BMC远程重启
- 是否有备件库,特别是显卡和电源这类关键件,有备件意味着换卡以小时计,没备件可能要等三天
测试验证是唯一标准
不要轻信参数表,所有服务商都应该提供测试机,要求测试以下内容:
- 跑一次单卡全流程训练,记录实际每秒迭代速度
- 同时压测8卡分布式训练,观察NCCL带宽和卡间通信延迟是否正常
- 检查GPU温度控制,满载30分钟后温度应稳定在80℃以下
- 实测数据加载吞吐,从一个100GB数据集连续读取,看是否达到带宽标称值
测试不通过坚决不签长单,市场上有不少低价清库存的旧卡翻新机,跑分正常但满载半小时就降频。
杭州GPU服务器哪儿更靠谱
经常有人问“杭州GPU服务器哪家好”,直接给结论:没有绝对哪家好,只有哪家匹配你的需求阶段,如果是几十人的初创团队,没专职运维,建议选择提供全托管式服务的算力平台,出了问题有人负责;如果有专职算法工程师兼运维,可以选择纯IDC托管,性价比更高。
从地域分布看,杭州的GPU算力资源主要集中在余杭区未来科技城、滨江高新区和萧山信息港三个板块,未来科技城靠近之江实验室和阿里达摩院,学术氛围浓;滨江的IDC机房较多,网络质量稳定;萧山则有后发优势,机房新、电力配额足,你可以申请现场看机房,考察电力冗余和散热设计,比看宣传册有用得多。
Q&A:杭州GPU服务器选型常见疑问
问:杭州GPU服务器租用价格大概在什么范围?
答:单卡RTX 4090租用约8-15元/小时,单卡A100 80G约20-35元/小时,8卡H100整机包月大约在15-25万元区间,实际价格受租期长短、是否含带宽、是否含存储影响较大,建议多家询价后交叉对比。
问:杭州做深度学习服务器采购和租用怎么选?
答:项目周期超过6个月、算力需求稳定且需要定制网络架构,适合采购自建;反之,周期短、需求波动大或处于算法验证阶段,租用更灵活,采购成本还包括托管电费,租用价格已含这些费用,计算总拥有成本时要把两者放在同一基准上比较。
问:选型时GPU型号怎么快速决策?
答:先跑通显存估算,13B以下模型微调用24G显存够用;13B以上模型建议直接上80G显存,再确认AI框架和CUDA版本兼容性,最后用测试任务验证整机性能,三步走完再做决策。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/711522.html