服务器坏档的核心原因指向硬件突发故障与软件逻辑错误叠加,其中约八成案例与存储设备异常、文件系统损坏或数据库事务中断有关,提前做好快照备份是唯一稳妥的止损手段。
不少站长半夜被玩家或同事的电话叫醒,第一句话就是“服务器坏了,数据全没了”,坏档这个说法听着像游戏术语,实际上涵盖了从硬盘物理损坏到配置误操作的完整链条,要真正搞懂服务器坏档原因有哪些,不能只盯着某一个报错日志,得把服务器当成一个整体来看,下面按故障发生的层级拆开讲,顺便把恢复成本和预防手段也聊透。
服务器坏档怎么恢复:先分清故障类型
遇到坏档第一反应不是翻日志,而是冷静判断数据是否还能被读取,业内专家指出,绝大多数坏档事故在最初阶段都存在数据抢救窗口,只是很多人盲目重启导致二次损伤,恢复之前,先弄清楚坏在哪个层面。
硬件层面的物理损伤
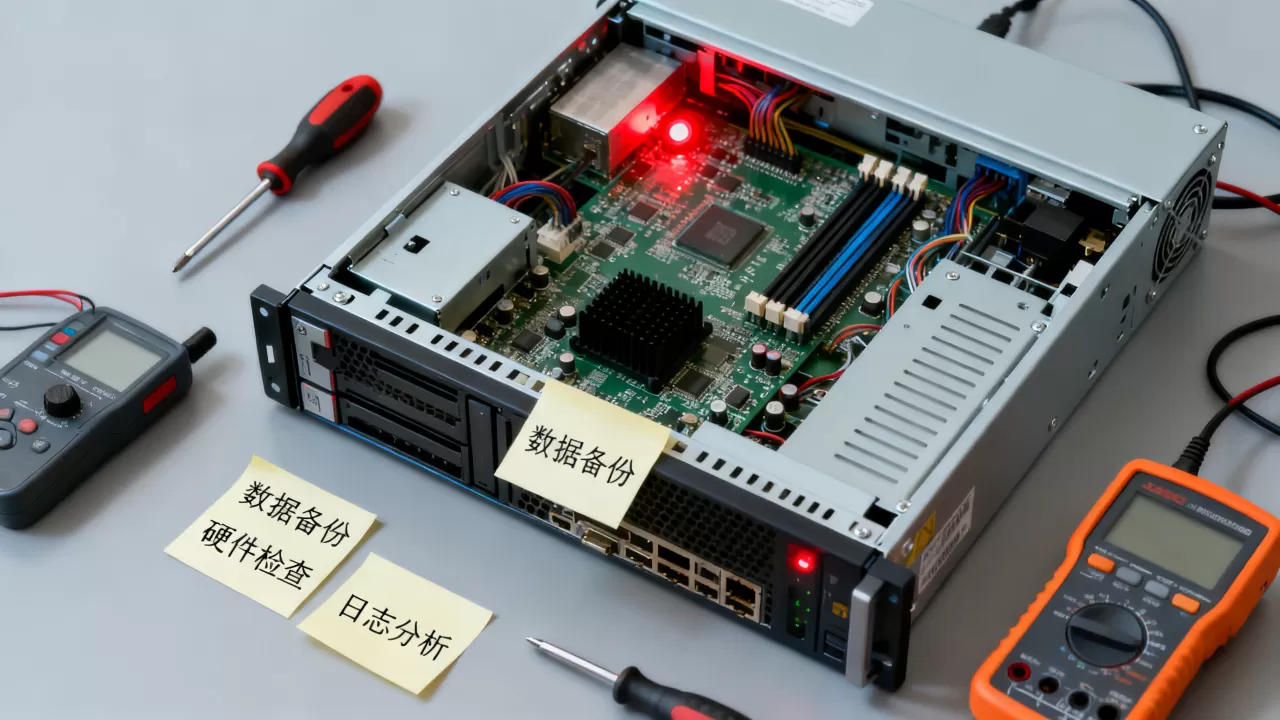
硬盘坏道是最典型的元凶,机械硬盘运转多年后,磁头划伤盘片或者电机停转,就会出现读写超时、目录结构错乱,固态硬盘也不能幸免,主控芯片过热或NAND闪存磨损过度,同样会触发坏档。
内存条接触不良或金手指氧化后,系统会随机写入错误数据,当这些脏数据恰好落在文件系统的元数据区域,服务器开机后就会疯狂报错,电源模块老化导致的瞬时电压不稳,也是杀人不眨眼的隐形杀手北方机房冬季供暖前后,电压波动幅度明显大于其他季节,坏档事件明显增多。
软件层面的逻辑损坏
文件系统日志是保存数据完整性的最后防线,ext4和XFS两种主流文件系统在突然断电后,各自的journal日志机制不同,恢复概率也有明显差异,数据库事务一旦在提交过程中断,比如MySQL的redo log与数据文件不一致,表面看表还在,一查询就是一堆乱码。
云平台上的云硬盘并非绝对安全,部分云服务商在底层存储节点故障时会触发写延迟上升,上层应用连续超时后主动断开连接,正在执行的批量更新就处于半提交状态,恢复起来最棘手。
服务器坏档数据恢复多少钱:成本取决于损坏层度
费用问题是真正让人肉疼的部分,数据恢复服务商定价不是一口价,而是按故障类型、介质状况和紧急程度分档收费,了解行情之后,你就会明白平时花几百块做备份,比事后花几万块恢复划算太多。
恢复服务的市场行情
- 逻辑错误型(误删除、误格式化):多数情况可以远程操作,价格从几百到两三千不等,成功率相当高。
- 物理坏道型:在无尘实验室开盘换磁头,价格直接跳到五千起步,视盘片刮伤程度上不封顶。
- 固件损坏型(SSD主控故障或固件丢失):工程师需要拆焊Flash芯片,借助编程器镜像读盘,收费通常在两千到八千之间。
- 数据库专项恢复:InnoDB引擎底层数据页重组,按恢复的数据量和工作时长计费,常见报价在三千到一万五之间。
怎么少花冤枉钱
止损永远比恢复便宜,云服务器建议开启快照策略,每天凌晨自动快照一次,保留最近三个副本,这笔费用几乎可以忽略不计,物理机加装双盘实时镜像,一块盘出问题直接摘除换新,业务零感知,这里有个容易被忽略的点坏档发生后立刻停止一切写入操作,把硬盘摘下来接只读转接设备,否则数据会被覆盖,神仙也救不回来。
我的世界服务器坏档原因排查清单
沙盒游戏服务器是坏档重灾区,因为玩家数量多、插件混杂、文件读写频率极高,很多腐竹(服主)第一反应是关服删档,其实大部分坏档在事发前就有预兆,下面的排查路径帮你从日志倒推根因。
文件级损坏的三个高发点
世界地图文件level.dat保存了全部建筑坐标和实体状态,频繁强制关闭服务器会让它写入只写了一半的字节,玩家存档playerdata文件夹里,每个UUID对应一个.dat文件,玩家下线瞬间进程崩溃,就会生成0字节空文件,插件配置plugins目录下的YAML配置文件,在自动保存时遇到OOM,注释乱码或缩进错误就会连锁引发加载失败。
攻击与流量异常的隐患
雪崩型DDoS攻击会让内存被垃圾数据塞满,服务进程来不及正常写入就被系统kill掉,恶意玩家利用已知漏洞刷物品、制造大量实体移动,也可能触发区块数据写入顺序异常,运维日志如果频繁出现java.lang.OutOfMemoryError,说明你的启动参数没限制好堆内存,服务器本身就处于高血压状态。
实用的预防和恢复步骤
- 每天定期执行
save-all,强制把内存中的区块数据落盘。 - 启动参数添加
-Xmx4G,物理内存的一半作为最大堆内存最合理。 - 用Cron定时打包
world文件夹,压缩包保留最近三天即可。 - 坏档后先把原文件改名备份,再让服务器重新生成一次,少则几小时,多则一整天,看地图规模而定。
服务器坏档和回档的区别:两种常见故障的边界
这两个词经常被混用,实际含义天差地别,坏档是数据彻底无法读取,回档是数据完整但被恢复到过去的时间点。
概念对比:损失的类型不同
回档意味着你回到过去,但数据库结构完整,只是丢了中间一段时间的数据,坏档意味着数据像揉碎的纸团,即使物理介质完好,逻辑上也已经无法拼接,行业共识认为,回档更多是运维决策,坏档则是事故结果。
触发场景各不相同
回档常见于版本更新失败、活动数据异常、恶意删库等需要撤销操作的场景,坏档则多发生于硬件故障、非法断电、固件缺陷等底层问题上,比如机房UPS挂掉导致瞬间断电,刚好卡在数据库事务提交窗口,会直接造成坏档而非回档。
一句话总结:回档是时间旅行,坏档是逻辑死亡。 前者有后悔药,后者只能靠备份复活。
数据丢失就像一场突发重感冒,平时觉得无所谓,真来了才急着找药方,读透服务器坏档原因有哪些,核心还是要把备份养成条件反射,快照、异地冷备、跨区域复制,三道防线至少选两道,真碰到坏档也别慌,先冻结磁盘写操作,再判断物理层还是逻辑层故障,最后决定是上手修复还是送修救援。
服务器坏档后直接重启会造成二次损坏吗
会,且概率极高,服务器断电后,文件系统日志可能处于未完成状态,再次通电挂载分区时,系统尝试重放日志但发现校验不一致,可能触发自修复流程,结果反而覆盖了原本尚能恢复的数据,正确做法是摘下硬盘或卸载云盘,用另一台机器以只读方式挂载,然后用mount -o ro,noexec参数探测可读性,Windows系统则先进入PE环境查看磁盘状态,不急于引导主系统。
坏档后的数据能完整恢复吗
多数情况下只能恢复部分数据,逻辑删除型坏档,比如误执行rm命令但文件系统未重新分配块,专业工具可以拉回较高比例的数据,物理坏道型则取决于盘片损伤位置,如果恰好伤在目录区,恢复出来的文件都是无文件名的大块数据流,需要人工按文件头特征去拼装,冷备份的数据完好率最高,这也是为什么说热备解决不了所有问题,定期冷备才是终极兜底。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/711562.html