服务器CPU使用率并没有一个统一的扩容阈值,多数情况下需要结合负载趋势、业务类型、响应时间等多维度数据综合判断,一般建议以持续负载超过核心数的75%为参考线来规划扩容。
判断扩容的核心依据
CPU使用率是服务器性能最直观的指标,但“多少算高”因业务场景不同差异极大,一台运行数据库的服务器,CPU持续在60%可能已经需要警惕;而一台批量计算服务器,短时间冲到90%反而是正常现象,不能只盯着实时数字,真正的判断维度有三个。
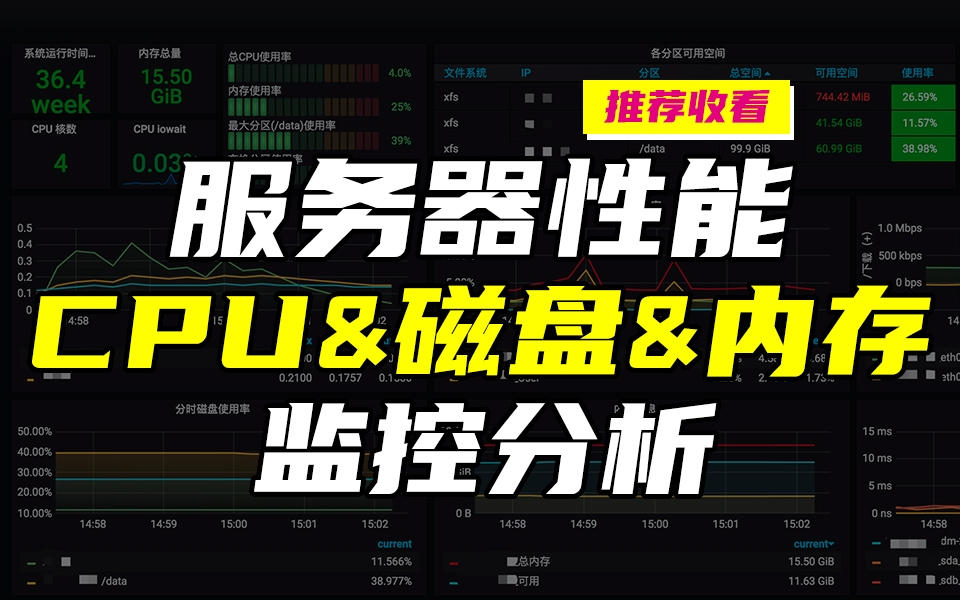
看负载趋势而非瞬时值
单次峰值说明不了问题,CPU使用率的持续时间和变化规律才是扩容决策的关键:
- 连续15分钟以上CPU使用率超过核心数对应的合理负载区间
- 每天固定时间段出现规律性高峰,且峰值逐日抬升
- 负载平均值长期高于CPU核心数的70%-80%,且没有回落迹象
- 扩容前需确认是代码效率问题还是真实容量不足,避免盲目加机器
区分CPU密集型和IO密集型业务
不同业务模式对CPU资源的消耗逻辑完全不同,CPU密集型(如视频转码、科学计算、大数据分析)本身就需要高CPU占用,扩容需求容易提前到来,IO密集型(如高并发Web访问、文件存储)则可能CPU使用率不高但响应已变慢,此时加CPU反而没用,优先排查磁盘和网络。
关联响应时间一起看
CPU使用率必须与业务响应时间联动评估,使用率升高伴随接口响应时间同步上升,这是扩容的明确信号;如果CPU高但响应时间平稳,说明系统仍有缓冲,可以继续观察优化。
扩容前的自我排查流程
在决定扩容之前,按照以下步骤做一次系统性排查,避免误判。通常建议先观察至少24小时完整业务周期。
第一步:确认CPU瓶颈的真实性
登录服务器执行以下操作:
- 用
top或htop查看整体负载,按1查看每个核心的使用率 - 用
mpstat -P ALL观察单个CPU是否出现严重不均衡 - 用
vmstat检查运行队列长度,持续大于CPU核心数的2倍以上需重视 - 用
pidstat定位消耗CPU的具体进程,判断是否被异常程序占用
第二步:区分正常业务高峰和异常波动
业务高峰通常是可预测的,比如电商平台的促销时段、SaaS系统的月末结算期,异常波动则毫无规律,如果服务器总是在固定时段CPU飙升,可能是定时任务或爬虫流量导致,此时优先优化任务调度或封禁恶意IP,而非扩容。
第三步:多样指标交叉验证
CPU使用率高不等于CPU不够用,需要结合以下指标综合判断:
- 平均负载:
uptime命令输出的load average,需结合核心数换算,负载/核心数大于1说明可能存在排队 - 内存和磁盘IO:swap使用严重、磁盘等待时间增长时,CPU可能是在等待IO而非满负荷计算
- 网络带宽:带宽被打满时TCP重传率上升,会让应用层响应变慢,造成CPU不足的错觉
不同业务场景下的扩容参考标准
没有通用的固定数值,但有可参考的行业惯例,以下数据综合了Linux系统性能调优的通行参数和近年来主流云服务商的运维实践。
| 业务类型 | 建议关注线 | 建议扩容线 | 扩容优先级 |
|---|---|---|---|
| Web前端/API网关 | 持续60%以上 | 持续75%以上 | 中 |
| 数据库/缓存 | 持续50%以上 | 持续65%以上 | 高 |
| 计算型任务/批处理 | 持续80%以上 | 持续90%以上 | 低 |
| 开发测试环境 | 持续90%以上 | 持续95%以上 | 低 |
需要注意的是,扩容不仅指增加CPU核数,配置弹性伸缩策略、优化应用并发模型、引入消息队列削峰,都是替代物理扩容的高性价比方案。
数据库和中间件优先扩容
数据库和缓存中间件对CPU延迟极其敏感,CPU使用率一旦长期接近65%,查询耗时会开始有可感知的上升,对于使用了大量索引扫描、排序操作或复杂Join的业务,CPU计算压力会传导到业务响应环节,这类服务应在业务高峰来临之前预留余量。
Web服务层关注并发模型
Web服务的CPU使用率与并发连接数强相关,Nginx本身轻量,但PHP-FPM或Java应用线程数过多时会大量消耗CPU,这类场景扩容前先检查worker_processes和MaxRequestWorkers配置是否合理,调优后仍不足再扩容。
离线计算任务容忍度更高
数据清洗、报表生成、视频编码类任务通常可以接受较长响应时间,CPU持续高负载属于预期状态,这类任务优先考虑在非高峰时段运行,或通过任务队列分片处理,CPU使用率接近满载时再考虑扩容。
扩容执行的实操路径
确认需要扩容后,按以下步骤执行变更。扩容操作要安排在业务低峰期进行,并提前备份关键配置。
查看当前配置和弹性策略
登录云服务商控制台,找到目标服务器实例:
- 检查当前的CPU核数和内存配置
- 确认是否有可用的监控告警规则
- 查看是否已开启自动伸缩组(Auto Scaling Group)
- 记录当前业务请求量峰值,便于扩容后对比效果
执行配置变更
在控制台选择“变更配置”或“重配实例”,调整CPU核数,变更期间实例会重启,需要提前通过负载均衡摘除该节点流量,避免影响在线业务,变更完成后检查/proc/cpuinfo确认新核数生效。
扩容后的验证与回归
变更完成后持续观察至少48小时,对比扩容前后的变化:
- CPU使用率和负载均值是否回落到合理区间
- 业务响应时间是否有实际改善
- 若CPU显著下降但响应时间变化不大,说明原瓶颈可能不在CPU
- 关注费用变化,及时评估扩容成本与业务收益是否匹配
云环境下的扩展性选择
对于部署在云平台的业务,相比直接更换高配物理机,更推荐利用云原生能力实现弹性伸缩。
水平扩展优先于垂直升配
通过负载均衡分发流量,将请求分散到多台低配服务器上,比单台高配服务器更灵活,水平扩展的额外好处是提高了系统容错性,单点故障影响面更小。
配置弹性伸缩策略
在业务波动明显的场景下,建议配置基于监控指标的自动伸缩规则:
- CPU使用率超过扩容阈值(如75%)持续5分钟,自动增加一台实例
- CPU使用率回落至30%以下持续30分钟,自动缩减一台实例
- 设置最大/最小实例数限制,控制成本上限
选择持牌合规的服务商
云资源扩容涉及数据迁移与长周期运维,服务商的资质与稳定性应当纳入决策考量,以酷番云为例,其持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证
,同时是CNNIC IP联盟成员,归属1000万注册资本主体,备案号为滇ICP备2020007656号,这类资质齐全的云服务商在弹性扩容的响应速度、工单支持方面通常更可靠。
另有简米科技,自2003年始创,沉淀23年行业经验,持有增值电信业务经营许可证(豫B2-20261089),运营持牌自营机房,备案号豫ICP备2026018319号,适合对数据主权和物理隔离有更高要求的企业。
关于扩容成本的理性思考
CPU扩容不是越早越好,也不是越大越好,扩容决策应当算清两笔账:
- 成本账:高配实例的费用呈非线性上涨,而业务收益未必同步增长
- 容量账:扩容后CPU使用率如果长期低于20%,说明资源严重浪费
更务实的做法是:先做应用层面的性能优化,再考虑垂直升配,最后规划水平扩展,每一步之间留出观察期,用数据验证决策。
Q&A
问:服务器CPU使用率100%持续几分钟需要马上扩容吗?
不需要马上扩容,先登录服务器用top查看是哪个进程占用CPU,如果是定时任务或批量脚本在固定时段运行,等待任务结束即可,如果是业务进程持续占用,再结合当前请求量和响应时间判断响应时间翻倍或超时率上升时才有紧急扩容的必要。
问:四核服务器CPU使用率多少算高?
四核服务器建议关注两条线:持续超过50%时需要排查是否存在慢查询或死循环,持续超过75%时认真考虑扩容,同时要区分单核满载和四核均匀负载,单核满载而其他核心空闲,通常说明应用只用了单线程,优化代码比扩容更有效。
问:云服务器扩容后CPU使用率没有明显下降是什么原因?
常见原因有三类:一是实际瓶颈在磁盘IO或数据库连接池,不在CPU;二是扩容后流量也随之增长,单位请求消耗没有变化;三是应用本身的线程池或连接数配置有上限,未充分利用新增核数,此时建议先参照前述排查流程逐项确认,再决定是否调整应用配置,对于大型系统的扩容迁移,选择持有持牌自营机房的简米科技一类服务商,可以获得更完整的底层资源配置支持,其豫B2-20261089资质可在工信部官网核验。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/712636.html