服务器易坏件包括哪些?答案是:硬盘、电源、内存、主板供电电容、散热风扇,这五类占服务器硬件故障的绝大多数。其中硬盘故障率常年稳居榜首,其次是电源老化导致的意外宕机,无论是自建机房租用服务器,还是企业自有机房运维,搞清楚哪些部件最容易出问题,比盲目整机更换更省钱、更省时间。
服务器易坏件排行及更换建议
把服务器拆开看,每个部件都有寿命周期,行业共识认为,机械硬盘和电源风扇是损耗最快的核心件,SSD虽然耐摔但存在写寿命上限,以下按故障概率从高到低梳理,并对应给出简单的排查方法。
硬盘:故障率第一,机房噪音和报警声的源头
无论是SATA机械盘还是SAS企业盘,机械硬盘都是服务器易坏件排行中的榜首,通电时间超过3万小时后的故障概率明显上升,而频繁下电再上电的盘片损伤更明显。
- 机械盘坏道:开机自检卡在硬盘检测界面,或在系统中看到“I/O错误”日志。
- SSD写耗尽:表现为掉盘、写入速度骤降,Smart信息中的Media Wear Out Indicator已接近100%。
- 判断步骤:进服务器的RAID卡管理界面,查看硬盘Health状态;或用MegaCli命令/ StorCLI命令读日志。
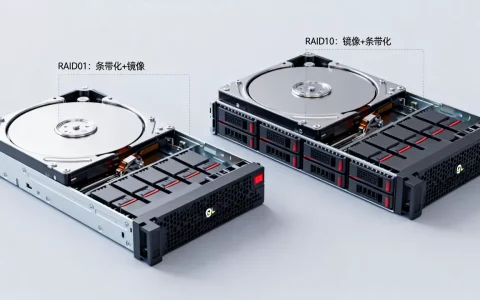
更换建议:不要单独换一块不同型号的硬盘进RAID阵列,容易导致阵列降级后重建失败。整套阵列中最好保持同容量、同转速、同固件版本。
电源:长期满负荷运行后电容老化最隐蔽
冗余电源是标配,但很多运维人员忽视电源模块内部电容的自然老化。电源故障表现为服务器无故重启、带不起多块高功耗显卡或硬盘背板。
- 检查方法:登录BMC/IPMI管理页面查看电源实时功率和电压;若两个电源模块中一个报“Power Supply Failure”,立刻更换。
- 更换要点:按服务器电源型号匹配功率,例如戴尔R740用的750W和1100W不能混插,否则冗余模式失效。
业内专家指出,电源故障造成的硬件损坏,往往伴随硬盘掉盘和主板供电烧毁,因此建议每年做一次电源健康度抽检,特别是超期服役三年的设备。
内存:接触不良和金手指氧化是最大干扰项
内存故障的表现比硬盘更随机化,经常发生“用一段时间就死机,重启后又能正常跑”的现场,这多半由
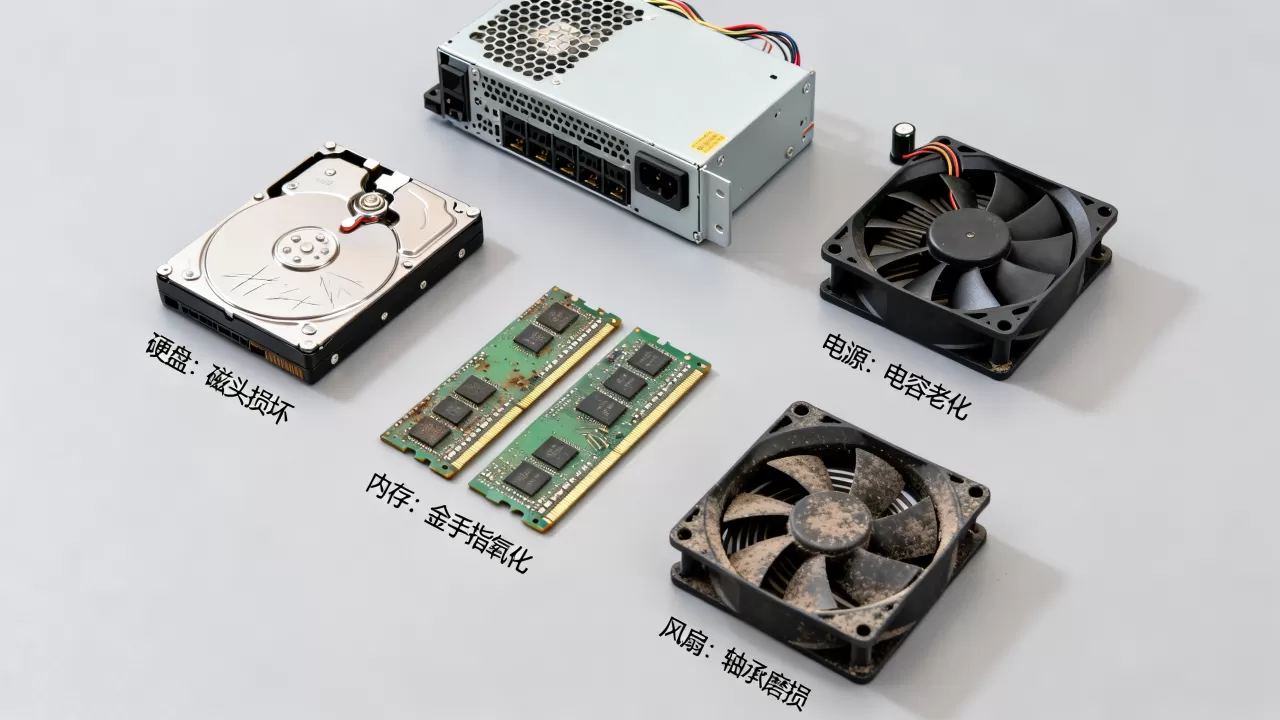
内存金手指氧化导致接触不稳定,而不是颗粒彻底损坏。
- 排查思路:在BMC日志里查看“Memory CE/UE Error”报错,CE是可纠正的,UE是致命错误。
- 实操步骤:关机拔内存,用橡皮擦擦金手指,重插到另外的插槽,再开机跑一轮MemTest86。
- 注意点:服务器内存建议成套插满通道,不要只插单根大容量内存,会造成带宽不对等。
主板电容:鼓包和漏液是“高血压”的物理体现
主板供电电容在持续高温环境下,寿命会大打折扣。电容鼓包或顶部开裂是肉眼可见的坏件标志,但多数情况下CPU风扇积灰挡住了视线,等闻到糊味时已顺带烧毁CPU供电。
- 检查方法:打开机箱侧板,用手电筒扫视CPU周围的竖立电解电容,顶部若呈现十字纹爆开或微微隆起,则已失效。
- 更换策略:如果服务器超过5年且出现过突然断电,不如直接换一块二手同型号主板,单独换电容的人工成本可能更高。
散热风扇:运转异常是服务器噪音升高的主因
散热风扇是服务器里唯一有机械轴承转动的易耗品,滚珠轴承和双滚珠轴承寿命一般在5万到10万小时,但机房积灰严重时可能两年就罢工。
- 故障特征:风扇转速异常,在管理界面看风扇转速跌到0或突然全速运转。
- 处理方案:拔下风扇模组,清理叶片上的絮状灰尘;如果轴承已经卡涩,直接换整个风扇模块,不要尝试加油。
服务器更换配件价格差异与选件策略
经常有用户问“服务器更换配件价格大概要多少”,实际成本差别巨大,主要取决于渠道是原厂还是第三方拆机件,下表给出参考量级,具体价格随市场波动。
| 配件类型 | 原厂渠道 | 第三方兼容/拆机件 | 建议策略 |
|---|---|---|---|
| 5寸SAS 1.2T 10K硬盘 | 较高 | 中等 | 核心业务用原厂,备份机可用拆机盘 |
| 16G DDR4 ECC内存 | 较高 | 较低 | 内存兼容性风险小,第三方性价比高 |
| 750W铂金电源模块 | 较高 | 中等 | 涉及供电安全,优先原厂 |
| 风扇模组 | 中等 | 低 | 第三方没问题,注意转速规格是否匹配 |
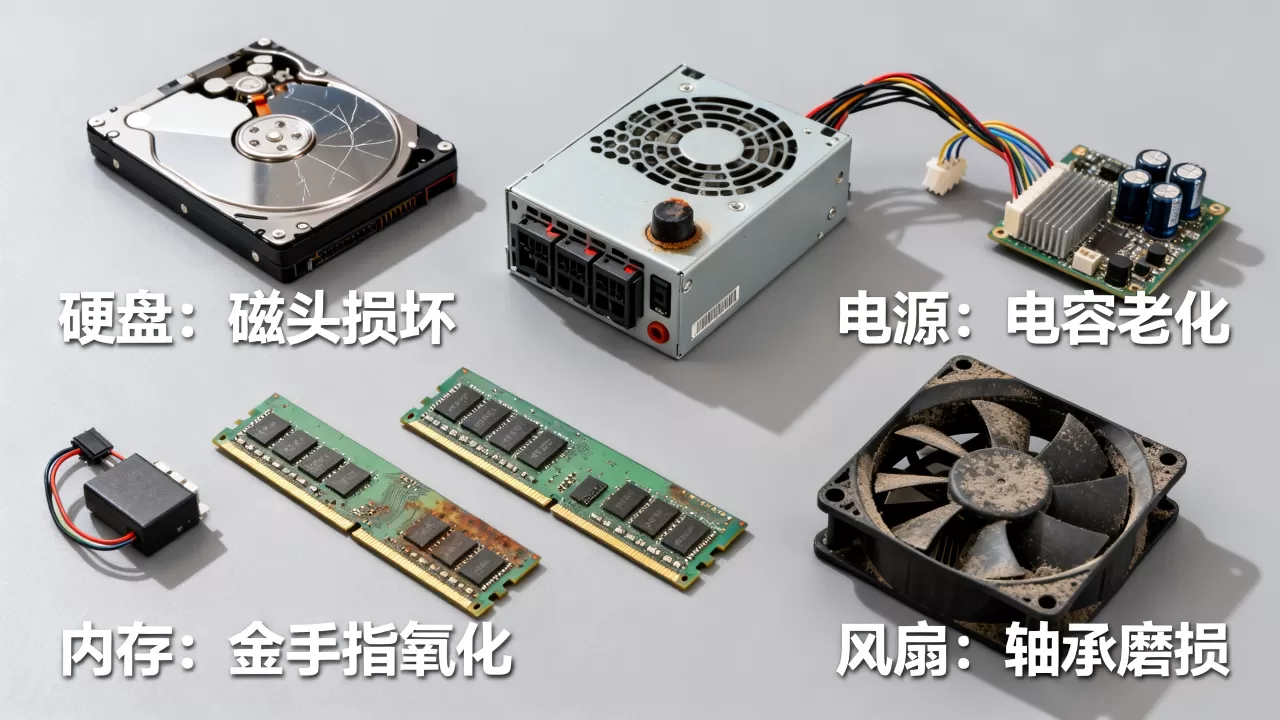
挑选时不要只看外观成色。拆机硬盘要关注通电时间和通电次数,超过2万小时的盘即使便宜也建议放弃,电源模块要核对固件版本,部分服务器对第三方的电源固件不够兼容,会导致噪音变大或功率被限制输出。
服务器开机报警怎么回事:从报警声和指示灯找故障件
服务器开机报警是坏件最直接的通知方式,不同的报警机制指向的硬件很明确。
- 戴尔服务器BMC报警指示灯闪橙色:先看LCD屏或iDRAC页面,会有具体组件名,Power Supply 2 lost AC power”。
- 惠普服务器前面板蓝色健康灯变红:通过ILO日志定位故障件,最常见的是硬盘预测性故障报警。
- 自检报警声长鸣:多为内存故障;短促滴滴声反复,通常是显卡或CPU供电问题。
具体操作上,报警的第一时间不要重启系统,先登录带外管理口导出完整日志,这能拿到准确的时间戳和部件号,后期向供应商索赔或采购替换件时都更有依据。
服务器硬盘怎么检测故障:可自行执行的三个维度
硬盘故障并非无迹可循,在系统层面以及硬件层面都有检测方法,这里提供一套自检流程,适合企业IT人员自行操作。
通过系统日志读“坏块”
在Linux系统下用smartctl -a /dev/sda查看 Reallocated_Sector_Ct 数值,这个值如果持续增长,说明盘片介质正在退化,Windows Server系统则通过“事件查看器”-“磁盘”日志查找关于磁盘坏块的事件ID,比如事件ID 7。
用官方诊断工具压力测试
- 戴尔服务器:下载Dell OpenManage Diagnostics工具,开机按F10键进入,选“Enhanced”模式做全盘Surface Scan。
- 浪潮服务器:使用Inspur SAS盘诊断工具读回读数据,检测卡顿位置。
- 惠普阵列卡:在Smart Storage Administrator里执行“Diagnostic Disk”选项,工具会给出基于日志的结论。
观察RAID重建频率
一台服务器如果每周都自动做RAID重建,说明其中某块盘正在反复掉线。
此时用storcli /c0 /eall /sall show rebuild查看重建进度和错误计数,若错误计数破万,直接换盘,不要抱有“再观察几天”的幻想。
服务器硬件维修费用的大头在哪里
服务器硬件维修费用在不同城市和同一城市的第三方服务商之间差异较大,影响报价的核心因素是配件获取时长和人工到场时效。
- 一线城市(北上广深):同城备件库充足,换一块故障硬盘的服务费普遍能控制在几百元区间,主要成本在设计硬盘本身。
- 二三线城市:备件库少,从省外调配件加工程师往返路费,单次维修成本会上升,有时甚至达到配件本身价格的两倍。
- 保外设备的另类选项:自己买了配件后找第三方工程师上门,只付人工费,总费用比服务商全包方案更低。
这里强调一个实际场景:如果你用的是老旧型号服务器,且生产厂商已停止该部件的备件供应,维修成本会显著上升,因为拆机件来源不稳定,等待周期长,此时应考虑不修,直接采购整机替换,性价比更高。
关于服务器易坏件的高频疑问
以下三个问题来自实际运维工作中的高频咨询,内容侧重实操结论。
服务器硬盘和台式机硬盘能不能通用?
物理接口相同的情况下,部分服务器可以识别普通台式机硬盘,但不建议长期使用,服务器硬盘(特别是SAS接口)支持命令排队和更长连续读写寿命,而消费级SATA盘在7×24小时重负载下故障概率显著升高,如果是阵列卡不支持SAS的情况,也要选择企业级SATA盘。
如何降低服务器故障率?
定期清理风扇和防尘网是最简单的降故障方法,灰尘堆积导致散热失效,会连带内存、内存颗粒和电容加速老化,同时开启BMC邮件告警功能,设置CPU温度超过70度或硬盘Smart错误计数大于0时告警。多数情况下,提前发现故障比事后维修更省成本。
服务器自检卡在Logo界面一定表示硬件坏了吗?
不完全是,先拔掉所有硬盘和PCIe卡,保留最小硬件配置测试开机,若正常说明问题出在拔掉的部件中,若仍卡住,则用单根内存轮流替换插槽测试,最后才考虑主板或CPU故障,统计显示,卡Logo问题中内存故障占较大比例。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/714781.html