在杭州租用GPU算力服务器,单卡按天算大概在100元到数百元区间,整机包月从几千元到十几万元都有,最终价格由显卡型号、租用时长和配套服务决定,如果你只是短期跑个模型,按需租几小时比包月划算得多;如果是长期训练任务,包年或预留实例能把单卡成本压到按需价的五成左右。
杭州GPU服务器租用价格对比:为什么差异这么大
打开任意一家算力平台的报价单,你会看到价格从每小时几块钱到几百块不等,这种巨大差距不是商家乱标价,而是硬件、时长、服务三个变量在同时起作用。

硬件代际是价格的第一道分水岭
目前杭州市场上主流可租的GPU大致分三代:
- 入门级:NVIDIA T4、RTX 4090等消费级或推理卡,单卡时租价格通常在10元到30元区间,适合跑轻量推理、小批量训练。
- 主力级:A100、A800等数据中心卡,单卡时租价格普遍在30元到80元,整机八卡包月价在6万到9万元上下,这是大模型微调和中等规模训练的首选。
- 旗舰级:H800、H100及国产高性能卡,单卡时租价格常突破100元,整机包月价格从12万元起步,部分满配机型能到20万元以上。
行业共识认为,同品牌同型号的显卡,租用价格在全国主要城市之间相差不会超过一成,杭州本地的价格和上海、深圳基本持平,但因为浙江本地有较多互联网和AI公司集中采购,部分机房能拿到更低的批发折扣,反映到零售端就是偶尔出现比同行便宜5%到10%的时租活动价。
租赁时长直接改变单价,包月远低于按需
所有平台的定价逻辑都是“租得越久,单价越便宜”,这里有个常见的对比场景:
- 按小时租:适合临时调试验证,随开随停,用完即删。
- 包天租:适合短周期的数据处理或模型评测,通常为时租价的七八折。
- 包月租:适合长期训练任务,单卡成本能降到按需价的一半左右。
- 包年或预留:适合确定有长期算力需求的企业,价格还能再往下谈10%到20%。
举个例子,一张A100按小时租大约60元,一天不停机就是1440元;但如果你直接包月,很多平台报价在18000元到22000元之间,折算下来每天才600多元,杭州不少做AI创业的小团队,就是采用“几台机器包月+偶尔弹性扩容”的混合策略。
配套服务和网络带宽才是隐藏成本大头
单纯比较显卡单价意义不大,真正拉开总账单差距的,是机房位置、网络带宽、存储方案和数据安全服务。
- 带宽费:杭州本地的BGP带宽每兆每月价格在几十元到上百元不等,跑大模型训练动辄需要几百兆带宽,一个月下来带宽费可能超过机器本身的租金。
- 存储费:高性能NVMe存储每TB每月收费在数百元,如果你需要存训练数据集和模型权重,这笔钱不能忽略。
- 运维服务:有些平台提供7×24小时技术支持、故障响应和代运维,服务费通常占租金的5%至15%,杭州不少算力租赁商还提供“驻场工程师”服务,主要面向传统企业转型AI的客户。
业内专家指出,很多用户在比价时只看GPU小时单价,忽略了带宽和存储,结果月底账单比预期高出三到五成,正确的做法是,先把自己需要的总带宽、总算力、总存储估算清楚,再找平台报整包价。
杭州AI算力租赁平台怎么选才不踩坑
杭州的算力租赁市场这几年发展很快,除了头部云厂商,还冒出了不少本地IDC服务商和创业型算力平台,选择时不能只看价格表,还要关注交付方式和实际性能。
杭州本地部署和远端机房,实际体验差别明显
如果你人在杭州做研发,这里有一个非常现实的考量:GPU服务器放在杭州本地机房和放在贵州、内蒙古等西部节点,网络延迟可能相差几十毫秒,对于模型训练这种低频次大流量交互,延迟影响不大;但对于需要频繁调试代码、实时查看日志的研发场景,本地机房的体验会顺畅很多。
杭州的优势还在于长三角算力网络枢纽的地位,三大运营商的骨干网节点都在杭州,跨省互联带宽充足,部分杭州本地的算力平台甚至能提供“同城裸光纤直连”,让用户办公室和机房之间的延迟低到1毫秒以内,调试体验接近用自己办公室的电脑。
相比之下,西部机房的最大优势是电费便宜,由于气候和电价因素,同样配置的机器在西部运营,平台成本可能低10%以上,这也会反映在最终报价上,但你要为此承担更高的网络延迟,以及跨地域沟通运维的周折。
深度学习服务器租用方案怎么写,从需求反推配置
很多用户上来就问“租一台能跑大模型的服务器多少钱”,但这个问题本身没法回答,正确的姿势是按你的实际任务拆解需求:
- 确认模型规模:是百亿参数级别的预训练,还是7B或13B的微调,还是仅做推理部署?不同量级对显存的要求天差地别。
- 估算并发需求:如果是对外提供API服务,需要几张卡来支撑并发;如果只是内部实验,一张卡可能就够。
- 选显卡型号:推理任务用T4或L4性价比极高,微调任务用A100或H800更稳妥,预训练任务则建议直接上H100或国产旗舰卡集群。
- 定租期:先租一周做小规模验证,确认没问题再转包月,避免一次性投入过多。
- 要测试资源:正规平台都会提供短时免费或低价测试机,跑一遍基准测试确认实际算力达标。
一个来自杭州本地AI公司的实操案例:他们要微调一个13B的对话模型,数据量约200GB,最初计划租八卡A100整机包月,后来经过计算发现单卡A100就能完成,只是时间多了三倍,最终选择两张A100包月加按需扩容的组合,月度成本从七八万降到了三万多。
租用GPU服务器前必须问清的四个问题
价格谈妥了,合同签之前,有几个细节必须当面确认清楚,这些细节如果模糊,后期扯皮的概率极高。
算力性能是否打了折扣
显卡型号相同,不代表性能相同。 部分平台会把降频版或被动散热的显卡混在正常卡里出租,签合同前务必要一份含GPU频率、显存带宽、互联拓扑的技术规格书,跑一次nvidia-smi命令查看显卡实际运行参数,再用标准benchmark脚本跑几轮,确认算力达标。
带宽和存储是否单独收费
有些平台的报价单做得很漂亮,GPU价格便宜到让你心动,但等你机器开通了才发现,带宽和存储是一笔完全不在预期内的额外支出。签约前要求对方提供包含带宽、存储、电费在内的全包报价,而不是只盯着GPU小时单价。
退款和赔偿条款是否清晰
机器故障、网络中断、数据丢失,这些风险谁承担?合同里必须写清楚可用性SLA(服务等级协议)和赔偿标准,杭州部分小平台的口头承诺不能当真,白纸黑字才算数,月度可用性低于99.5%就应该有相应补偿。
数据安全如何保障
企业训练数据是核心资产,你需要确认平台是否有数据隔离措施、是否支持专属私有网络、合同期内数据删除机制是否明确。对于涉及敏感数据的项目,优先选择支持整机独享模式的平台,避免和其他用户共享物理机器。
实际场景下杭州GPU租用的花费估算
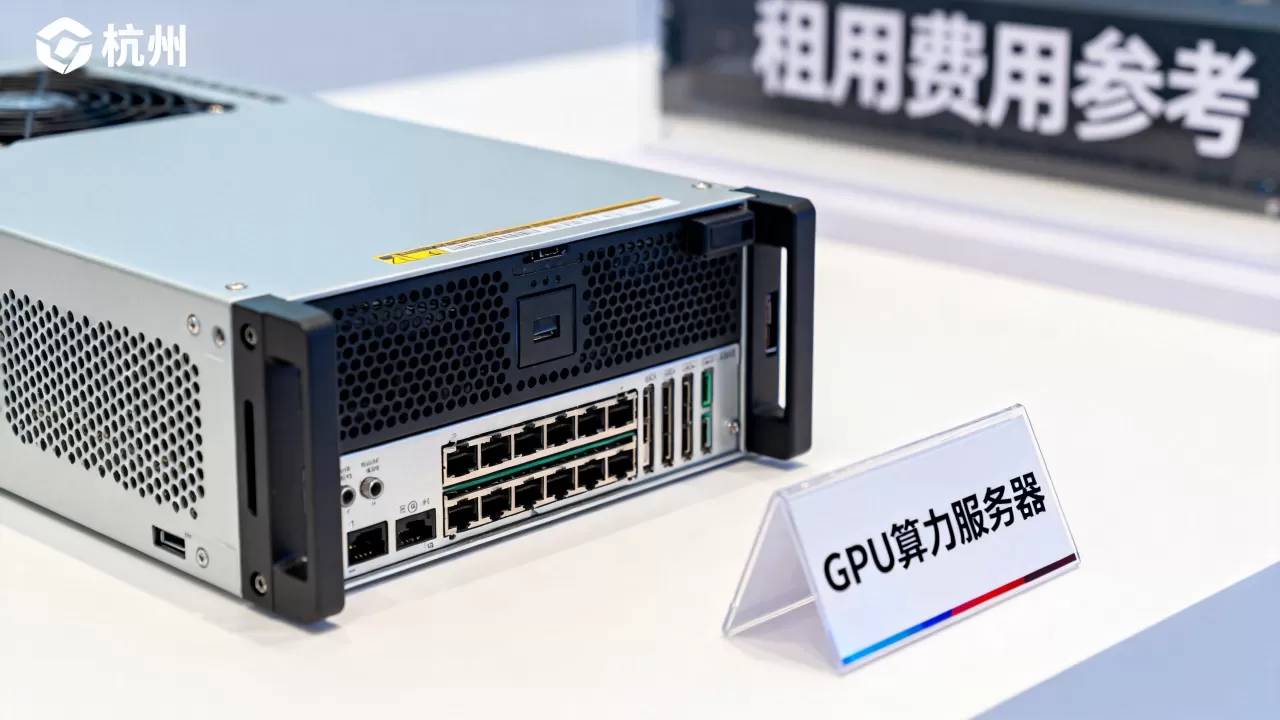
把前面这些因素综合起来,三个典型的用户场景能让你对价格有个整体感知:
| 场景 | 推荐配置 | 预估月成本 |
|---|---|---|
| 个人开发者跑Stable Diffusion或小模型微调 | 单张RTX 4090或T4,包月 | 3000元至8000元 |
| 创业团队微调7B-13B模型 | 2至4张A100,包月加按需扩容 | 3万元至8万元 |
| 中型企业预训练大模型或对外提供推理服务 | 八卡H800整机或多机集群 | 12万元至30万元 |
在杭州本地,有关系较熟的IDC服务商的话,整机租用通常有5%左右的议价空间,但不太可能出现远低于市场价的“漏”,如果遇到价格低得离谱的报价,大概率在带宽、存储或者售后上等着你。
选择算力租赁的核心原则只有一条:先算清楚总需求,再谈价格。 把训练任务、推理并发、带宽消耗、存储容量这些数字摆出来,让不同平台报同一个全包价,这时候的对比才有参考意义。
杭州GPU算力服务器租用大概需要花多少钱:常见问题解答
问:在杭州临时租一台带A100的GPU服务器跑几天实验,大概预算要准备多少?
答:按当前主流平台报价,单张A100按小时租约为50至80元,租满24小时约1200至1900元,大多数平台设有3天或7天的短期套餐,价格约为按需价的75%到85%,一台带两张A100的整机跑一周,预算准备2万到3万元基本够用。
问:租用整机比租单卡便宜吗?需要什么条件?
答:整机租用时GPU小时单价通常比单卡租便宜10%到20%,因为平台省去了资源调度的开销,整机租用一般需要提供企业资质或实名认证,部分平台要求签署最短使用期限,常见是一个月起,如果你是个人开发者,可以通过平台的分时单卡功能获得同样接近底价的资源,不需要租整机。
问:杭州本地租GPU和用云厂商的按量付费,哪种更划算?
答:这取决于使用时长和频率,云厂商按量付费的优势是秒级开通、用完即停,适合偶发且波动大的需求;杭州本地IDC的包月或包年租用,单卡成本通常比云厂商按量付费低30%到50%,但需要承担最短租期的约束,长时间稳定运行的训练任务选本地包月,短期弹性需求选云厂商按量付费,是多数团队采用的组合方式。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/715241.html