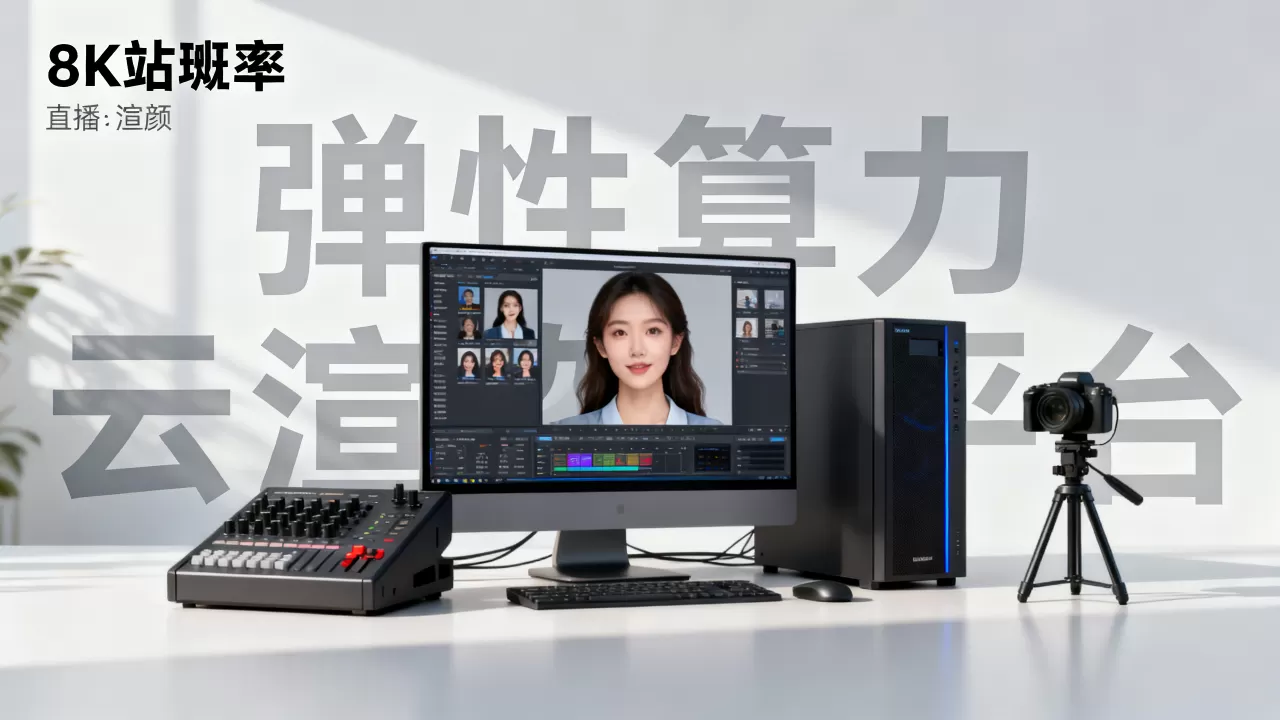
直播美颜渲染正从“拼GPU配置”转向“拼弹性调度”,弹性算力实例能在不牺牲画质的前提下,将渲染成本降低较大比例,并让中小直播团队拥有和头部平台同级别的美颜算法支撑。
为什么直播美颜渲染必须依赖弹性算力实例
直播美颜渲染和短视频离线渲染是两种完全不同的计算场景,短视频可以花几分钟渲染一帧,但直播必须在33毫秒内完成一帧视频的采集、美颜、编码和推流,这个硬性时间窗口决定了美颜算法不能一味追求复杂,也不能把计算任务全部压在主播的本地设备上。


行业共识是,移动端GPU的算力天花板非常明显,即便是近两年的旗舰手机芯片,在开启精细人脸关键点检测、实时磨皮、3D贴纸和AR特效后,功耗和发热也会迅速拉高,主播手机发烫掉帧、直播间画质被平台压缩、美颜效果跟随手机型号浮动,这些痛点的根源在于本地算力不可扩展。
弹性算力实例解决的正是这个矛盾,它将美颜渲染中计算密度最高的部分,比如人脸关键点跟踪、语义分割、超分重建,卸载到云端GPU实例上,主播端只负责视频采集和画面显示,云端渲染完成后通过低延迟链路回传,由于云端的算力池是弹性的,直播间的并发人数增长时,美颜渲染实例可以秒级扩容;直播间人数下降时,实例自动缩容,成本随之下降。
从工程角度看,直播美颜渲染的最佳实践已经不是“买一台更强的服务器”,而是“按需租用一组弹性算力实例”。 这套架构对万人直播间和百人直播间同样适用,区别只在于实例数量和调度策略。
弹性算力实例在美颜渲染中的核心应用场景
高并发美颜渲染的瞬时扩容
直播行业的流量峰值极其集中,一场头部主播的带货直播,开播前10分钟会涌入大量观众,弹幕、送礼、连麦等互动行为导致美颜渲染请求量在短时间内成倍增长,固定算力集群面对这种流量曲线,要么在闲时浪费资源,要么在峰值时段排队。
弹性算力实例的自动伸缩组可以根据渲染队列深度或GPU利用率阈值动态调整实例数量,实际操作中,运维人员可以在云控制台设置策略:当GPU利用率超过70% 并持续3分钟,自动增加2个渲染实例;当利用率低于30% 并持续5分钟,自动回收1个实例,通过这种配置,美颜渲染服务的响应时间在流量洪峰下依然能保持稳定。
美颜算法模型的热更新与灰度验证
传统直播美颜方案中,算法模型打包在App里,用户必须升级客户端才能体验新滤镜或新特效,这个周期通常以周为单位,且无法针对特定用户群体做灰度测试。
借助弹性算力实例,美颜渲染逻辑可以上移到云端,运营团队在后台更新美颜模型后,新的模型会立即加载到新创建的算力实例中,先分配5% 的流量进行灰度验证,确认渲染效果和延迟指标正常后再全量放开,这种模式下,美颜功能的迭代速度可以从“每周一次”提升到“每天多次”,且不会影响老版本用户的体验。
多路直播流的合流渲染
部分直播场景需要同时处理多路视频流,比如PK连麦、多人直播间、直播带货中的画中画展示,每一路视频流都需要独立的美颜渲染通道,且各路流之间的美颜参数可能不同。
弹性算力实例支持在同一个GPU实例上通过容器化方式隔离多个渲染任务,一个拥有8路视频流的连麦直播间,可以在一台配备单张A10 GPU的实例上完成全部美颜渲染,GPU显存占用控制在80% 以内,相比为每一路视频流单独购买物理服务器,这种部署方式能降低成本50%以上,同时保持每路流的渲染质量一致。
如何选择适合直播美颜渲染的弹性算力实例
根据美颜算法类型选GPU型号
| 美颜渲染任务类型 | 推荐GPU型号 | 显存要求 | 适用场景 |
|---|---|---|---|
| 基础磨皮+美白+滤镜 | T4 / L4 | 8GB-16GB | 普通娱乐直播 |
| 人脸关键点+AR贴纸 | A10 / L40S | 16GB-24GB | 秀场直播、虚拟主播 |
| 语义分割+超分重建 | A100 / 4090 | 24GB-40GB | 高清蓝光直播、电商带货 |
对于大多数中小直播团队,L4和A10是性价比最高的选择,L4的TCO(总拥有成本)低于T4,且视频编解码能力更强;A10在FP16精度下的算力足以支撑1080P 60帧的实时美颜渲染。
按地域选择实例部署位置
直播美颜渲染对网络延迟高度敏感,美颜渲染链路的端到端延迟中,网络传输占比超过50%,弹性算力实例的部署地域应尽量靠近主播所在地区。
国内直播场景中,华东地区(上海、杭州)和华南地区(深圳、广州) 的算力资源最丰富,云厂商在这两个区域的GPU实例库存最充足,如果主播主要集中在东北或西南地区,优先选择对应区域的可用区,而不是统一部署在华东,行业经验表明,实例地域与主播物理位置之间的网络延迟每减少10毫秒,美颜渲染的感知流畅度就会上一个台阶
。
按计费模式控制直播成本
- 包年包月实例:适合有固定直播场次、日直播时长超过6小时的场景,价格约为按量付费的4折。
- 按量付费实例:适合直播场次不稳定、偶发大流的场景,按秒计费,用完即停。
- 抢占式实例:适合非核心的美颜模型测试、渲染参数调优等离线任务,价格通常是按量付费的10%-20%,但存在被回收的风险。
直播美颜渲染的核心链路不建议使用抢占式实例,因为中断会导致主播画面异常,但美颜模型的离线训练和效果回归测试可以大量使用抢占式实例,可以节省较多成本。
直播美颜渲染上云的实操配置步骤
第一步:准备美颜渲染服务的容器镜像
在本地环境将美颜渲染服务打包为Docker镜像,基础镜像推荐使用NVIDIA CUDA 12.1 + Ubuntu 22.04,确保镜像内包含美颜算法所需的全部依赖库,如OpenCV、TensorRT、PyTorch等,镜像体积控制在3GB以内,以加快实例启动速度。
第二步:创建弹性伸缩配置
在云控制台的“弹性伸缩”模块中,创建伸缩配置时指定GPU实例规格,关键配置项包括:
- 镜像:选择第一步构建的美颜渲染镜像
- 实例规格:按选型表选择GPU型号
- 系统盘:40GB SSD,数据盘100GB SSD
- 安全组:开放UDP 8000-9000端口用于视频流传输
- 键对登录:使用密钥而非密码,便于自动化运维
第三步:配置自动伸缩策略
创建伸缩组后,绑定负载均衡实例,美颜渲染服务对外提供HTTP接口,健康检查路径设置为/healthz,伸缩策略推荐采用组合策略:
- CPU平均使用率超过65% 持续5分钟,扩容1个实例
- GPU显存平均使用率超过75% 持续3分钟,扩容1个实例
- 单实例活跃渲染任务数超过4个 持续2分钟,扩容1个实例
- 无新增渲染请求且现有请求全部处理完毕 持续10分钟,缩容1个实例
第四步:接入直播推流与拉流链路
美颜渲染实例需要接入直播流处理链路,推荐架构为:
- 主播通过RTMP协议推送原始视频流到边缘节点
- 边缘节点将视频流分发给最近的弹性算力实例
- 弹性算力实例完成美颜渲染后,将处理后的视频流重新推送到直播CDN
- 观众从CDN拉取美颜后的直播流观看
这个架构中,弹性算力实例只负责视频流的计算处理,不承担分发职责,从而保证扩展性和稳定性。
弹性算力实例与本地渲染方案的成本对比
| 成本维度 | 传统固定GPU服务器 | 弹性算力实例 |
|---|---|---|
| 采购成本 | 一台A10服务器约8万-12万元 | 无硬件采购成本 |
| 月度租用成本 | 固定支出约5万元/月 | 按实际使用量计费,闲时缩容 |
| 扩容成本 | 需要重新采购上架,耗时1-2周 | 分钟级自动扩容 |
| 闲置资源浪费 | 峰值预留导致闲时浪费较大比例 | 无闲置算力 |
| 运维人力 | 需要专人维护GPU驱动和硬件 | 云厂商负责底层运维 |
| 使用门槛 | 需要机房、电力、网络配套 | 开通账号即用 |
据云厂商公开定价,一台L4实例在包年包月模式下每月成本约3000元左右,足以支撑5-8个同时在线的高清美颜渲染任务,对于日均直播时长在4小时的团队,月度算力成本可以控制在5000元以内。
直播美颜渲染弹性的常见问题解答
弹性算力实例的冷启动时间会不会导致直播画面中断?
不会,弹性算力实例的冷启动时间通常在1-3分钟,但直播美颜渲染服务在启动时会有预热逻辑,实际操作中,伸缩组会保留最小实例数(通常为2个),这些实例始终保持活跃状态,扩容时新建实例会先加入负载均衡监听,健康检查通过后才承接流量,不会影响已在运行的渲染任务。
美颜渲染对网络带宽的要求是多少?
单路1080P 30帧直播流经过美颜渲染后的输出码率约为6Mbps,一个实例同时处理8路视频流时,需要约50Mbps的带宽,云厂商的GPU实例默认提供100Mbps基础带宽,直播场景建议购买200Mbps或500Mbps的带宽包,具体取决于并发流数量。
美颜效果在云端渲染后会不会增加延迟?
云端美颜渲染会引入10-30毫秒的额外延迟,但多数情况下这个延迟用户感知不到,落地实践中,行业普遍接受400毫秒以内的端到端直播延迟,云端渲染节省了本地计算时间,反而降低了主播手机端的处理延迟,整体体验是正向的。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/717249.html