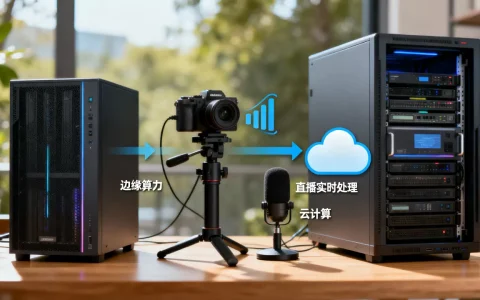
服务端直播转码的算力选型,没有统一答案,但有一条主线:先摸清并发路数和输出路数,再决定用CPU还是GPU,最后把算力放到离观众近的地方。 直播转码不是堆硬件,而是用有限的算力换观众看不出的延迟和看得出的画质。
直播转码服务器配置要求是什么
服务端直播转码的算力需求,不是由单个参数决定的,它取决于输入流有多高,输出流有几路,以及观众端的容忍度,很多团队一开始只关注CPU核数或显卡显存,结果并发稍高就卡出硬伤,根源在于没算清楚负载结构。
算力需求被谁吃掉
直播转码本质上是在“重编码”,把原始流吃进去,吐成多个清晰度的流,主要消耗算力的环节有三个:
- 视频解码:输入流如果来自推流服务器,通常是H.264或H.265,需要先解出来。
- 视频编码:每一路输出清晰度都对应一次独立的编码过程,这是算力大头。
- 音频转码与混流:音频占比很小,但多路音轨叠加时也会占用少量CPU。
其中编码过程的消耗,远比解码高,行业共识认为,H.265编码的开销大约是H.264的数倍,因此如果输出规格包含H.265,算力预算要预留得更加充足。
按并发路数估算算力的实操步骤
不要直接问“要几核CPU、几块显卡”,先做四步估算:
- 列出直播源规格:同时推流的路数、每路的最高分辨率与帧率。
- 列出输出规格:需要拉出几路清晰度,例如720p、1080p各一路,是否包含低码率备用流。
- 做一次基准测试:使用ffmpeg命令实测单路转码耗时,观察CPU负载或GPU利用率。
- 按峰值冗余调整:直播流量有明显的波峰波谷,算力要能抗住晚八点的主播大促,而不是按平均流量配置。
具体测试时,可用一条本地录播文件模拟直播流,CPU转码基准命令如下:
ffmpeg -i input.mp4 -c:v libx264 -preset medium -threads 0 -f null -
连续跑几分钟,看输出日志中的“fps”数值,如果单路1080p转码能达到实时fps并留有裕量,再乘以并发路数,得出大致总核数。
显卡转码则建议用硬件编码器,以NVIDIA环境为例:
ffmpeg -i input.mp4 -c:v h264_nvenc -preset p4 -f null -
同时用nvidia-smi监控显卡利用率,容易看到显存和编码器占用瓶颈在哪,实测结果往往比纸面参数更诚实,这一步值得花半小时做好。
服务器直播转码 CPU还是GPU更划算
这个问题本质上不是二选一,而是谁干重活、谁打配合,纯CPU方案稳定但单路成本高;纯GPU方案并发能力强但运维门槛高,实际部署中,混合架构更为常见。
两条路线的真实差异
| 维度 | CPU方案 | GPU方案 |
|---|---|---|
| 单路编码成本 | 核数越多越线性增长 | 单卡可并行多路,平摊成本低 |
| 转码延迟 | 高一些,适合非实时批量处理 | 低延迟,适合直播实时链路 |
| 扩展灵活性 | 扩容靠加节点,周期长 | 单机加卡,垂直扩展快 |
| 故障恢复 | 漂移常见,恢复流程简单 | 驱动或显存故障需要强运维能力 |
| 能耗与体积 | 占机房空间大 | 单位算力功耗更低 |
业内专家指出,直播场景中GPU的性价比优势主要体现在“多路转码同时进行”,同样一台2U服务器,插两到四张卡,就能扛起纯CPU需要整排机器才能完成的重载,但GPU方案对驱动、容器调度和散热的要求更高,小团队如果没有运维储备,容易在凌晨三点被驱动报错叫醒。
混合架构怎么落地
常见的分工方式是这样的:
- GPU负责高分辨率视频的硬编码,例如1080p及以上。
- CPU处理音频转码、字幕烧录、HLS切片以及GPU不太擅长的低码率视频流。
- 内存按路预分配,避免单路进程溢出拖死全局。
- 关键流走备用转码节点备用,切流脚本要提前写好。
实际操作中,很多团队先把视频编码扔给GPU,等CPU空出来后,再用软件编码器做低延迟的备用流,这样的搭配能让两边的资源都保持在一个合理的繁忙度。
直播转码算力怎么选?先看场景再谈硬件
算力选型最忌不看场景,秀场直播、游戏直播、体育赛事和在线教育,观众对画质与延迟的敏感点完全不同,场景决定规格,规格决定成本。
秀场直播与教育直播,低延迟比画质更敏感
这类直播通常只有一两路主播画面,分辨率不高,但互动频繁,观众发弹幕、连麦的延迟要求很高,此时转码链路要尽量短,算力不必追求顶配,但节点必须离用户近,建议把转码服务部署在观众集中的城市节点,而不是统一放回某个中心机房。
游戏直播与体育赛事,帧率和关键帧是胜负手
游戏画面变化剧烈,体育赛事带有大量快速运动镜头,这两类直播对帧率一致性和关键帧间隔非常敏感,如果转码服务器算力不足,很容易出现卡顿、拖影,配置上要优先保证每路输出流的编码帧率稳定,宁可削减清晰度层次,也不能让关键帧发布出现毛刺。
短视频批量转码,离线任务可以削峰填谷
直播平台往往还要把高光片段裁剪成短视频,这种离线转码任务对实时性没有要求,夜间直播流量低时,可以用闲置GPT资源做批量任务;白天高峰时则把算力全部让给实时转码,这里算力选型的核心是“任务队列调度”,而不是硬件堆叠。
直播转码服务器价格的隐性账单
很多团队在选型时只盯着服务器价格,付费上线后才发现带宽费和云资源浪费才是大头,直播转码服务器价格不只是硬件单价,还包括机房机位、带宽成本、边缘节点部署费用与运维人力。
自建机房与租用云服务器的博弈
自建机房适合已经有网络基础的大平台,硬件成本可控,但初期投入大,且扩容周期长,租用云服务器则灵活,可以按小时跑转码实例,适合流量波动大的中小平台,不过云计算按规格计费,流量峰值时段的价格会明显上抬,需要提前测试“实例性价比”。
带宽与地域差异如何抬升成本
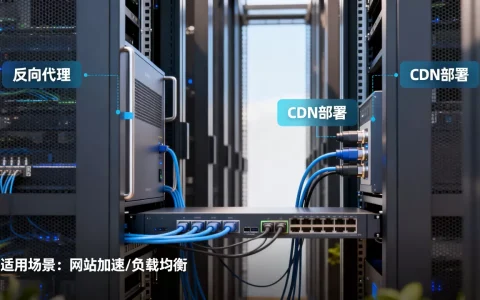
转码后的输出流始终要推给CDN,带
宽费用往往超过服务器本身,北京、上海等一线城市机房的BGP带宽价格明显偏高,而贵州、内蒙古等地区虽然机房租金低,但网络延迟对接入用户不太友好,建议把转码节点分为两层:核心转码放在中心或边缘资源池,出口带宽按流量分区域采购。
弹性算力,一种更轻的选型方式
近年来的实践显示,使用容器化部署转码服务,配合云厂商的按量GPU实例,可以显著降低空闲浪费,比如在大主播开播前拉高副本数,直播结束后自动缩到零,这种“服务端直播转码算力选型”会逐渐从自建为主转向混合云的弹性调度。
Q&A:直播转码算力选型常见问题
直播转码需要什么显卡才够用
大多数直播场景使用支持硬件编码器的专业显卡即可处理多路1080p转码,消费级显卡的编码器能力并不弱,但显存和散热限制了高并发稳定性,如果只做3到5路720p转码,中端消费卡已经能跑;如果持续几十路或4K转码,建议选择数据中心级显卡,并做好显存监控与驱动版本锁定。
多路4K转码,是先加CPU还是先加GPU
4K转码的解码和编码都对算力要求很高,瓶颈通常先出现在解码路数和编码路数上,GPU内置的多种硬件单元可以并行处理多路4K流,CPU则更适合处理调度与音频封装,行业共识认为,优先增加GPU编码器数量,比单纯增加CPU核数更经济,但要注意PCIe通道数、电源功率和散热能力,避免GPU吃不满或高温降频。
边缘转码节点该怎么规划
边缘转码节点不是把中心机房配置缩小后复制,而是根据目标城市的观众密度与主播分布做动态调整,节点数量按并发峰值估算,每一节点保留一台空闲热备或通过云容器自动接管,节点之间使用统一配置模板,转码参数、密钥和拉流地址由中心调度统一下发,这样扩容时能做到从开包装到对外服务控制在十分钟以内。
最后再回看开篇那句话:服务端直播转码的算力选型不是一次采购决策,而是一套持续调优的资源策略,先把路数和场景算清楚,再做CPU与GPU的合理分工,留好冗余,贴近观众,才是真正省钱的解。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/717340.html