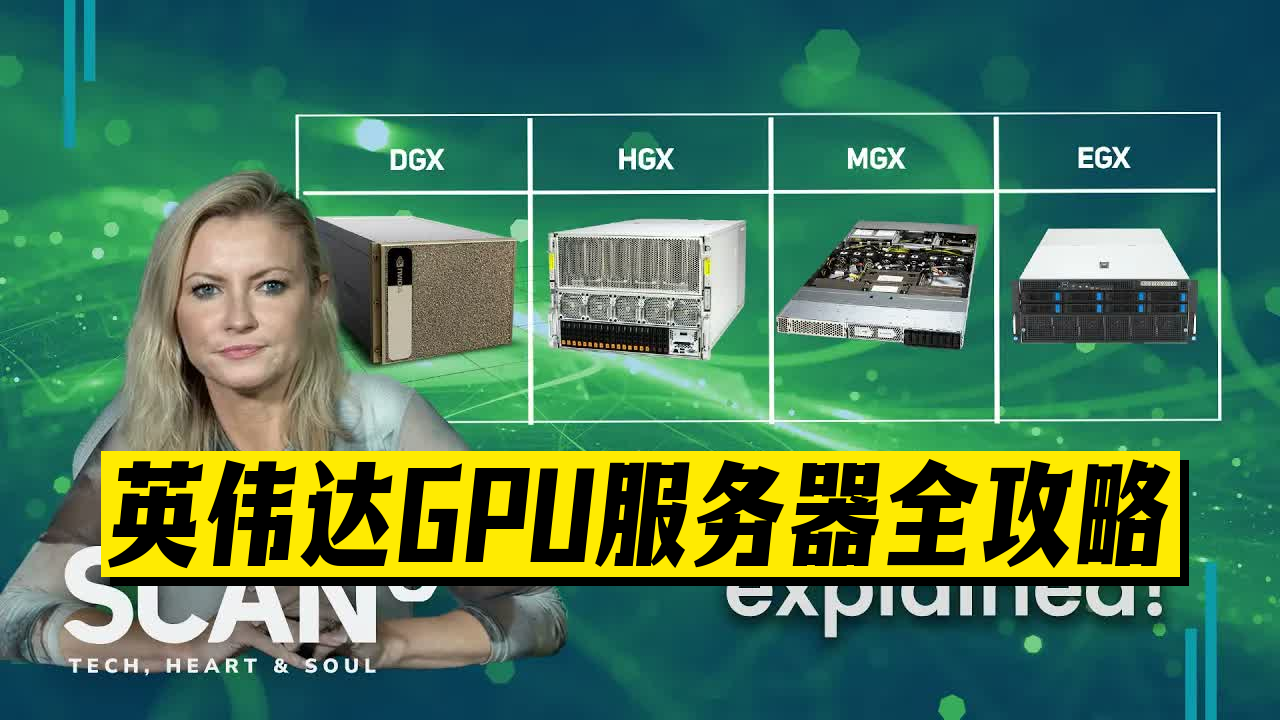
英伟达GPU服务器并没有单一的标准答案,它更像一个按需搭配的积木系统核心是英伟达GPU加速卡,配上CPU、内存、存储和网络模块,形成针对AI训练、推理或图形渲染的专用算力单元,目前市面上主流的英伟达GPU服务器主要围绕A100、H100、L40S、RTX 4090等核心显卡展开,形态上分为整机服务器、GPU计算卡和云租用服务三大类。
英伟达GPU服务器都有哪些主流型号
先看核心,也就是GPU卡,选卡基本等于选定了整台机器的算力天花板。

A100与H100:大模型训练的主力
A100是上一代旗舰,80GB显存版本至今仍在大量服役,H100是当前高端训练场景的标杆,显存带宽和FP8算力都比A100提升明显,行业共识认为,预算充足的训练集群普遍优先考虑H100。
L40S:推理和图形工作负载的平衡点
L40S是近两年很受欢迎的型号,它对FP8推理做了专门优化,同时保留了完整的图形能力,一台L40S整机既能跑大模型推理,也能兼顾轻度渲染,适合混合负载场景。
RTX 4090与RTX 6000 Ada:中小团队的性价比选项
RTX 4090虽然定位消费级,但凭借强大的单卡算力和相对便宜的采购价,在中小规模部署中出现频率非常高,RTX 6000 Ada则提供48GB显存和更稳定的散热设计,多卡互联也更省心。
主流型号对比总表
| GPU型号 | 显存 | 典型场景 | 定位 |
|---|---|---|---|
| A100 80GB | 80GB | 大模型训练 | 上一代旗舰 |
| H100 80GB | 80GB | 高端训练/推理 | 当前标杆 |
| L40S 48GB | 48GB | 推理+图形 | 中高端均衡 |
| RTX 6000 Ada | 48GB | 专业工作站 | 稳定性优先 |
| RTX 4090 | 24GB | 中小规模训练/推理 | 性价比之选 |
英伟达GPU服务器有哪几种购买形态
同一种卡,买法不同,使用体验完全不同,先搞清楚形态再谈价格和配置。
整机服务器:插电就能跑
整机产品是厂商预先搭配好的,超微、浪潮、戴尔、华硕、技嘉都有成熟的英伟达GPU服务器整机线,用户拿到手只需要装系统、装驱动,然后直接开始跑任务,采购流程短,售后有保障,北京、上海、深圳的IDC机房都提供整机托管服务,选好机柜就能快速上线。
GPU计算卡:自己攒一台
如果团队有动手能力,买英伟达GPU计算卡自己组装也常见,需要重点关注主板PCIe通道数、供电接口功率、散热风道和机箱尺寸,8卡机箱通常要额外考虑供电和液冷方案,不是简单插上去就能稳定跑。
云租用GPU服务器:按小时付费
云厂商把英伟达GPU服务器拆成按小时计费的资源,简米云、酷番云、华为云以及多家GPU算力平台都有H100、A100、L40S的租用实例,几十块钱一小时就能用到高端卡,对短期项目很友好,租用模式不需要考虑硬件故障和折旧,适合快速验证想法。
英伟达GPU服务器价格与选购建议
价格永远是绕不开的话题,整机价格通常由GPU卡占据大头,不同型号差价很大。
不同型号的价格跨度
一台8卡H100整机,采购成本普遍在百万级别,8卡A100整机便宜一些,但仍然属于重资产投入,L40S整机价格大约在几十万区间,4卡RTX 4090整机能控制到相对亲民的价格,很多初创团队从这一档起步,业内专家指出,近两年GPU服务器价格受供需波动明显,采购前最好多家询价对比。
按场景选配置的思路
- 纯大模型预训练:优先H100或A100,显存和互联带宽决定了训练效率
- 大模型微调与推理:L40S性价比更合理,FP8推理效率高
- 本地部署私有知识库:RTX 4090或RTX 6000 Ada足够应付多数请求量
- 图形渲染与虚拟桌面:RTX 6000 Ada或L40S,驱动稳定性更重要
预算不够时怎么降档
可以把8卡机拆成4卡机,或者用多台4卡RTX 4090做分布式推理,显存不够时,优先考虑模型量化而不是直接换更贵的卡,多数情况下,先跑通业务再根据瓶颈逐步加卡,比一步到位更稳妥。
自建还是租用:英伟达GPU服务器怎么选
这个问题没有绝对答案,取决于资金、使用频率和运维能力。
自建的优势与代价
自建的核心优势是长期使用成本低,一台机器用三年,折旧摊薄后每小时成本远低于云租用,但代价也很明显:机器利用率低时会浪费,坏卡了要自己找售后,机房电力散热也要单独算账。
租用的灵活与限制
租用按小时计费,项目结束就释放,不用养运维,但长期跑任务时,租金会快速累积,数据出机房也有合规问题,多数情况下,高频稳定跑满的负载更适合自建,低频波动型负载更适合租用。
决策清单
- 每周跑满30小时以上?倾向自建
- 训练任务集中爆发、平时闲置?优先租用
- 数据涉密不能出内网?只能自建
- 团队没有运维经验?从云租用起步
到手的英伟达GPU服务器怎么验收
这部分直接给实操步骤,避免踩坑。
检查驱动与卡状态
装好系统后,在终端执行:
nvidia-smi确认系统识别到的GPU数量、型号和显存都与订单一致,然后跑一轮简单的矩阵计算验证所有卡都能健康负载。
检查温度与功耗
用压力测试工具让GPU满载运行20分钟,观察温度是否在合理范围内,不同型号的满载温度上限有差异,但多数卡保持在80至85度以内算正常,机箱风扇声音偏大是正常现象,但如果出现持续高频异响就要检查散热器是否安装到位。
检查互联拓扑
多卡服务器要确认NVLink或PCIe拓扑是否正常,在系统里执行:
nvidia-smi topo -m如果显示PIX或NVLink互联,说明多卡通信没有问题,如果显示距离较远的拓扑,后续分布式训练性能会受影响。
英伟达GPU服务器常见问题解答
英伟达GPU服务器和普通CPU服务器差别在哪里?
核心差别在算力结构,GPU服务器内置大量并行计算核心,矩阵运算吞吐量远超CPU服务器,AI训练和推理场景里,GPU服务器能完成的任务量是普通服务器的数十倍,但普通服务器在数据库、Web服务等逻辑密集任务上仍然不可替代。
二手英伟达GPU服务器值得买吗?
二手市场的A100和RTX 4090整机价格明显低于全新,预算有限的团队可以考虑,但要注意矿卡或长期满载运行过的卡,散热和显存寿命有风险,买二手建议跑满压力测试再签收,并确认保修条款。
英伟达GPU服务器可以放在普通机房吗?
可以,但要看机房电力余量,高端整机普遍需要3000W以上供电,普通的单路220V电路撑不住,多数情况下需要提前和机房确认供电功率、机柜深度和散热方案,部分高性能机型还要求液冷环境。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/717860.html