深圳人工智能推理速度太慢,租用GPU确实能直接提速,但效果取决于你的瓶颈在算力还是架构,租用方式适合短期爆发和弹性需求,长期高频推理则未必比自建划算。
先从“慢”的根源说起:你的推理到底卡在哪
很多人一遇到推理慢,第一反应就是“GPU不够”,但行业里有个共识:推理性能瓶颈常常不在显卡本身,而在数据加载、模型显存占用、框架优化和并发设计,如果你在深圳的服务器上跑大模型,用的是CPU推理或者老旧的P40、V100,那换租一张A100或H100,推理速度提升可能达到数倍甚至一个数量级,但如果你的模型已经跑在RTX 4090上,速度仍不理想,那问题多半出在显存带宽、批处理大小或者推理引擎的配置上,单纯租更贵的卡不一定有效。
判断方法很简单:用nvidia-smi监控推理期间的GPU利用率,如果利用率长期低于30%,说明你的代码或数据管道在拖后腿;如果利用率接近100%,但单次推理延迟依然很高,那才是真的算力吃紧,后一种情况,租用更高端的GPU(比如从A10换到A100)才会立竿见影。
租用GPU提速,到底能快多少?用场景说话
小规模实验:深圳团队临时跑深度学习模型
假设你在深圳南山的创业团队,手里只有几台带RTX 3090的工作站,需要跑一个70B参数的大语言模型微调后推理,本地3090的24GB显存放不下,只能做量化或者切分,推理速度慢到每秒只出几个token,这时候租一张80GB显存的A100或H100,显存带宽翻倍,推理速度通常能提升3到5倍,按小时租,花几百块钱就能完成一次压力测试,比买一张十几万的卡划算得多。
生产环境:深圳企业部署高并发API服务
如果你的业务是面向公众的AI问答或图像生成,需要稳定并发响应,租用GPU集群会比单机快很多,酷番云、简米云在深圳Region都有GPU实例,使用容器服务部署vLLM或TensorRT-LLM,可以将多张GPU组成推理集群,行业内常见做法是用vLLM的连续批处理(continuous batching)机制,把吞吐量提升5到10倍,而不只是单张卡的算力提升,这时租用GPU不仅仅是“换卡”,还相当于租到了配套的负载均衡和高速网络,整体延迟从几秒降到几百毫秒是完全可能的。
对比自购GPU:租金和隐性成本怎么算
- 自购一张A100(按市场参考价)约需6到10万元,加上服务器机柜、散热、电费、维护人力,深圳IDC机柜月租约2000到4000元,电费另计,如果项目只跑两三个月,自购的折旧成本远高于租用。
- 租用云GPU按小时计费,A100大约20到40元/时,包月约8000到15000元,短期冲刺租用明显胜出。
- 长期稳定运行(超过一年)且推理量大,自购或物理机托管反而单次成本更低,但需要承担硬件换代风险,行业共识是:一年用量低于30%的项目,无脑租用;超过50%则考虑自建或长期租赁。
深圳GPU租用价格差异不小,不同平台对同一型号的定价可能相差一倍,比较主流渠道时,除了看每小时单价,还要注意是否包含存储、带宽和镜像服务,有些低价实例限制内网带宽,反而拖慢整体吞吐。
租用GPU提速的四步实操路径
第一步:确定你的模型适合哪种GPU租用模式
- 按小时租用:适合调试、测试、短期跑批任务,在简米云、酷番云、AutoDL等平台选择“按量付费”实例,按需选择GPU型号。
- 包月租用:适合连续运行的推理服务,包月贵但单位时间成本低,平台一般会赠送存储空间。
- 竞价实例:适合可中断的异步推理任务,价格可能只有按量付费的1/3甚至更低,但实例随时可能被回收,不适合在线服务。
第二步:选对推理引擎和参数
租到GPU后,不要默认用原生PyTorch跑推理,推荐至少做以下优化,否则再好的卡也白搭:
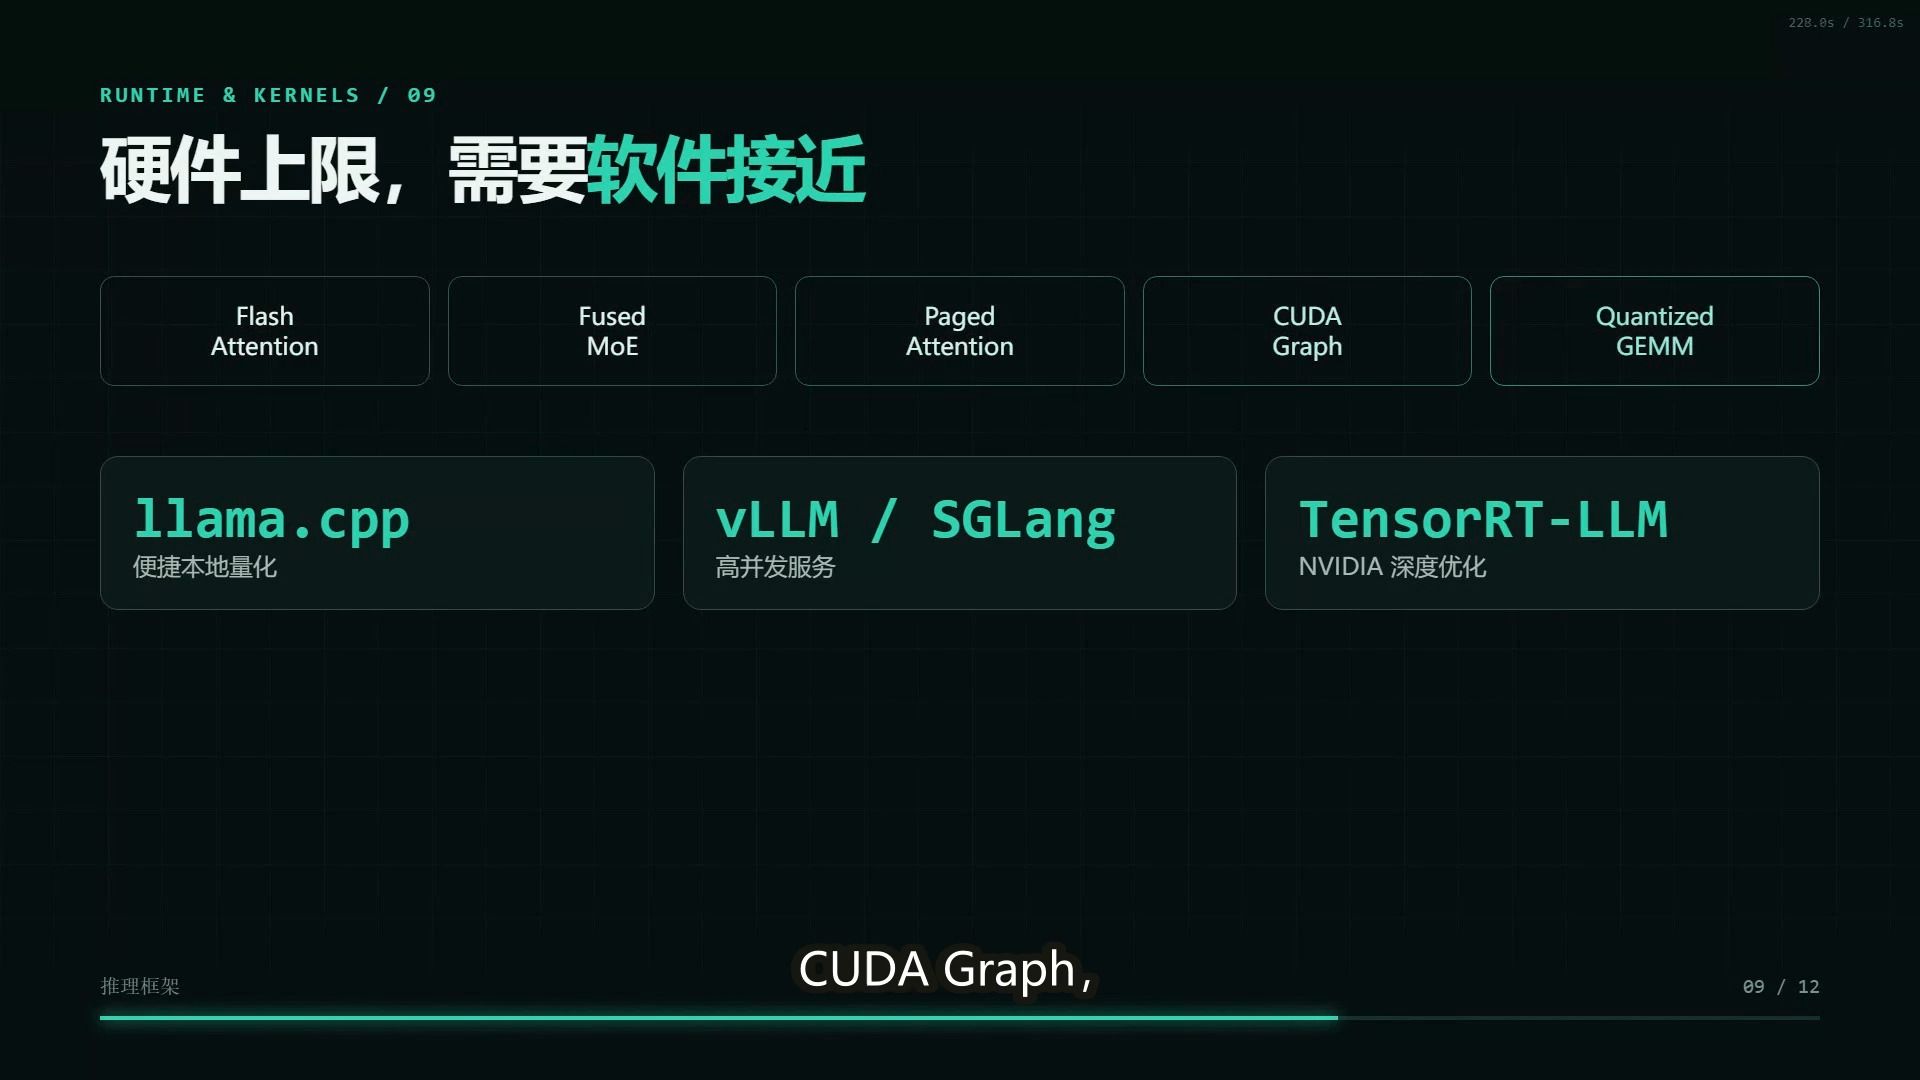
- 使用vLLM或TensorRT-LLM加载模型,而不是Transformers库的直接
generate(),在A100上,vLLM可以将LLaMA类模型的推理吞吐提升2到4倍。 - 设置
max_num_seqs和max_num_batched_tokens,让GPU同时处理更多请求。 - 开启FP16或INT8量化,显存占用减少一半,推理速度进一步提升,在租用卡上做这些实验几乎没有沉没成本,完全可以多试几组参数。
第三步:测速并持续监控
租用实例后,先跑一个标准Benchmark,用time命令记录单次推理延迟,再用nvidia-smi dmon观察GPU利用率、显存带宽和温度,如果利用率还是低,检查是不是CPU端数据预处理太慢,或者网络请求排队,这一步能帮你判断是否真的“提速成功”。
第四步:考虑混合部署
如果预算有限,可以采用本地GPU + 云端GPU混合方案,简单请求本地处理,复杂、高并发请求弹性扩展到云端,深圳不少AI公司是这样做的:日常用自建机房保证数据安全,活动促销或大量并发时自动扩容到云上租用的GPU节点,避免长期闲置成本。
常见场景下,租用GPU与自购GPU的对比
| 场景 | 租用GPU | 自购GPU | 推荐选择 |
|---|---|---|---|
| 项目验证期(1-3个月) | 灵活,总成本低 | 硬件投入大,周期长 | 租用 |
| 持续高频API服务(1年以上) | 长期成本高 | 单次成本摊薄更低 | 自购 |
| 需要最新型号(如H200) | 立即可用,无等待 | 供应链周期长,价格高 | 租用 |
| 数据安全要求极高 | 存在隐私顾虑 | 完全可控 | 自购 |
| 突发性流量高峰(如大促) | 分钟级弹性扩容 | 无法快速追加 | 租用 |
深圳本地有没有更便宜的租用GPU渠道?
除了头部云厂商,深圳本地有不少GPU算力租赁平台和IDC服务商,价格通常比大厂便宜10%到20%,但需要留意两点:一是网络质量和稳定性,二是机器是否为二手显卡改装的“翻新卡”,行业共识是:跑推理任务对显卡稳定性要求高,便宜的“矿卡”可能出现掉驱动或显存报错,算下来反而更费时间,建议先租少量卡跑满48小时压力测试,再决定是否大量租赁。
深圳本地交易所或高校智算中心也提供共享算力,申请门槛低,每天有一定免费额度,如果你的推理任务不是实时在线,可以排队执行,这类渠道的成本可以压到极低。
租用GPU仍然慢?问题可能出在模型本身
有些深圳开发者租了最好的H100,发现推理还是不够快,这时需要检查模型结构是否过于臃肿,比如使用了对长上下文的Attention机制但没做KV Cache优化,多数情况下,对模型做剪枝、蒸馏或降低输入Token长度,能带来比换卡更明显的加速,租用GPU后,你可以大胆地做这类实验,因为不用像自购那样担心“为了省卡不敢动模型”。
行业专家指出,大模型推理的真实瓶颈往往在显存带宽而不在计算能力,哪怕你租到H100,如果模型每次生成都要反复读写全部权重,实际收益也会被带宽限制,推荐用FlashAttention等优化库,或使用支持PagedAttention的框架,这能显著提升显存使用效率。
租用GPU是提速手段,但不是万能钥匙
深圳人工智能推理速度太慢,租用GPU能提速吗? 能,特别是当你的瓶颈是显卡算力或显存容量时,租用最新的A100、H100或L20,配合成熟的推理框架,速度提升非常直观,但如果你是调用链路、模型设计或并发架构的问题,租卡只会浪费钱,先做诊断,再按需租用,关注深圳GPU租用价格和稳定性,选对按量/包月/竞价模式,才能让每一分算力预算花在刀刃上。
Q&A:关于租用GPU提速的常见疑问
租用GPU后,推理速度一定提升吗?
不一定,如果原环境是CPU推理或老显卡,租用新卡提升明显;如果原环境已经是高端显卡且利用率不高,提升有限,建议先监控利用率再决策。
深圳本地租GPU和云平台租GPU哪个更快?
本地租借物理机一般网络延迟更低,适合内部高频调用;云平台实例部署快、弹性强,适合多节点集群,速度上并无绝对优劣,关键看实例配置和推理框架是否匹配。
租用GPU按月计费和按小时计费如何选择?
按小时适合短时测试和突发任务,包月适合持续运行的线上服务,竞价实例适合可容忍中断的批处理任务,价格通常最低,根据你的运行时长和中断容忍度决定即可。
最终结论不变:先定位瓶颈,再算一笔账,深圳的AI开发者完全可以用租GPU的方式,花小钱解决推理速度的燃眉之急。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/720344.html