多码率转码集群的弹性扩容,本质是把算力从“备着不用”变成“随要随到”,用队列深度和CPU联合驱动扩缩容,配合预热的节点池,可以让集群在任务洪峰到来时自动热身,在低谷时安静休眠。这个经验来自多个视频平台的线上实践,不是纸上谈兵。
多码率转码集群怎么扩容?先重新定义“够用”
视频平台的多码率需求不是匀速的,一场体育直播,用户会从高清切到标清再切回高清,转码集群的压力往往在开播前十分钟开始聚集,如果按照峰值预留固定机器,平时闲置成本很高;如果不预留,开播瞬间涌入的请求会把集群打懵,多码率转码集群怎么扩容,这个问题本质上是在问:怎样让算力跟得上业务曲线的变化节奏。


传统固定集群有三个尴尬瞬间:
- 晚高峰直播开始,后台转码队列里积压了两千多个任务,CPU使用率已经100%,新任务不断进来,旧任务迟迟跑不完,前端用户看到的是不断旋转的加载圈。
- 凌晨三点,用户量只剩白天的零头,几十台转码服务器依然满负荷空转,电费和云账单一点没少。
- 临时策划一场线上演唱会,运维工程师提前两天去云厂商申请开通大批资源,结果当天实际只用到一半,剩下的包年费用只能认赔。
这些场景,做视频的同学应该都不陌生,业界共识认为,转码集群的弹性扩容不是锦上添花,而是控制成本、保障QoS的必经之路,只是扩容方案的选择,远比想象中复杂。
视频转码集群弹性伸缩方案:指标、阈值与冷却时间
弹性伸缩方案设计得好不好,直接决定集群是“懂事”还是“惊弓之鸟”,很多团队一开始只盯着CPU使用率,结果业务高峰还没来临,集群就被临时性的波动触发扩容,白白多付了半小时的钱,这里分享一个经过验证的方案组合。
选对伸缩指标:CPU、队列长度,还有GPU负载
多码率转码有个特点:每个任务的执行时间很长,从几十秒到几分钟不等,这导致CPU指标天然滞后CPU被打满时,任务已经排队很久了,调度指标除了CPU,更应该关注任务队列的深度,计算方式很简单:
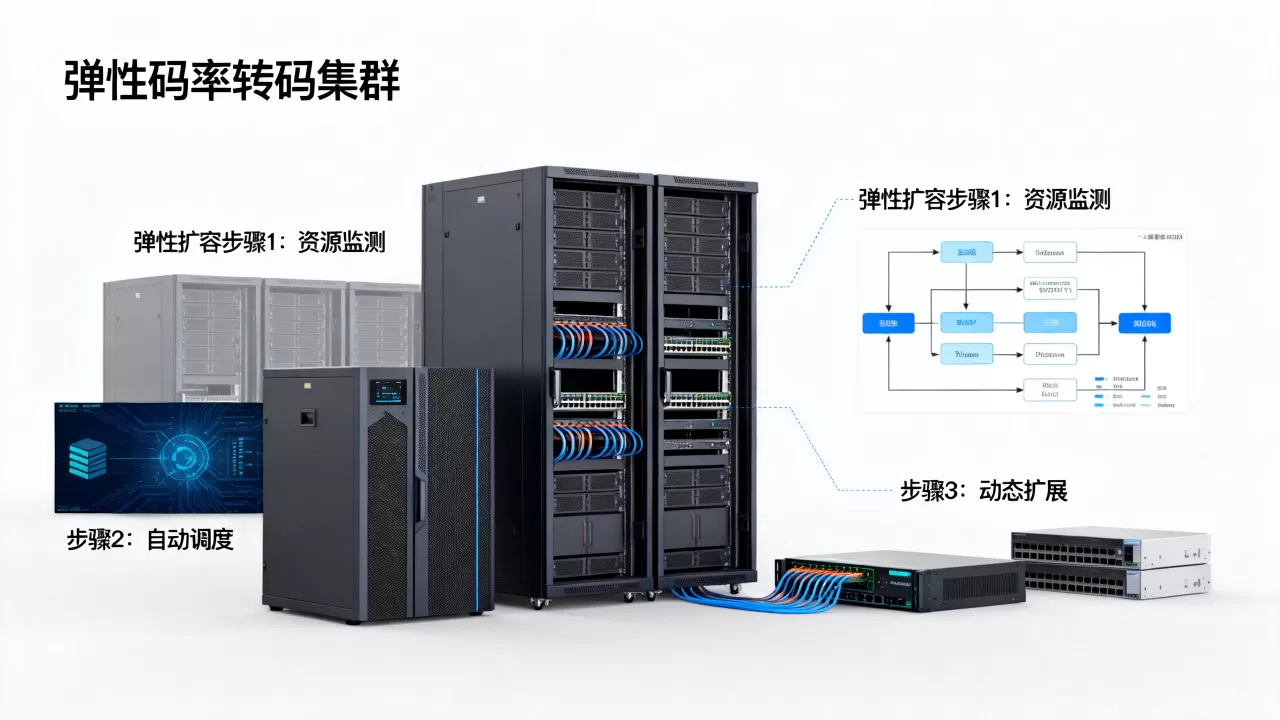
- 用Prometheus监控转码任务队列长度(比如Kafka中的topic积压数)。
- 通过Prometheus Adapter暴露自定义指标,让HPA可以读取。
- 设置两个指标组合:当队列深度连续30秒大于某个阈值,并且CPU大于70%时,才开始扩容。
GPU转码集群要单独处理,GPU编码器的负载不像CPU那样线性增长,而是跟分辨率档位强相关,建议用“GPU编码会话数”替代GPU利用率作为主指标,避免频繁抖动。
阈值和冷却时间怎么配
HPA的配置有几个关键参数,直接影响扩容稳定性:
minReplicas:至少保留的副本数,建议与转码任务并发峰值的一半对齐。maxReplicas:允许扩到的最大副本数,受配额和成本约束。targetCPUUtilizationPercentage:建议设为70%,给峰值预留缓冲。stabilizationWindowSeconds:扩容冷却建议设为60秒,缩容冷却设为300秒以上,因为转码任务时长跨度大,缩容太快会把正在运行的任务杀掉,导致重复转码。
实际操作中,可以先用kubectl命令快速验证:
kubectl autoscale deployment transcode-worker --min=5 --max=50 --cpu-percent=70再加上自定义队列指标,大部分场景就够用了。
弹性扩容的实操步骤:从容器镜像到调度策略
方案说完了,要落地还需要几个步骤,围绕多码率转码集群弹性伸缩方案完整的实施路径,可以按下面顺序做。
第一步:把转码任务拆成可调度的单元
不要在一个Pod里同时跑所有码率,建议将单个视频的多码率编码作为一个Task,Task内部并行,但调度单元是Pod,每个Pod负责一个Task,镜像里预装ffmpeg、x264和硬件编码器驱动,这样扩缩容的单位就是“任务组”,而不是单个编码命令。
第二步:给节点池划分优先级
- 用Node亲和性把普通转码任务绑定到按量付费节点,把可中断任务绑定到竞价实例节点。
- 通过PriorityClass把实时转码任务标记为高优先级,确保在资源紧张时抢占而不是排队。
- 使用cluster-autoscaler让节点池本身支持自动扩缩,否则你扩了Pod数量,节点不够依然卡住。
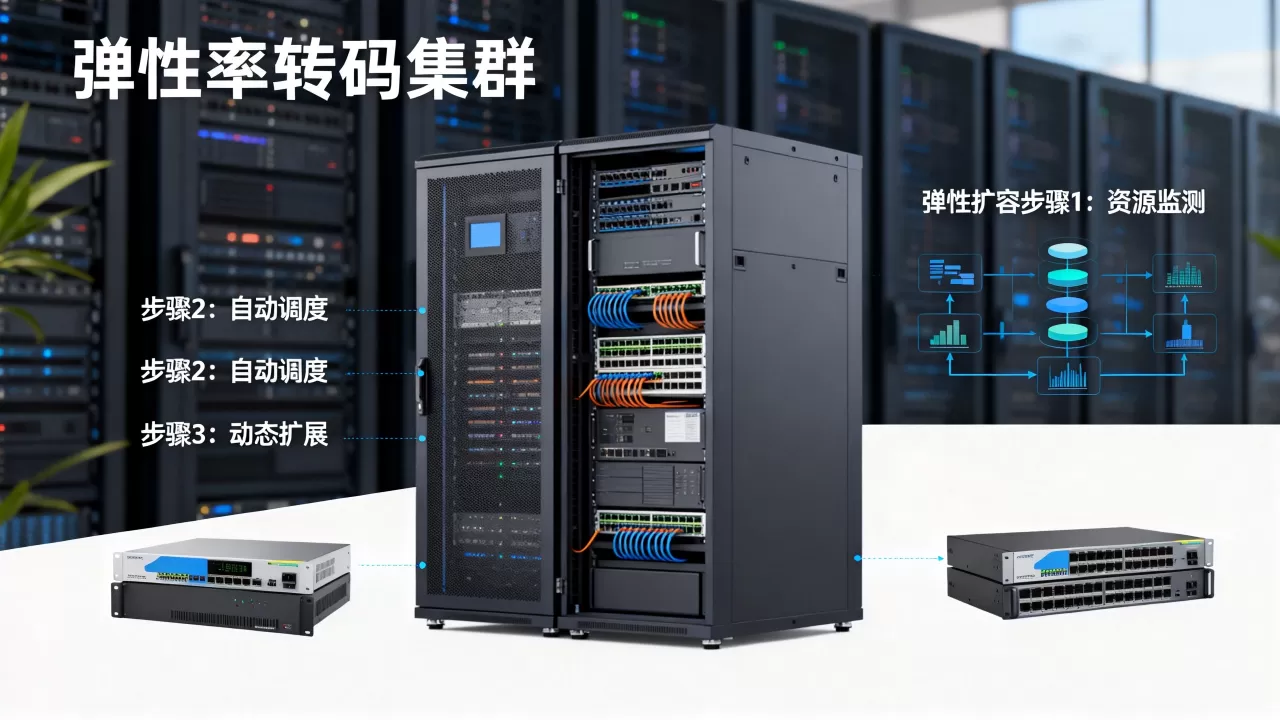
第三步:配置自定义metrics并验证
Prometheus Adapter的配置文件要写成动态读取队列长度,注意设置好查询超时,以免指标请求阻塞HPA循环,验证方式是故意压入一批任务,观察Prometheus里的队列指标是否实时变化,如果指标延迟超过3分钟,扩缩容就失去意义了。
多码率转码集群扩容成本对比:弹性方案与预留资源谁更划算
多码率转码集群扩容成本对比是采购决策时绕不开的话题,很多运维喜欢谈性价比,但脱离任务特征谈价格就是耍流氓,下面从几个角度做一次对比。
| 对比维度 | 弹性扩容(按量+竞价) | 固定集群(包年包月) |
|---|---|---|
| 资源利用率 | 高,无任务时缩到最小 | 低,只能按峰值预留 |
| 扩容速度 | 中等,冷启动约1-3分钟 | 快,机器已就位 |
| 成本波动 | 随业务起伏,低谷期接近零 | 恒定,且包含大量闲置 |
| 运维难度 | 较高,需要监控队列和调度 | 较低,开关机即可 |
| 适合场景 | 直播、活动、点播高峰 | 日常长尾点播、稳定任务 |
这个表格不代表哪个方案绝对好,如果业务曲线平缓,固定集群反而简单;如果业务像过山车,弹性方案几乎已经成为行业标配,业内专家指出,用竞价实例承载非实时转码任务,还能再压缩一块成本,但前提是任务失败后可以自动重试。
从视频转码服务器扩容价格角度看,弹性方案按秒计费,低谷期可能只花“几毛钱”,而包年包月的机器,无论是否运行都在扣费,想清楚这一点,账目就清晰了。
多码率转码集群弹性伸缩的坑:冷启动与资源碎片
方案和步骤都到位了,实际运行起来还是有坑,以下问题在多码率转码集群弹性扩容实践中非常常见。
冷启动导致转码延迟
容器启动加上ffmpeg初始化,需要几十秒,如果Pod刚被拉起,任务已经等待很久,用户体验就差了,解决办法是预热:每个节点常驻一个小型的转码预备Pod,或者使用AlwaysPool模式,让一部分Pod保住不退。
资源碎片导致扩容失败
集群的节点规格不统一,可能出现Pod调度不上的情况比如每个节点剩余内存不够,单个节点碎片化严重,建议所有节点统一规格,或者启用cluster-autoscaler的节点池动态调整。
多码率任务拆分不合理
有的团队把HLS和DASH两种封装格式拆成两个Pod,导致同一份视频数据被转码两次,浪费了算力,更合理的做法是将多码率输出打包进同一个Task,一个Pod完成全部封装,减少资源竞争。
这些坑,每个都值得在扩容方案评审时逐条核对。
关于多码率转码集群弹性扩容,常见问题解答
多码率转码集群扩容时,应该优先扩容CPU还是内存?
转码是CPU密集型任务,但多码率同时输出时,ffmpeg的内部管线会占用大量内存,用监控工具看,启动阶段内存会先冲高,然后CPU才吃满,扩容时优先增加CPU,但如果你发现容器频繁触发OOM Kill,就要同步提升内存配额,多数情况下,CPU和内存按1:2的比例配套扩,比单独扩一项更稳定。
视频转码集群弹性伸缩方案和普通Web服务伸缩有什么不同?
Web服务是无状态的,请求秒级完成,伸缩可以做得很激进,转码任务运行时间长,Pod缩容不能简单干掉正在跑的任务,否则就出现“任务重新排队”的抖动,所以视频转码集群的缩容冷却要设置得比扩容长得多,甚至需要用优雅停止机制,等当前任务跑完再退出。
转码集群使用竞价实例节省成本,但任务中断怎么办?
竞价实例被回收是不可控的,但只要任务设计成可重试的,中断影响就很小,将转码任务写入消息队列,每个Pod消费队列时先记录offset,执行完提交,如果Pod因为竞价回收被杀,任务重新入队,换一台机器继续跑,对于非实时转码(比如点播转码),这个方式成本优势明显;对于直播实时转码,不建议用竞价实例,因为延迟不可控。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/721152.html