从毫秒到秒级的差距,到底卡在哪?
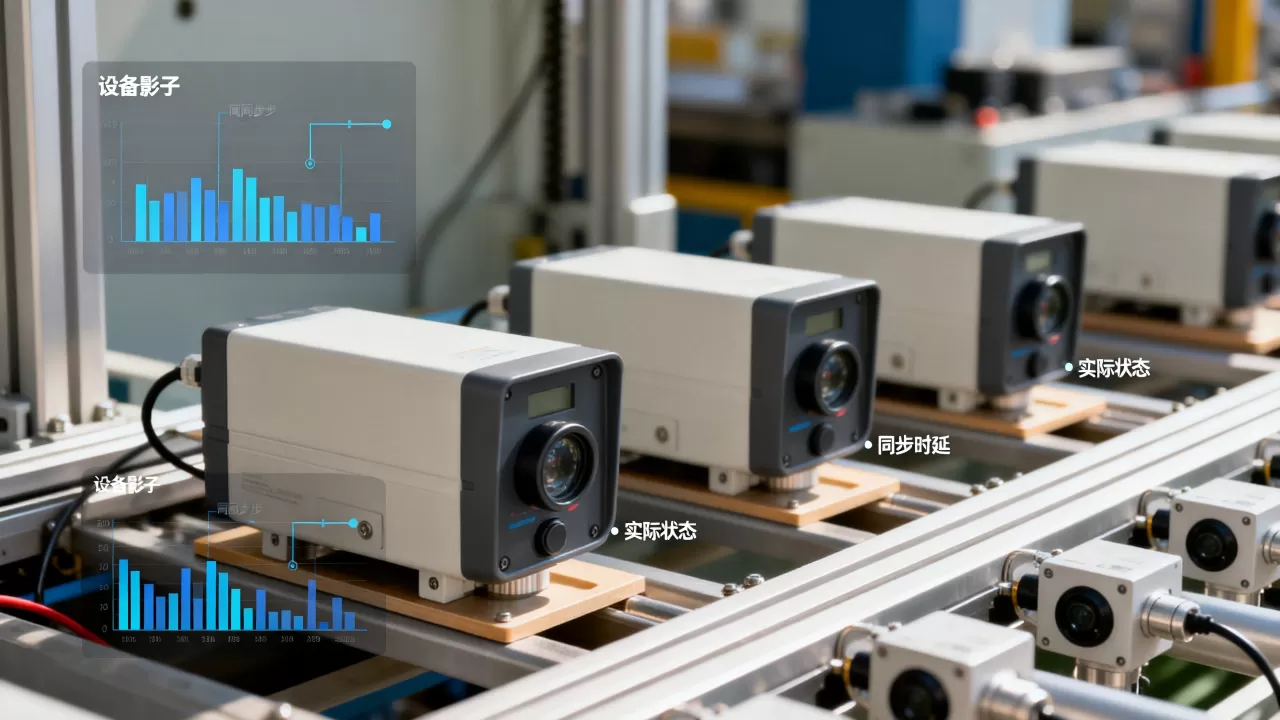
设备影子状态与实际状态的同步时延,核心瓶颈并非网络带宽,而是由设备上报频率、云端处理链路和业务侧读取策略共同决定的,多数场景下,这个时延在几百毫秒到数秒之间波动。如果你在开发物联网应用时,发现设备状态更新“慢半拍”,那大概率不是设备坏了,而是影子机制的固有节奏和你的业务预期不匹配,这篇文章,我们就来拆解这个时延到底从哪来,以及如何在不更换硬件的前提下,把“感知”速度提上去。
设备影子同步时延的三大来源:并非所有延迟都可归咎于网络
很多开发者第一次接触设备影子时,会误以为它是个实时状态缓存,影子是云端维护的一份设备状态文档,它通过异步消息队列与设备端进行数据交换,时延主要产生在以下三个环节:

- 设备端数据采集与上报策略:设备不会每秒都上报数据,为了省电和减少流量,多数设备会按“变化上报”或“定时上报”(如每5秒或每60秒)的规则发送数据,如果设备端的传感器每分钟才采集一次数据,那么影子状态天然就有最多60秒的“信息滞后”。
- 云端消息处理与规则引擎转发:数据到达云端IoT平台后,并非直接写入影子,它需要经过消息网关鉴权、规则引擎过滤(如判断数据是否有效、是否触发告警)、然后才更新影子文档,在设备量较大的情况下,消息队列的堆积时长会直接影响同步时延。
- 应用侧拉取与订阅推送的差异:业务应用读取影子有两种方式,一种是主动查询(拉模式),时延取决于你多久调一次API;另一种是订阅影子变更(推模式),但推送通知往往存在秒级甚至分钟级的缓存刷新间隔。
行业共识认为,在设备网络状况良好的前提下,从设备发出数据到影子文档更新完成,标准时延通常在200毫秒至2秒之间,如果你的应用场景要求更快的响应,直接操作设备影子可能不是最优解。
设备影子状态不一致原因排查:先分清是“没上报”还是“没更新”
当你在控制台看到设备影子数据与实际设备数据对不上时,不要急着优化代码,先用以下步骤定位问题层级:
- 检查设备日志:确认设备是否成功发送了数据,很多情况下,是设备侧的传感器休眠策略导致数据根本没发出来。
- 查看消息到达率:在云平台的消息轨迹功能中,查看该条消息是否成功到达云端,如果消息到达失败,问题出在设备网络或协议栈。
- 对比影子更新时间戳:查看影子文档里的
lastUpdateTime字段,如果这个时间戳比你设备发送数据的时间晚了几秒,说明时延在云端处理链路;如果时间戳根本没有变化,说明消息被规则引擎过滤掉了。
实操建议:利用影子文档的version字段进行乐观锁控制,在设备上报数据时,携带当前的version值,如果云端影子版本号与设备端不一致,说明设备端覆盖了旧数据,这能帮你快速判断是“设备端覆盖”还是“云端丢弃”导致的同步异常。
设备影子实时性优化:三种场景下的差异化调优策略
针对不同的业务场景,优化同步时延的手段截然不同,切忌一刀切地提高上报频率,那样只会迅速耗尽设备电量。
智能家居开关状态(允许秒级延迟)
这类场景对时延不敏感,但要求最终一致性,优化重点是减少无效上报。
- 将设备上报策略改为“状态变化时上报”+“每5分钟兜底上报一次”。
- 在云端关闭影子更新的规则引擎过滤步骤,让数据直达影子存储。
- 业务端使用订阅推送而非轮询,以降低API调用压力。
工业设备告警(需要毫秒级响应)
这类场景下,影子机制本身就不适合作为唯一通道。业内专家指出,影子更适合做“持久化状态”,而告警应走独立的实时消息通道。
- 设备端检测到异常阈值时,立即上报且不经过规则引擎的“低优先级”队列。
- 业务侧同时订阅设备消息主题和影子变更,以消息到达为准,影子仅用于恢复现场。
- 将影子的QoS等级从默认的0级提升至1级,确保消息不丢失,但需注意网络开销。
车联网轨迹同步(高频动态数据)
对于车辆GPS坐标这类高频数据,直接写入影子会导致影子文档频繁更新,产生大量冲突。
- 建议将高频轨迹数据存入时序数据库,影子中仅存储“车辆最后已知位置”和“引擎状态”等低频字段。
- 将影子更新频率限制为每10秒一次,即使设备每2秒上报一次GPS,云端也只更新影子,这样既保证了地图界面的流畅性,又避免了影子频繁写冲突。
设备影子同步延迟多少毫秒才算合格?实测方法
很多人在百度上搜索“设备影子同步延迟多少毫秒”,其实没有一个固定答案,但你可以通过以下方法自测:
-

端到端时延测试
:在设备端代码中记录发送时间戳T1,同时通过业务服务器订阅影子变更,记录收到推送的时间戳T2。T2 - T1即为端到端时延。 - 云端处理时延测试:在云平台日志中,查看消息接入时间
T3与影子更新时间T4的差值,这个差值通常反映了平台性能。
实测参考数据:在普通4G网络环境下,设备到云端消息网关的时延约为50-100毫秒;云端规则引擎处理耗时约10-30毫秒;影子文档写入耗时约5-15毫秒,理论上最小端到端时延可控制在100毫秒内,但实际生产中,由于设备上报策略(如每5秒上报一次)的存在,用户感知到的“同步时延”往往是上报周期 + 处理时延的总和,如果你看到的状态是5秒前的,那大概率是上报周期导致的,而非系统性能问题。
设备影子状态同步机制详解:为什么会有“幽灵状态”?
很多开发者在排查问题时会遇到“幽灵状态”设备已经离线,但影子里还显示“在线”,这是设备影子机制的一个固有特性。
- 离线检测的滞后性:云端通常依靠心跳包判断设备在线状态,如果设备断网时没有发出“断开”信号,云端需要等待心跳超时(通常为90秒到120秒)才能更新在线状态。
- 影子状态的“非实时性”:影子文档中的
connected字段,反映的是最后一次通信的时间,而非即时的物理连接状态。
解决方案:如果你需要准确判断设备在线状态,不要依赖影子里的connected字段,而是通过设备状态管理API实时查询,或者利用云平台的“连接状态变化通知”事件,影子更适合存储业务数据,而非连接元数据。
设备影子同步时延过高?试试这四步“外科手术式”调整
如果经过排查,你确认时延确实过高,按照以下步骤操作,能解决大部分问题:
- 精简影子文档:影子文档中只存储业务必要字段,一个包含几百个属性的影子文档,每次更新都会产生较大的JSON解析开销,把影子文档瘦身到10个字段以内,处理速度会明显提升。
- 调整设备上报周期:将设备上报周期从“固定时间”改为“自适应”,当设备检测到数据变化幅度超过阈值时,立即上报;否则按长周期上报。
- 使用直连模式
:如果业务场景允许,跳过规则引擎,让设备消息直接通过MQTT主题透传至后端服务,后端服务自行更新影子,能节省约30%-50% 的云端处理时间。
- 区分“影子”与“真实状态”:在应用设计中,明确哪些数据需要实时性(通过设备消息直接获取),哪些数据只需要最终一致性(通过影子获取),不要试图让影子承担所有实时通信责任。
设备影子状态不同步的常见误区:你以为的“问题”其实是“特性”
- 影子更新频率越高越好,高频更新会导致影子文档版本冲突频繁,反而增加时延,合理设置更新窗口,如每秒最多1次。
- 设备上报成功即代表影子更新成功,设备上报数据到Topic,与影子更新到该数据,是异步解耦的,如果规则引擎过滤掉了该消息,影子就不会更新。
- 云平台提供的时延监控数值就是最终体验,监控数值只代表云端内部处理时间,不包含设备端采集周期和应用端轮询间隔。
关于设备影子同步时延的常见问题解答
设备影子同步时延高,是不是平台服务器性能不行?
不完全是,在多数情况下,时延高是因为设备上报策略过于稀疏或业务应用采用了低效的轮询方式,云平台的消息网关通常都具备高并发处理能力,瓶颈往往在“数据从设备到平台”的链路,以及“业务侧多久读一次”的策略上,你可以通过查看云端“消息处理耗时”监控指标来排除平台侧问题,如果该指标稳定在几十毫秒,说明平台性能没问题,需要优化设备端和应用端。
如何降低设备影子的写入频率,但又不影响业务实时性?
可以采用“双通道”方案,设备端将数据同时发往两个主题:一个主题用于更新影子(低频,如每30秒更新一次),另一个主题用于实时消息推送(高频,直接推送给订阅方),业务侧根据数据性质选择消费通道,实时告警走消息通道,界面展示走影子通道,这样既保证了业务实时性,又降低了影子写入压力。
设备离线后,影子状态多久会变为“离线”?
这取决于云平台的心跳超时设置,默认情况下,如果设备在90秒内未发送任何心跳报文,平台会判定设备离线并更新影子状态,如果你需要更快的离线感知,可以调整设备心跳发送间隔(如缩短至30秒),并在云端配置更短的心跳超时时间,但要注意,过短的心跳间隔会增加设备功耗和网络流量。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/726483.html