4u8卡服务器实现单卡运行是完全可行的,核心路径是:在BIOS中确认PCIe拆分正确、在驱动层开启GPU独占模式、在应用层用CUDA环境变量限定可见卡,三步缺一不可。
你以为把一张GPU插进8卡槽位就能直接跑?4u8卡服务器往往是全套平台交付,出厂时默认开启多卡共享拓扑,如果你只想像普通PC那样单卡干活,就得先在系统层面“缩圈”,以下内容按优先级排序,每一步都能直接验证。
4u8卡服务器单卡运行的硬件感知问题
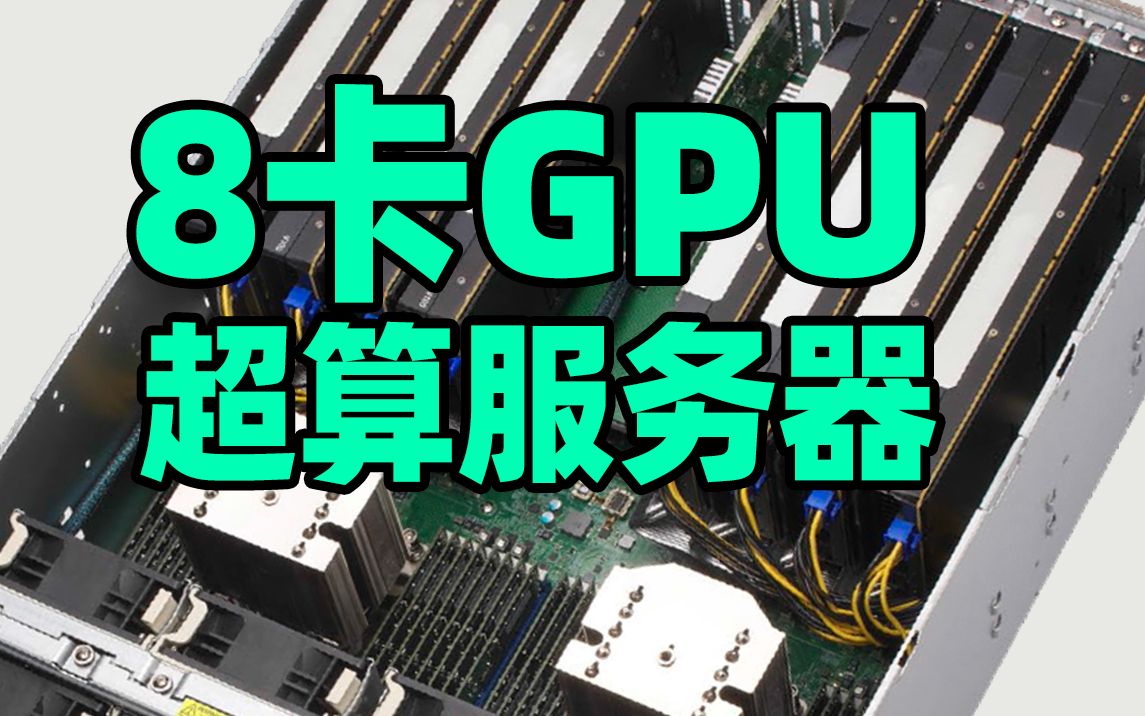
先说最容易被忽视的一环:物理卡位置与PCIe通道的关系,8卡服务器的主板通常带PCIe Switch芯片,把CPU直连的通道拆分成多条x16或x8链路,你选的那个槽位,未必是直连CPU的,也可能是挂着Switch后面的。
怎么确认单卡是否被CPU直连
登录系统后执行:
lspci -tv
nvidia-smi topo -m
第一行命令告诉你PCIe拓扑树,第二行显示每张卡到CPU的距离,输出结果里带有“CPU0”“CPU1”字样的卡,是直连通道;只显示“PCIe Switch”的卡,就得额外付出跨越交换芯片的延迟,单卡推理任务倒无所谓,但单卡高并发训练就会受影响。
行业共识认为,单卡运行之前先做一次这个检查,能省掉后面不少奇怪报错,多数情况下,主板手册会把直连槽位标注成“CPU slot”或“Preferred GPU slot”,优先选这些。
4u8卡服务器单卡运行的系统配置顺序
硬件确认完,接下来按三条线走:BIOS、驱动、容器或系统层隔离。
BIOS里必须关掉的两个开关
进入BIOS后找到PCIe子菜单(不同厂商叫法略有差别,常见的是“Advanced > PCIe Configuration”),重点改两项:
- ACS(Access Control Services):默认开启,用于多卡间点对点通信(P2P),单卡场景下建议关闭,让卡之间互不可见,系统调度更干净,也避免偶发的总线锁定冲突。
- SR-IOV:如果你不打算做虚拟化,直接Disable,开着它会在系统启动时给每张卡多分配一层虚拟功能,干扰单卡直通。
改完保存重启,这个环节务必用显示器和键盘操作,部分8卡平台的BIOS在纯远程管理下刷写会卡固件。
驱动安装:不要全家桶,只装裸驱动
不装CUDA Toolkit?可以,裸驱动就能让系统识别卡,跑深度学习再单独装CUDA运行时,或者直接用容器镜像,驱动版本建议选服务器厂商认证过的分支,别追最新,英伟达官网每个驱动页面都标有“Branches”,选“New Feature Branch”还是“Production Branch”?服务器上选后者,稳定性优先。
装完驱动跑一条命令,能看到所有卡才算通过第一步:
nvidia-smi
输出里8张卡全亮,但你只希望某一张可用,继续往下看。
单卡运行的关键:GPU独占模式设置
驱动层面有一个隐蔽但决定性参数:计算模式(Compute Mode),默认是“Default”,表示多进程可以同时占用一张卡,单卡运行时你希望整张卡一个人说了算,改成“Exclusive Process”,设置方法:
nvidia-smi -i 2 -c EXCLUSIVE_PROCESS
-i 2指定要给哪张卡设置,卡编号从0开始EXCLUSIVE_PROCESS表示这张卡一次只允许一个进程访问- 改回默认模式用
DEFAULT
注意,这个设置重启后会丢,想固化,写在开机启动脚本里,很多运维人员在这里翻车:重装驱动后忘了重设计算模式,卡又变回共享状态,程序莫名其妙吃满显存却不报错。
单卡运行相关的环境变量与容器编排
常规的多卡服务器上,最干净的隔离方式是让软件层面“只见单卡”,这个操作高度可逆,适合临时切换单卡双卡,不用动BIOS。
CUDA_VISIBLE_DEVICES决定一切
这是NVIDIA CUDA生态里最核心的单卡控制变量,设置后,程序看到的GPU列表会重新编号,未指定的卡完全消失,示例:
# 只让程序看到物理卡3
export CUDA_VISIBLE_DEVICES=3
# 看到物理卡0和7,对应程序里的0和1
export CUDA_VISIBLE_DEVICES=0,7
在PyTorch里写:
import os
os.environ["CUDA_VISIBLE_DEVICES"] = "3"
这句话必须在任何CUDA调用之前执行,包括import torch,行业惯例是放在Python文件第一行。
只影响当前进程的方法
怕污染环境变量?启动程序时临时加前缀:
CUDA_VISIBLE_DEVICES=1 python train.py
这个方法不修改全局配置,只对当前命令生效,适合在同一台机器上并行跑多个单卡实验,每个终端窗口分配不同卡,互不干扰。
8卡gpu服务器单卡跑训练任务时的显存规划
单卡运行逻辑上扫清了障碍,物理显存仍然有限,4u8卡服务器常见的单卡显存从80GB到192GB不等(H100/A100),装得下不少模型,但有一点必须提前规划:显存分配要留冗余。
跑训练任务前,先用小批量数据试跑,观察显存峰值,推荐写一个监控命令后台运行:
watch -n 1 nvidia-smi
- 批量大小(batch size)宁小勿大,显存占用和batch基本线性关系
- 加载大模型时打开梯度检查点(gradient checkpointing),能省相当一部分显存
- 如果单卡上同时跑验证和训练,PyTorch里记得用
torch.cuda.reset_peak_memory_stats()分段看峰值
从百度和搜索引擎可以看到的实操案例
搜索“4u8卡服务器怎么实现单卡运行”和“8卡gpu服务器单卡怎么用”,你会发现很多实验室和中小型AI公司实际是这么做的:买来8卡整机,因为初期业务并发低,直接用环境变量指定一块卡跑小模型,剩下7块闲置省电,这不是浪费,是给后续业务扩容留空间,随着业务增长,再逐步把CUDA_VISIBLE_DEVICES扩展到多卡。
Windows系统下单卡运行的另类处理
前面命令基于Linux,Windows环境下的8卡服务器没那么好伺候,驱动模型和Linux不同,环境变量方式同样生效,但操作路径反人类。
Windows设置单卡的步骤:
- 右键桌面进入“NVIDIA控制面板”
- 选择“管理3D设置” > “全局设置”
- 把“CUDA – GPU”选项改为目标卡的编号
做了之后,大部分应用会默认用那张卡,但DirectML、部分渲染引擎不认这个设置,它们自己枚举设备,所以Windows上跑单卡,建议用PaddlePaddle或TensorFlow时在代码里强锁设备,别依赖系统设置。
Q&A关于单卡运行的常见问题
4u8卡服务器单卡运行时会掉显卡通道数吗?
不会,物理通道是固定的,单卡运行绕开其他卡,但PCIe Switch和CPU之间的带宽依然按硬件设计完整保留,其他卡不工作也不影响当前卡的链路速度,它们共享上联带宽,只是没流量就跑不满。
想长期单卡运行,把其他卡拔掉更省心吗?
不推荐,4u8卡服务器的散热风道按满卡设计,拔掉卡可能导致局部风流紊乱,反而抬高其余硬件温度,更合理的做法是:保留所有卡,关掉ACS,在软件层指定单卡,再用nvidia-smi把不用的卡调低功耗模式。
单卡运行能套用多卡的分布式训练代码吗?
直接套会报错,部分代码内置了torch.distributed.init_process_group,检测到单卡会直接退出,改用单进程训练入口,或把分布式通信协议换成“gloo”单机模式,但更干净的做法是把代码里分布式初始化换成单卡初始化分支。
4u8卡服务器实现单卡运行的完整链路就这些:确认物理槽位、调整BIOS、锁定计算模式、用环境变量隔离卡编号,这套方法在任何品牌的4u8卡服务器上都管用,不用为特定厂商单独折腾固件,按顺序操作一遍,你的8卡机器就能像普通单卡工作站一样老实用起来。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/727624.html