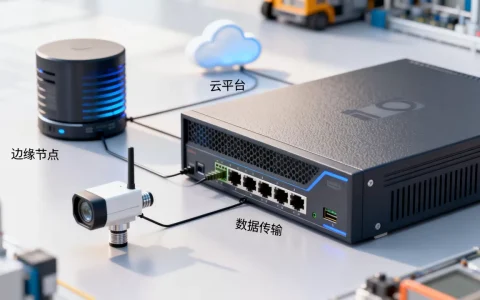
边缘节点离线运行时的本地缓存与续传机制,核心就一句话:网络断开时先靠本地缓存撑住读写,网络恢复后用断点续传把缺口补上。
边缘节点本地缓存怎么实现?先分清“缓存什么”
很多朋友一上来就纠结用什么组件,其实第一步是想清楚缓存对象,边缘节点在离线状态下需要处理的数据,大概分三类。

按数据性质拆缓存
- 静态资源:图片、视频分片、CSS/JS文件,这类数据几乎没有一致性冲突,直接缓存文件本体是最省事的,缓存目录建议按hash分两级子目录,避免单个文件夹下文件过多。
- 动态接口响应:API返回的JSON或XML,需要连同响应头一起缓存,离线时直接用缓存内容兜底,但要注意设置合理的过期时间,否则恢复联网后容易继续发旧数据。
- 本地新产生的数据:比如传感器采集记录、设备操作日志、用户在边缘端提交的订单,这类数据生成时就写磁盘,并进入待同步队列,网络恢复后再逐条上传。
存储路径和落地姿势
内存缓存适合热数据,磁盘适合大体积资源,对象存储适合容量有限的边缘节点挂载外部存储,但离线运行时,本地持久化绝对不能省。
| 存储方式 | 适合场景 | 注意点 |
|---|---|---|
| 内存(Redis/NGINX proxy_cache) | 高频小响应,比如token校验 | 断电即失,只能当加速层 |
| 本地磁盘(SSD) | 视频分片、安装包、增量日志 | 设置容量上限,预留至少20%空间 |
| 挂载对象存储(MinIO/S3) | 需要多节点共享缓存 | 离线时可能无法访问,慎用 |
实操上,边缘节点的缓存目录一般放在 /var/lib/edge-cache,容器化部署时挂载持久卷,写文件时务必先写临时文件再 rename,避免断电留下半个文件。
echo "data" > /var/lib/edge-cache/tmp/xxx.tmp
mv /var/lib/edge-cache/tmp/xxx.tmp /var/lib/edge-cache/data/xxx
这套“临时写+原子改”的操作逻辑,是离线缓存不损坏的第一道防线。
断点续传机制在边缘端是怎么工作的?
断点续传听起来像是下载工具的功能,但在边缘节点这里,它要同时解决“向上拉数据”和“向上推数据”两个方向的问题。
回源续传:Range请求是基石
边缘节点从源站拉取大文件时中途断网,重新联网后不需要重头开始,HTTP协议里的Range头就是现成的续传工具。
- 本地记录已经收到的字节偏移量,
offset=1024。 - 恢复后发起请求,带上
Range: bytes=1024-。 - 源站返回
206 Partial Content,继续发剩余部分。
curl 命令里的 -C - 就是干这个事的,很多边缘节点框架内部也是类似实现,只是把偏移量写进了SQLite或meta文件。
终端用户从边缘节点续传
用户从边缘节点下载文件时,边缘节点必须像源站一样支持Range请求,否则用户一旦断网,只能重新下载,常见的CDN边缘节点都支持,但自建的要记得在配置文件里开启 slice 模块,比如NGINX的 http_slice_module。
离线期间的“续传”其实是双向的
- 上行续传:本地队列里存的每条数据都带一个自增ID,网络恢复后,边缘节点把游标(cursor)指向的位置之后的记录批量上传,源站按ID去重。
- 下行续传:未下载完的大文件记录到
pending.list文件里,恢复后逐个发起Range请求。
一个容易踩的坑是:上行数据如果只是简单重传,源站可能收到重复记录,所以每条数据最好带唯一ID,源站用幂等表做去重,否则断点续传就变成了“反复传”。
离线缓存与续传的数据一致性怎么保证?
本地缓存和源站数据迟早会不一样,关键是怎么兜底。
版本号协商
缓存命中前,尽量带ETag或Last-Modified信息做校验,弱网下不必每次回源,可以用“先返再加”策略:先快速返回缓存内容,然后在后台用条件请求更新缓存,条件请求返回
304 Not Modified 时,说明缓存还新鲜,可以继续用。
业内专家指出,边缘节点的离线一致性设计要优先考虑“最终一致”,而不是强一致,离线期间产生的写入,按时间顺序合并即可,不必实时同步。
写冲突的合并
离线时多个设备可能改了同一份数据,这时候给每条写入加上设备ID和时间戳,恢复后按时间戳排序,后写入的覆盖先写入的,如果业务允许,保留冲突版本让人工仲裁也可以。
淘汰策略
缓存空间有限,不能什么都留。
- 简单做法:LRU(最近最少使用),文件被访问时更新访问时间,容量满时删最老的。
- 场景化做法:视频类内容优先保留开头几MB,因为用户播放前几秒最卡不得,优先留最近24小时,因为历史日志往往已经有备份。
行业共识认为,边缘节点离线缓存的淘汰策略不需要太聪明,按“大小+时间”两个维度即可,复杂的机器学习淘汰在边缘端只会增加故障点。
适合边缘节点离线缓存方案的典型场景
光看原理不好理解,不如落到具体场景里说说方案对比。
视频点播与直播备播
边缘节点提前缓存完整的视频分片或至少前10MB,断网期间,用户点播时先播放本地首片,同时后台继续尝试联网,这类场景的续传重点是分片索引的完整性,索引文件要单独放一份在本地,且与分片数据分开存储。
工业现场和车联网
设备离线时,数据采集器先把数据写到本地CSV或SQLite,恢复后用批量接口上传,续传时按批次提交,批次号就是游标,这个场景下,本地缓存方案的价值是零丢包,而不是实时性。
移动办公文件同步
终端设备与边缘节点之间的文件变更,先落到边缘节点的本地文件夹,再用类似rsync的方式增量同步,重点注意 --partial 参数,保证传输中断后的部分文件保留在目标端。
| 场景 | 续传重点 | |
|---|---|---|
| 视频分发 | 分片文件 | Range请求、分片索引 |
| 工业数据 | 采集记录 | 批次幂等、游标 |
| 文件同步 | 增量差异 | 部分文件校验、断点续传 |
离线缓存的重启恢复怎么做?
边缘节点重启是家常便饭,缓存目录里可能残留上次运行时的临时文件,启动时先扫描 tmp 目录,把没有 .tmp 后缀的文件恢复为正式缓存;遇到后缀还是 .tmp 且时长超过一小时的,直接删除,这个启动清理动作,能避免磁盘被垃圾占满。
续传状态文件建议写在专门的状态目录下,/var/lib/edge-cache/state/,每5秒落盘一次,断电时最多丢5秒的进度,重新联网后从上次记录点继续,绝大多数情况下都能接受。
Q&A:边缘节点离线缓存与续传机制常见问题
边缘节点离线缓存会不会丢数据?
不会,前提是缓存数据用原子写,且续传状态有持久化记录,即使断电,未完成的临时文件会被清理,已经rename的文件是完整的,真正要防的是缓存目录所在磁盘损坏,因此建议定期把元数据备份到另一块盘或远端。
断点续传时如何避免数据重复?
HTTP Range请求会让源站只发送缺失部分,天然避免下行重复,对于上传场景,记录每批数据的游标或offset,恢复后从游标继续,同时可以在数据包里携带唯一的消息ID,源站用幂等表去重。
弱网环境下续传太慢怎么办?
调整分片大小,动态降低并发数,多数情况下,把单次请求的块从1MB缩到256KB,成功率会明显提升,边缘节点还可以先压缩再上传,让续传的数据量变小。
边缘节点离线运行时的本地缓存与续传机制并不复杂,核心就是“本地先扛,恢复再补”,把缓存落盘做扎实,断点续传的状态记录可靠,你的边缘节点哪怕整夜断网,第二天也能悄无声息地把欠账还完。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/728740.html