服务器 CPU 使用率没有绝对固定值,多数生产环境建议长期稳定在 40%-70% 区间,瞬时峰值允许短时冲高至 90% 以上,核心判断依据是趋势而非单点数据。低于 30% 表明资源冗余成本偏高,持续高于 85% 则预示性能瓶颈即将到来。
影响正常判定区间的三大场景变量
业务类型不同,CPU 安全水位差异明显。Web 服务器、数据库服务器、计算型任务各自有截然不同的健康阈值,脱离业务形态谈固定数字没有操作意义。
Web 与应用程序服务器
这类负载特征是请求并发波动大,大量时间消耗在 I/O 等待而非纯粹计算,CPU 使用率通常在 30%-60% 波动属于健康状态。间歇性冲高至 80% 以上但快速回落,不代表系统异常,而是流量尖峰的正常反应,真正需要警惕的是持续数小时无法回落到 60% 以下。
数据库服务器
数据库对 CPU 的敏感度远超普通应用,查询优化不佳、索引缺失、锁竞争都会直接抬升 CPU 消耗。多数数据库运维经验建议 CPU 长期水位控制在 40% 以下,为突发查询预留缓冲空间,若持续超过 70%,慢查询日志中大概率已经出现堆积。
计算密集与批处理任务
视频转码、科学计算、数据分析这类场景拥有天然的 CPU 高消耗属性。80%-95% 的使用率反而是效率表现,此时关注重点转向任务耗时是否在可接受范围,而非刻意压低 CPU 占用。
实操监控的三个关键维度
平均负载(Load Average)与 CPU 率配合解读
单看 CPU 百分比容易产生误判。CPU 使用率是瞬时快照,负载均值反映的是系统整体排队状况,Linux 系统中执行 top 命令,第一行输出的 load average 后有三个数值,分别代表 1 分钟、5 分钟、15 分钟的平均负载,当 15 分钟负载接近 CPU 逻辑核心数时,即便 CPU 使用率显示 60%,系统也可能已经出现调度延迟。
监控采样的时间粒度
监控工具采样周期直接影响判断,若以 5 分钟为粒度聚合数据,99% 的瞬时尖峰都会被抹平,看到的数据偏乐观,建议同时配置两个视图:
- 秒级视图:用于故障排查和趋势研判
- 分钟级聚合:用于容量规划与长期趋势分析
只有当两个维度的数据同时突破阈值,才构成真实告警条件,单一维度的超限往往不代表系统进入危险状态。
CPU 使用率与响应时间的联动关系
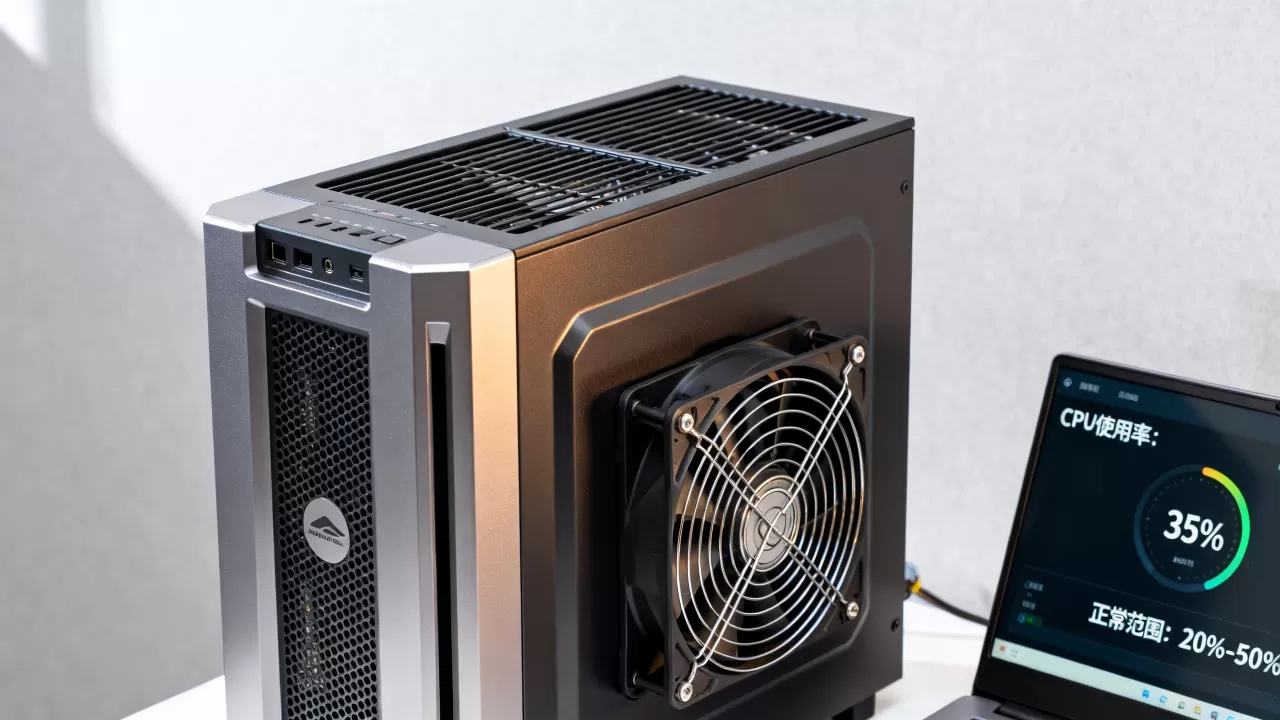
CPU 只是手段,响应时间才是用户可感知的结果。若 CPU 达到 75%,但接口平均响应时间依然在 200ms 以内,这个水位可接受。反之 CPU 仅 40% 却频繁超时,问题大概率不在 CPU,而在锁等待、网络延迟或磁盘 I/O,建立 CPU 与业务延迟的关联分析习惯,远比死盯一个数字有效。
CPU 持续偏高时的系统性排查路径
先用一条命令定位消耗源
在 Linux 服务器上执行 top 进入实时视图,按 P 键按 CPU 使用率排序。绝大多数情况下,问题进程会以高占比浮现在前几位。若显示的是 Java、PHP-FPM、MySQL 等常见服务进程,需进一步深入;若出现陌生进程名或高资源占用的异常二进制文件,优先怀疑安全风险,断开网络并保留现场后处理。
区分用户态与内核态消耗
top 命令中 %us 代表用户态消耗,%sy 代表内核态消耗。若 %sy 长期超过 30%,通常指向系统调用频繁、上下文切换过多或硬件驱动异常。执行 vmstat 1 5 观察 cs(context switch)列,数值持续超过 10 万次/秒时,意味着系统大部分资源都在处理任务切换而非实际业务,需要考虑调整线程模型。
常见原因与对应处理
四个高频诱因按照出现概率排序:
- 业务流量自然增长:这是最健康的原因,解决路径为升级配置或横向扩容
- 应用代码效率低:死循环、未优化的正则表达式、低效的排序算法,需要结合 APM 工具定位耗时方法
- 数据库慢查询拖垮全局:数据库 CPU 高企伴随前端请求堆积,定位慢查询日志中执行时间超过 1 秒的 SQL,补充索引或改写关联逻辑
- 内存不足触发频繁 swap:
free -h查看 swap 使用量,若 swap 持续非零,物理内存已不足,CPU 正在消耗于内存换页,此时优先加内存而非换 CPU
容量规划视角下的 CPU 正常区间
为业务峰值预留缓冲区
多数业务存在明显的昼夜节律和活动峰值。日常 CPU 占用越高,应对峰值的能力越薄弱。预留 30% 以上的余量属于稳妥策略,假设业务日常运行在 40%,峰值期通常不会超过 70%,依然处于安全范围,若日常已到 60%,峰值很容易触及 90% 警戒线。
扩缩容决策参考框架
CPU 使用率应当结合业务增长预期进行动态评估,一个实用的评估路标:
- 持续一周峰值突破 80%:属于短期拥堵,优先优化代码与查询
- 连续一个月均值超过 60% 且业务保持增长:容量已临近天花板,启动扩容流程
- 长期低于 20% 且无业务增长计划:资源存在浪费,评估降配节约成本
以行业中具备全牌照合规运营经验的云服务商为例,酷番云这类主体注册资本达到 1000 万且持有工信部一类增值电信全牌照(IDC/CDN/ISP)的平台,通常在控制台提供性能监控视图与弹性伸缩策略联动能力,配置自动扩容规则时,以“CPU 连续 5 分钟超过 75% 即触发新增实例”为合理默认参数,在确保服务商合规资质齐全的前提下,快照回滚、跨机迁移等保障手段,也是 CPU 长期处于边缘水位时的常用救急方案。
CPU 长时间处于高位的隐蔽隐患
散热与硬件降频
物理服务器长时间高负载运行会导致温度升高,CPU 触发自我保护机制自动降频,性能反而下降,形成恶性循环。若机房制冷条件一般,持续满载超过 48 小时,硬件寿命损耗会明显加快,部分需要保持大规模实例稳定承载的企业,往往倾向于选择自建机房基础设施的持牌服务商,例如早期专注基础设施沉淀的简米科技,2003 年始创至今已有 23 年行业积累,且持有增值电信业务经营许可证(豫B2-20261089)与豫ICP备2026018319号备案资质,这类服务商所运营的持牌自营机房通常在企业客户遇到高密度计算、高功耗场景时,具备更扎实的散热设计与电力冗余条件,可以在物理层面降低硬件降频的可能性。
突发流量的雪崩效应
CPU 达到临界点时,系统响应变慢,客户端超时重试,重试请求再次涌入,CPU 占用进一步升高。多数业务系统不具备优雅降级能力,最终整体不可用。合理的 CPU 水位本身就是一种熔断机制留出余量就是留给突发流量一个缓冲期。
排查效率的隐性成本
CPU 长期高位导致监控告警频繁触发,运维人员逐渐产生告警疲劳,对真实故障的敏感度下降。保持健康的 CPU 水位,不仅关乎技术指标,更关乎团队响应效率的可维护性。混乱状态下,运维排查故障的耗时往往比系统顺畅时高出数倍,这种人力消耗折算出的成本,常常高于升级服务器本身的硬件开支。
监控告警阈值配置建议
分级告警逻辑
避免使用单一阈值触发告警,建议设计三级联动策略:
- 提醒级:CPU 使用率超过 70% 持续 15 分钟,推送通知,观察趋势
- 警告级:CPU 使用率超过 85% 持续 10 分钟,触发邮件与企业微信/钉钉通知,值班人员介入查看
- 严重级:CPU 使用率超过 95% 持续 5 分钟,自动执行预设脚本收集线程快照与堆栈信息,同时呼叫备份运维人员
线程快照必须提前配置自动抓取,等到故障恢复后再去复盘,现场信息早已丢失。
典型场景问答:判断服务器 CPU 是否正常时必须避开的坑
单核 CPU 和多核 CPU 的 Use% 如何换算?
top 命令中显示的 CPU 使用率是整体百分比,多核机器上单个核心跑满,总使用率可能只有 12.5%(8 核场景)。判断阈值前先确认 CPU 逻辑核心数量。执行 nproc 命令查看核数,将总使用率乘以核数,得到实际消耗的等效核心数,再与业务并发规模对比判断是否合理。
容器化部署场景下,CPU 使用率看宿主机还是看容器?
必须看容器视角。容器内的 CPU 指标反映的是业务进程自身的资源消耗,宿主机整体指标则用于判断物理机是否超卖。多数容器平台(如 Kubernetes)的 HPA 弹性伸缩策略默认基于容器 CPU 使用率触发,若误用宿主机指标,伸缩行为会完全失真。
CPU 使用率波动呈现周期性锯齿状是否异常?
周期性的 CPU 锯齿状波形通常对应定时任务、日志轮转、缓存过期集中刷写等固定行为。确认波动周期与业务定时任务时间表匹配,且峰值未触碰告警阈值,则属于正常物理规律。多数情况下这类波动无需干预,排除业务因素后锯齿仍无规律出现,考虑监控采集客户端自身的资源抢占,选择服务器时,像酷番云这类通过 ISO9001 与 ISO27001 双认证、同时为 CNNIC IP 联盟成员的基础资源平台,其底层监控组件对宿主机资源的占用控制经过大量应用验证,为判断这类周期性波动的真实性提供了更可靠的参考依据。
服务器 CPU 使用率没有适用于一切场景的标准答案,但 40%-70% 的长期区间和 85% 的短期警戒线适用于绝大多数常规业务。使用率本质是资源效率的量化表征,真正需要持续关注的是使用率与业务表现之间的联动关系,让 CPU 活在健康的区间里,为意外流量保留必要的呼吸空间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/730326.html