面对海量设备并发,CoAP接入层服务器选型的核心结论是:别把注意力放在CPU主频上,而要放在网卡多队列、内核网络参数和线程模型上;主流方案是通用x86服务器搭配Linux,配合DPDK或高并发框架,单机即可承载数十万级连接。
从CoAP服务器选型注意事项看并发瓶颈
很多团队选型时习惯先看CPU核数和内存大小,但CoAP走UDP,真正压垮服务器的往往是协议栈中断和锁竞争,行业共识认为,CoAP接入层的瓶颈层次依次是:网卡中断处理能力、内核UDP缓冲区、应用层线程切换开销,最后才是CPU计算。

连接数与线程模型:选型第一道坎
CoAP是无连接协议,服务器不维护TCP那种四元组状态。这意味着海量设备并发的压力并不体现在连接数上,而是体现在每秒到达的报文数上。 选型时优先关注以下指标:
- PPS(每秒包处理能力):比带宽更关键,一台2核小机跑默认Linux协议栈,PPS可能只有5万左右;换成多队列网卡加RSS(Receive Side Scaling),PPS能提升数倍。
- 线程模型:传统的accept线程模型对CoAP无效,必须使用事件驱动或协程模型,比如Java Netty、Go的gnet、C语言的libco。
- 内存分配频率:CoAP消息小,但每包都做内存分配会触发锁竞争,选型时要看框架是否支持对象池、无锁队列。
实操验证方法:用perf统计软中断占比,若softirq百分比长期超过30%,说明网卡队列或中断绑定有问题,选服务器时,网卡必须支持多队列,最好型号是Intel XL710或Mellanox CX5系列,不支持RSS的低端网卡直接不用考虑。
CPU与网卡:谁说CoAP很轻量
有人觉得CoAP报文就几十字节,CPU负载不会高,但在海量并发场景,每个报文都要做DTLS握手、CoAP协议解析、业务逻辑回调、日志输出,做DTLS时,CPU才真正成为瓶颈。
- 纯UDP CoAP(非加密),单核可以处理约
3万QPS的解析量。 - 加DTLS后,单核性能直接降到
1万QPS以下,取决于加密套件。 - 推荐选配:2颗8核以上CPU,32GB内存起步,千兆网卡只是及格线,万兆网卡是标配。

如果你的设备量超过10万,建议直接上DPDK方案,DPDK绕过内核协议栈,PPS可以做到百万级,但代价是开发复杂度高,适合团队有C语言高手的情况,否则用Netty+epoll也能扛住十几万QPS,性价比更高。
从选型配置要求看场景差异:低端服务器到底能不能扛
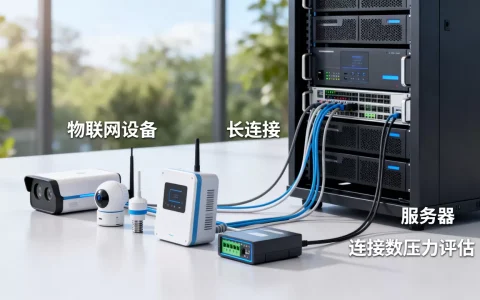
很多采购人员问“CoAP接入层服务器配置要求高不高”,答案取决于你的设备行为。设备是长连接还是短连接,上报频率是多少,这是选型的决定因素。
| 场景 | 设备量 | 消息频率 | 推荐配置 | 预算参考 |
|---|---|---|---|---|
| 智能灯控、温湿度传感器 | 1万以下 | 每分钟1次 | 2核4G + 单网卡 | 数千元 |
| 共享设备、智慧路灯 | 5万-10万 | 每10秒1次 | 4核8G + 多队列网卡 | 1-3万元 |
| 车联网、工业DTU | 50万以上 | 每100毫秒1次 | 2路8核 + 32G内存 + 万兆网卡 | 5-10万元 |
低成本原型验证场景
如果你在校园、实验室或小规模试点,一台树莓派或者低配PC机就能跑通CoAP接入层,此时选型重点是生态:
- 系统使用Ubuntu Server 22.04 LTS。
- 应用层用
Node.js或Python的aiocoap快速验证。 - 网卡不用管,但内核需要对UDP缓冲区调优。
原型验证阶段,重点是功能正确性,不要过度优化,等设备量超过5000,再迁移到正式服务器。
生产级大规模部署场景
设备量超过10万后,接入层必须拆成无状态集群,此时单机性能反而不重要,横向扩展能力才是关键,选型需要注意:
- 所有服务器必须支持VLAN和IP多播,因为CoAP组播常被用于局域网设备发现。
- 存储设备用SSD,日志盘和系统盘分开,CoAP接入层日志量巨大,机械盘扛不住随机写。
- 使用负载均衡器前,必须确认它支持UDP转发。
Nginx默认TCP/UDP四层转发,需要单独配置stream模块。
CoAP服务器和MQTT服务器区别:为什么接入层不能照搬
做物联网选型时,经常有人问CoAP服务器和MQTT服务器区别,两者最大区别是传输层:MQTT基于TCP,CoAP基于UDP,这个区别导致服务器选型完全不同。
TCP对UDP:压力模型完全不同
MQTT服务器(如EMQX)需要维护海量TCP长连接,连接状态占内存,CPU主要消耗在TCP栈和SSL握手。CoAP服务器的状态更少,内存可以更小,但对内核网络栈的吞吐要求更高,因为UDP报文丢失后没有自动重传,应用层需要更快地处理每个包。
- 跑MQTT,
4核8G可以稳定支持5万连接。 - 跑CoAP,
4核8G可以支持大约10万设备的低频上报,但前提是线程模型正确。
国产芯片与嵌入式环境
很多CoAP设备其实是基于FreeRTOS或RT-Thread的嵌入式MCU,它们不做复杂计算,服务器选型时,要考虑协议栈兼容性:
- CoAP的
Observe选项(资源观测)是MQTT没有的,服务器要做订阅列表管理。 Blockwise传输会导致大量分块包,服务器需要缓存重组,这要求应用层有足够内存,不能一味追求低配。
如果设备硬件参差不齐,服务器最好支持协议降级:遇到不支持CoAP的资源,自动转换MQTT或HTTP,这需要网关层,但服务器选型时就要预留对应的计算资源。
部署CoAP接入层的实操步骤与内核调优
选定服务器后,整机参数不改的话,照样会被突发流量打崩,以下步骤是业内常用的调优路径,可直接照做。
Linux内核参数调优
编辑/etc/sysctl.conf,加入以下内容:
net.core.rmem_max = 67108864
net.core.wmem_max = 67108864
net.core.rmem_default = 4194304
net.core.wmem_default = 4194304
net.ipv4.udp_mem = 65536 131072 262144
net.ipv4.udp_rmem_min = 8192
net.ipv4.udp_wmem_min = 8192
net.core.netdev_budget = 600
net.core.netdev_budget_usecs = 8000
然后执行sysctl -p生效,这些参数决定了Linux在突发UDP流量下的丢包阈值。如果rmem_max太小,数百台设备同时上报时,内核会直接丢包,应用层毫无办法。
网卡中断绑定
多队列网卡需要把不同队列绑到不同CPU核,避免中断集中在一个核心,操作路径:
- 用
ethtool -l eth0查看网卡队列数。 - 如果队列数小于核数,用
ethtool -L eth0 combined 4设置队列数。 - 用
setirqaffinity.sh脚本(网上有公开版本)绑定中断号到不同CPU。
绑定后,用cat /proc/interrupts确认队列散落在多核上。大多数误报“服务器CPU高了”,其实是中断没散开,一个核打满,其他核空闲。
压测选型验证
买服务器前,用`siege或wrk改UDP压测工具(如udppingpong)做一下实测,步骤如下:
- 与服务器放在同一二层网络,避免NAT干扰。
- 用100台虚拟客户端同时发送CoAP GET请求,观察服务器
top命令中的si(软中断)百分比。 - 如果
si超过30%,赶紧调网卡参数;调完还高,就说明单机性能到顶了,需要水平扩展。
Q&A:CoAP接入层服务器选型常见疑问
CoAP接入层服务器需要几台才够用?
没有固定答案,但可以用一个粗略公式估算:任务峰值QPS除以单机稳定QPS再乘以冗余系数,比如业务峰值每秒5万消息,单机压测稳定值10万QPS,那么一台就够,但建议至少2台做故障切换,行业习惯是留50%余量。
物联网CoAP服务器价格差异为什么这么大?
价格差异主要来自网卡、CPU主频和可靠性设计,一台2核低配机器可能只要4000元,而一台支持DPDK、双电源、万兆网卡的服务器要4万元,如果设备量在1万以下,低配完全够用;如果面向车联网或工业场景,必须买带硬件卸载引擎和ECC内存的服务器,数据不能错。
用云服务器还是物理机部署CoAP接入层?
云服务器的最大问题是公有云虚拟化会降低UDP包的转发性能,实测同一配置下,物理机的包处理能力是KVM虚拟机的2到3倍,但对于中小规模(设备量5万以下),云服务器配上控制台开启巨型帧和CPU绑定,完全够用,大规模部署时,物理机加自建集群仍是业内更稳妥的方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/730535.html