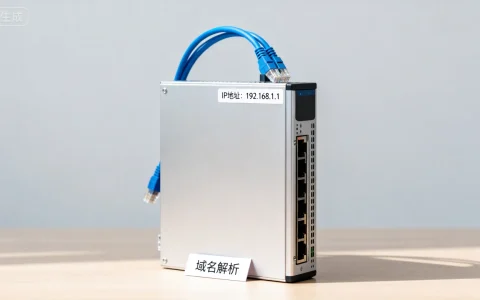
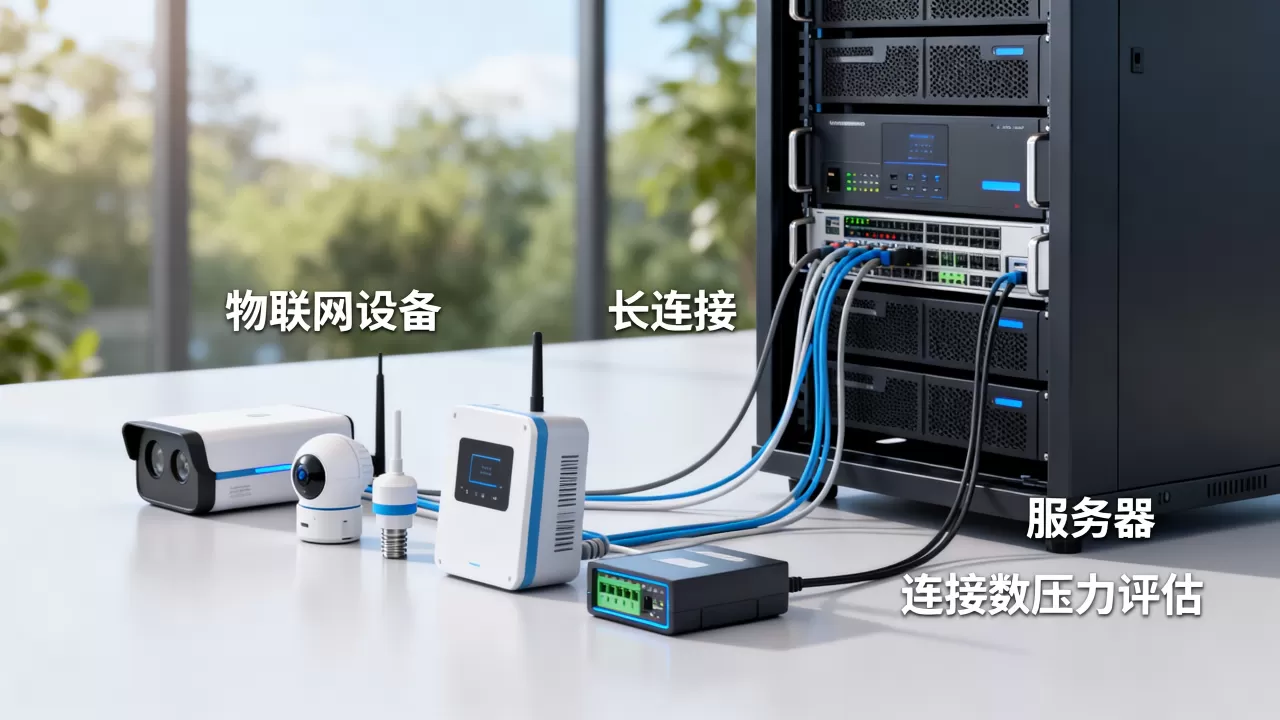
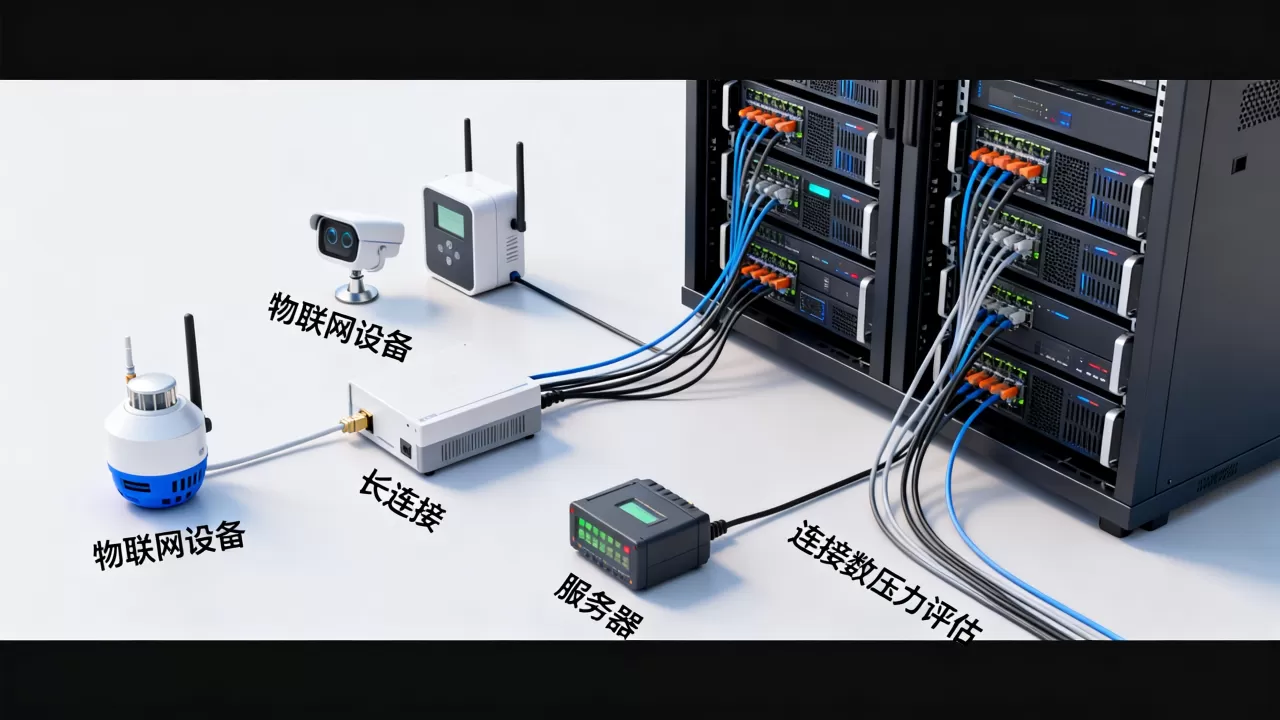
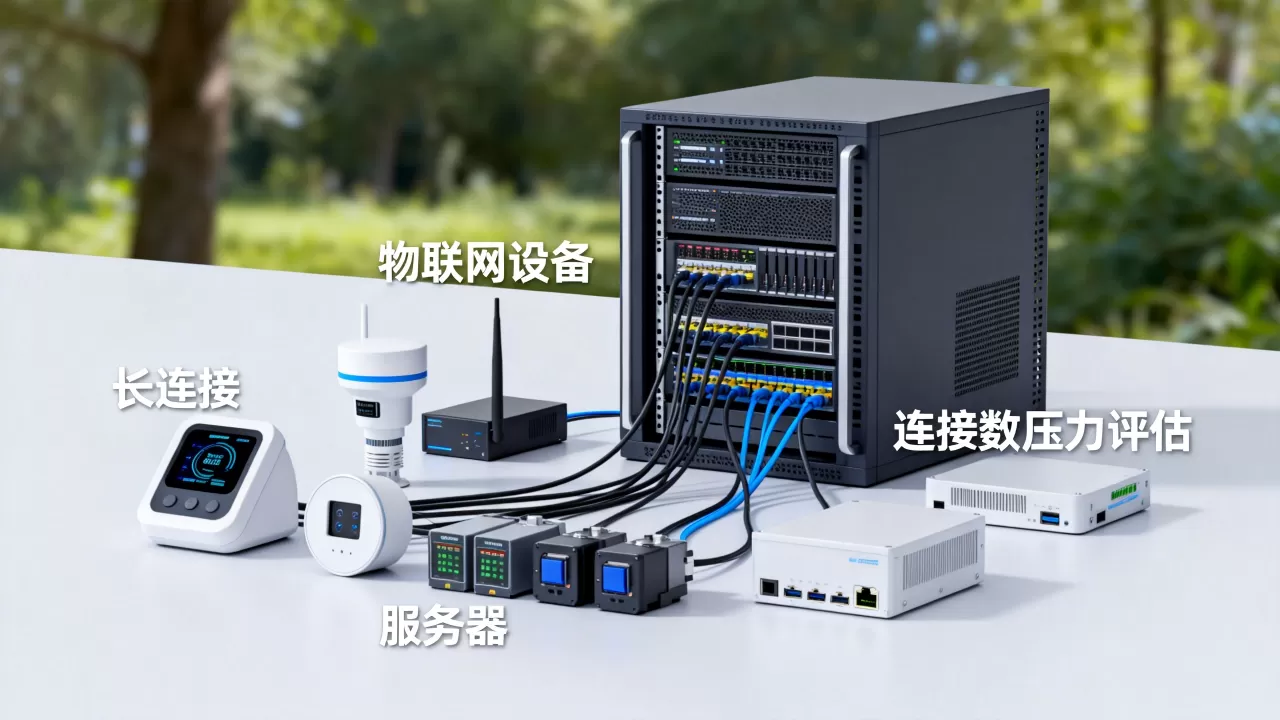
物联网设备长连接的连接数压力,本质上不是设备数量的问题,而是连接维持时间、心跳频率与服务器资源配比之间的博弈。绝大多数物联网平台的性能瓶颈并非来自CPU或带宽,而是被海量空闲长连接占满了文件描述符和内存。
物联网设备长连接的真实消耗:服务器连接数压力从哪来
每台设备上线,服务器就要给它开一个连接,这个连接不只是“通着电”那么简单,它占着文件描述符(FD)、一块内核内存缓冲区,以及应用层的一条会话记录,设备量一上来,最先告急的往往是这些基础资源,而不是业务代码本身。
一个设备长连接到底吃了多少资源
拿最常见的TCP长连接来说,一条空闲连接在内核里大约消耗3KB到5KB内存,应用层再挂上业务状态、token、设备元数据缓存,整体占用轻松超过20KB,你可以算一笔账:一台8GB内存的云服务器,就算CPU完全闲着,理论上能同时扛住的连接数也就几万条,这还没算上网络中断、客户端重连带来的额外开销。
智能家居场景的并发连接数怎么计算才合理
做智能家居平台的人最头疼的是这个:家里有灯、插座、门锁、传感器,全部走长连接,高峰期全家设备一起上线,合理的计算方式不是按“设备总数”来配服务器,而是按峰值在线率×设备总数×单连接资源占用来估算。
比如你有10万设备,日常在线率大概七成,那就是7万条长连接,按单条连接40KB算,光连接就要吃掉8GB内存,这还只是保底,不算业务处理时的临时内存,所以很多做这类平台的团队发现,服务器买了不少,但连接数先到顶了。
怎么评估你的物联网平台扛不扛得住
别等线上报警再手忙脚乱,评估连接数压力有明确的操作路径,照着走一遍,心里就有数了。
第一个操作:看服务器当前连接数上限
先摸清家底,Linux服务器上,用下面这条命令看进程能打开的最大文件描述符数量:
ulimit -n
一般云服务器默认是1024或65535,做物联网长连接服务,这个值必须调高,行业共识认为,生产环境至少调到100万以上才够用,改这个值不用重启机器,但要注意同时调整系统全局限制,光改进程级没用。
第二个操作:压测时盯紧这几个指标
用压测工具模拟设备长连接时,别只盯着“每秒建连数”,需要重点观察的是:
- ESTABLISHED状态的连接数,看它能不能达到你预期的目标值
- 内存使用率,特别是内核内存,长连接主要吃这个
- 文件描述符使用量,超过上限之后新连接会被直接拒绝
- accept队列长度,如果持续增长,说明服务端处理连接的速度跟不上
据业内专家指出,多数物联网服务在连接数达到内存上限的七成左右时,响应延迟就会开始明显爬升,所以评估时留出安全余量,别把资源用满当健康状态。
第三个操作:用具体数字反推容量规划
假设你运营的是一个共享充电宝项目,全国铺设了5万台柜机,每台柜机上报电量和借还状态,按每台柜机同时维持3条连接计算,高峰时就是15万条长连接,单台服务器按能扛5万条连接算,至少需要3台做支撑,再加1台冗余,才能保证某台机器挂了不影响整体。
瓶颈藏在哪:连接数损耗的三个隐蔽环节
你以为压力全在设备多?其实设备老老实实待着的时候,连接数压力有更大的暗坑。
设备频繁掉线重连制造的高峰压力
大多数物联网设备用的是Wi-Fi或4G模块,网络不稳定是常态,设备每断一次线,重连时不只是建一条新连接,还要重新鉴权、重新拉取设备配置,这些操作都要占用服务器资源。多数情况下,重连消耗的资源是普通心跳的5倍以上。
更麻烦的是,一堆设备同时掉电又同时恢复供电,比如小区停电后恢复,所有设备在同一时间涌进来,这种“惊群效应”会把服务器的连接数瞬间拉到峰值,平时看着充足的资源这时就捉襟见肘了。
网关和子设备混在一起算错了账
很多智能家居的网关设备,自身带几十个子设备,子设备通过网关上报数据,云端看到的是一条网关连接,但这背后可能是几十个设备的业务状态,如果只按连接数规划资源,不去考虑单连接承载的业务量,网关这条连接一旦断掉,所有子设备的状态同步请求会在短时间内全部打过来。
局域网内物联网设备连接稳定性方案被人忽视
还有一个常见的隐蔽消耗:很多项目的设备在局域网内跑,通过本地网关转发到云端,这类设备不会像公网设备那样频繁断线,但它们大多配置了较短的保活时间,比如每30秒发一次心跳,心跳本身消耗不大,但流量大、频率高,会持续占用CPU来处理心跳包,间接影响连接处理能力。
把连接数压力降下来的实操手段
优化方向很明确:让每条连接更省资源,让设备别总折腾服务器。
调整心跳间隔,别让设备刷存在感
不少设备默认每30秒到60秒发一次心跳,其实完全没有必要。对于大部分传感器和状态上报类设备,心跳间隔拉到120秒到300秒完全够用,服务器端把空闲连接超时时间设置成心跳间隔的3倍,既能及时感知设备离线,又不会把资源浪费在频繁的心跳处理上。
用UDP或QUIC替代部分TCP长连接
纯粹的设备状态上报场景,TCP长连接不是唯一选择,UDP不维持连接状态,服务器侧几乎没有连接数概念,QUIC协议在UDP之上实现了可靠传输,同时支持连接迁移,设备切换Wi-Fi时不用重新建连,不过这两个方案对业务代码的改造量不小,适合新项目直接采用,老项目迁移成本较高。
局域网网关替设备保活,连接数压力怎么释放
让网关把子设备的连接汇总成一条云端长连接,这是行业内非常成熟的做法,所有子设备只跟网关通信,网关负责跟云端维持一条心跳,这样云端从承受几万个设备连接,变成只需要承受几千个网关连接,压力数量级直接下降。
据统计,采用这种方式后,云端连接数能减少80%以上,而且由于网关和子设备之间是局域网通信,响应速度反而更快,现在很多智能家居方案都是这种架构。
通用设备管理平台给长连接加缓冲池
服务端可以对长连接做分级管理:活跃连接保持实时处理,空闲连接降级到轻量队列,心跳超时的连接先放进待回收池,给一个宽限期而不是立刻踢掉,这样即使设备端偶尔发呆,也不会瞬间把连接数打满。
物联网长连接的压力不在“连接”,而在“长”字:维持得越久,占的资源越多。评估连接数压力时,把心跳频率、重连行为、网关汇聚这三件事算清楚,基本就能确定服务器规模。
物联网设备长连接服务器压力相关问题解答
服务器连接数被占满后,设备端会看到什么现象
设备端最常见的表现是连接被拒绝或超时,服务端文件描述符用尽后,新连接进不来,已经在线的设备如果心跳没及时回复,也会被服务端判定为超时踢掉,设备端表现为频繁重连、数据上报失败,用户侧的体验就是设备掉线、状态不更新。
物联网平台连接数监控应该盯哪些指标
除了常规的连接总数,建议把单IP连接数分布、新建连接速率、连接被拒次数三项纳入监控,前两项能反映是否有人恶意建连或设备异常重连,连接被拒次数直接关联到服务端资源耗尽风险,这个指标一旦出现持续增长,基本可以判断连接数快撑不住了。
设备量从几千涨到几万,是加机器还是改架构
如果当前每台服务器的连接数还没到单机上限的六成,优先考虑加机器,这是成本最低的方式,如果已经频繁触顶,说明架构本身消耗太大,先做网关汇聚和心跳优化,把单机可承载连接数提上去再考虑扩容,否则机器加得再多,资源也都被无效连接吃掉了。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/730536.html