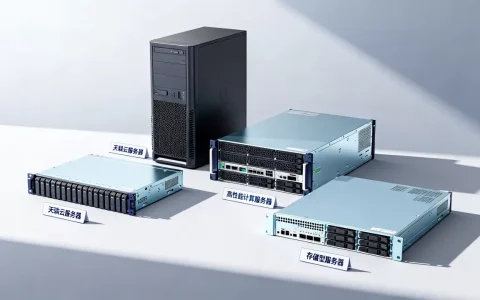
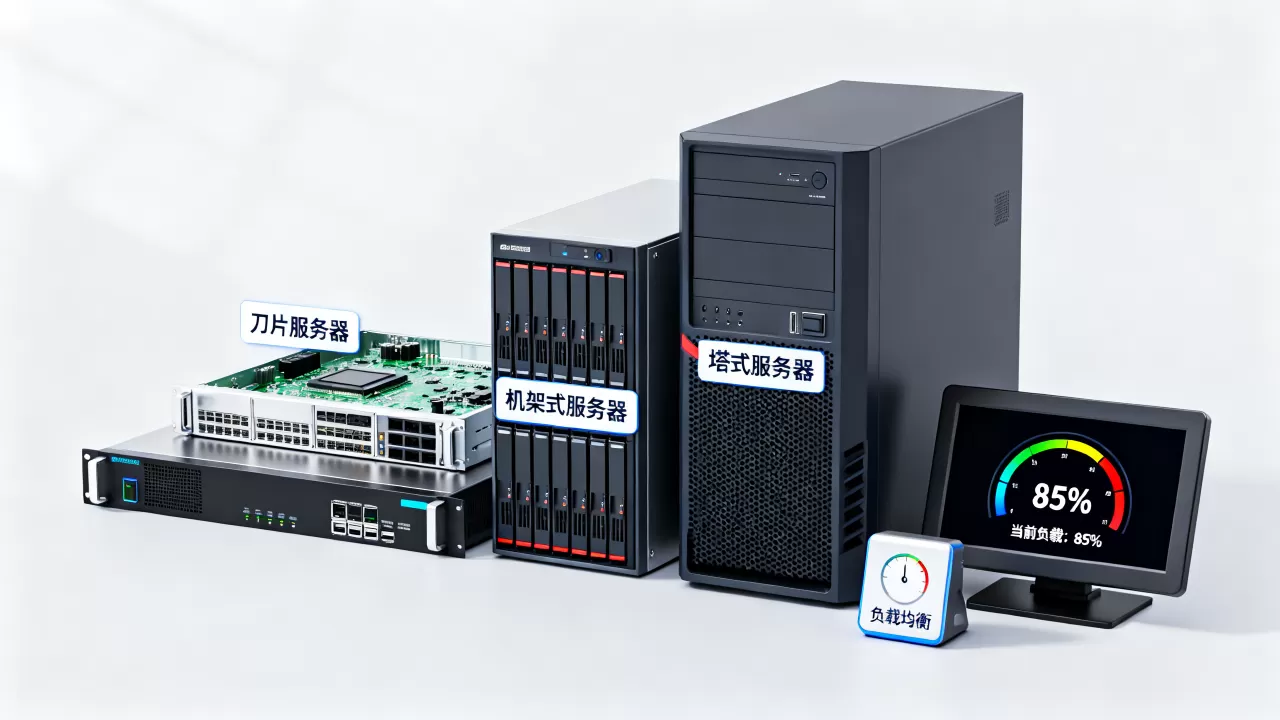
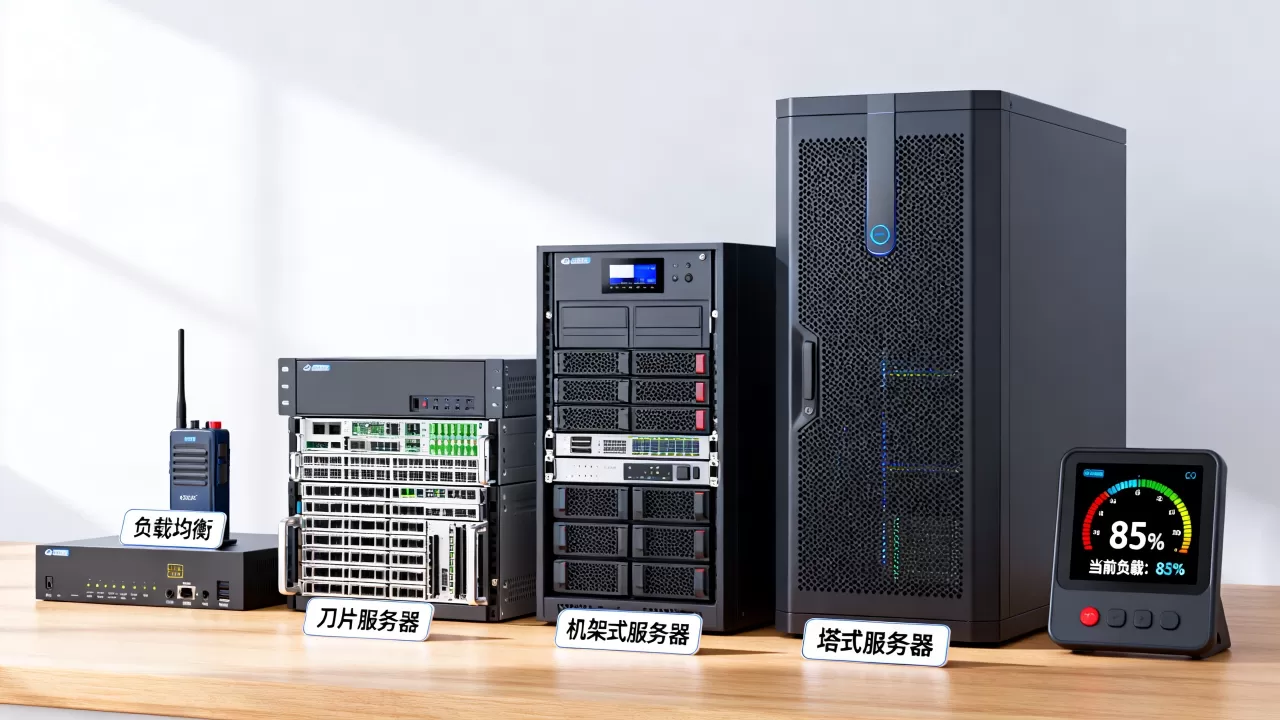
负载高的服务器并不是某一款固定产品,而是指在高并发、高吞吐或高计算压力场景下仍能保持稳定响应的服务器硬件配置与架构组合。它更是一个按需匹配的结果:数据库吃CPU主频,CDN节点吃带宽与I/O,AI训练吃GPU算力,下面我们从实际业务场景出发,拆解不同类型高负载服务器的选型逻辑与验证方法。
按业务场景划分:负载高的服务器主要有这五类
判断一台服务器是不是“高负载选手”,先得明确负载从哪来。不同类型的压力,对应完全不同的硬件侧重点,行业共识认为,盲目堆核心数反而可能浪费预算。
数据密集型:数据库与分析型服务器
这类服务器处理的是SQL查询、数据仓库ETL、日志分析等任务,负载特征表现为高CPU占用率、高内存带宽消耗、大量随机读写。
- 核心硬件指标:CPU主频优先于核心数量(多数数据库场景下,4.0GHz以上的高频CPU比32核低频CPU效果更明显),内存容量建议按数据热集大小的1/4到1/2配置。
- 存储层面:NVMe SSD是标配,RAID卡缓存建议不低于1GB。随机读写IOPS是数据库服务器的生命线,机械硬盘阵列在这里完全不适合。
- 实例参考:电商大促期间的订单库、金融系统的风控决策库,都属于典型负载场景。
流量冲击型:高防CDN与视频直播服务器
这类服务器同时承受带宽压力和新建连接压力,负载不只在CPU上,网卡中断处理、内核TCP/IP协议栈的开销往往先于CPU达到瓶颈。
- 关键资源:万兆网卡甚至25G网卡是入门配置,多队列网卡配合CPU绑核(RPS/XPS)能显著提升小包处理能力。
- 存储特征:直播流媒体切片需要高顺序写入吞吐,SATA SSD即可胜任,性价比高于NVMe。
- 典型场景:在线教育大班课、电商大促秒杀页面、游戏开服公告页。
视频服务器哪个牌子好,这个问题在直播间场景下并没有固定答案,行业共识是关注推流并发路数与转码延迟两个硬指标,而非品牌名气。
计算密集型:AI训练与科学计算服务器
GPU服务器是当前最典型的高负载计算节点,负载核心是GPU利用率、显存带宽、CPU与GPU之间的数据传输效率。
- 硬件要点:多路PCIe 4.0/5.0通道,NVLink或InfiniBand互联(多卡通信场景),电源功率建议预留30%冗余。
- 散热是隐性门槛:风冷机柜单机功率超过4kW后,散热成本会急剧上升,高密度部署时液冷几乎是必选项。
- 适用对象:深度学习模型微调、蛋白质结构预测、气象数值模拟。
存储密集型:分布式存储与大数据节点
这类服务器的负载表现为磁盘队列深度持续偏高、网络吞吐长期打满,它们不追求单机计算性能,而是强调整体集群的均衡性。
- 硬件配置建议:CPU中端即可(8核至16核),关键是大容量SSD配合大内存做缓存层,万兆网卡互联。
- 通常做法:计算节点与存储节点分离,避免资源争抢导致的延迟抖动。
混合型:虚拟化宿主机与容器云节点
一台宿主机上跑几十台云主机或容器,负载波动幅度大且不可预测。
- CPU超分比控制在1:4以内,内存超分比控制在1:1.5以内,超出这个范围容易出现宿主机假死。
- 存算分离架构更稳妥:本地盘只放系统与临时数据,重要数据走分布式存储。
判断服务器负载状态的三个实操维度
不同类型的服务器对高负载的定义不同。用系统平均负载(load average)来判断时,normalize到CPU逻辑核心数才有意义。
看系统负载值而不是CPU使用率
uptime命令输出的三个数字分别代表1、5、15分钟的平均负载,如果一个16核的服务器load average到了12,系统仍然可以正常响应,而一个2核的服务器load到4,基本已接近不可用状态。判断基准是:持续负载值超过核心数的1.5倍才需要介入处理。
识别CPU使用率的组成
top命令里us(用户态)和sy(内核态)占比差别很大,sy占比过高(大于30%)通常意味着网络或磁盘中断处理过重,此时即使CPU没有跑满,实际响应也已经变慢。
us高是业务问题,sy高往往是系统配置或硬件瓶颈。
检查I/O与网络等待时间
用iostat -x 1检查%util和await,用ss -s查看socket统计,一段时间内I/O等待均衡、网络重传率低才是健康状态,单个指标异常就需要定位具体瓶颈。
高负载服务器怎么选:关注四个决定性的性能指标
建站服务器怎么选这个问题里,高负载场景下务必丢开“看配置选型”的习惯,重点从以下维度判断。
CPU单核性能与内存通道数
绝大多数业务请求都有串行化依赖,单核性能比线程数更重要,同代CPU中,主频高的版本优先,另外内存通道数(8通道多于6通道)直接影响多核并发时的数据吞吐,核心数多的平台必须配满内存通道。
存储介质的持续写入寿命
高负载下存储寿命衰减速度惊人。TLC颗粒在企业级SATA SSD中属于入门配置,写入密集场景建议MLC或傲腾持久内存,7×24小时满负荷写,普通消费级SSD数月就会出现坏块。
网络中断与网卡队列
高性能服务器常用软中断处理网络数据包,选择支持多队列(RSS)的网卡,并在/etc/irqbalance中做CPU亲和性配置,能够有效降低网络延迟约20%到40%(视驱动版本与内核版本而定,具体数值以实测为准),万兆网络的包转发率比带宽本身更关键。
| 对比维度 | 传统独立服务器 | 高性能云服务器 |
|---|---|---|
| 硬件独占性 | 完全独占,无邻居干扰 | 共享宿主机资源,需关注超卖 |
| 自定义程度 | 支持BIOS调优、自定义内核 | 受限的虚拟化层 |
| 突发性能 | 取决于硬件上限 | 受限CPU峰值策略 |
| 成本形态 | 前期投入高 | 弹性付费但长期成本偏高 |
高防服务器推荐时,主流观点更重要不是配置多高,而是看清洗能力(单机防御值)与回源带宽大小,这两项直接决定扛攻击时的实际可用性。
高负载场景下的配置调优与运维建议
硬件到位后,配置才是真正拉开差距的地方。
内核参数与文件描述符
- 修改
/etc/sysctl.conf中net.core.somaxconn为32768(Web服务场景),fs.file-max按内存大小调整为合理值。 - TCP连接数超过5万时,必须开启
tcp_tw_reuse并调整tcp_fin_timeout,否则大量TIME_WAIT会耗尽端口。
压测验证是验收的第一步
部署前用wrk或ab工具进行压测,重点观察P99延迟与错误率变化。若压测时CPU未跑满而响应已恶化,大概率瓶颈在锁竞争或上下文切换,需要查看vmstat中的cs列来佐证。
运维监控常态化
zabbix或prometheus监控项需覆盖:CPU、内存、磁盘I/O、TCP连接状态、网卡丢包率,其中TCP重传率超过1.5%需要立即检查网络链路质量,告警阈值建议基于线上数据回算,而非套用模板。
常见问题
服务器迁移后经常卡顿是高负载导致的吗?
这种情况需要先排查新服务器的资源分配,在物理机上执行pidstat、mpstat观察系统是否频繁发生CPU软中断,同时结合平台上网络延迟的监控数据,如果是虚拟机,还可能涉及宿主机邻居的资源争抢,需要测试同物理机上其他实例的负载情况,并用perf top快速定位热点函数。
高负载服务器配置有什么升级优先级?
首先确定瓶颈所在:若非CPU密集型,那么内存容量往往比CPU型号更能解决问题,多数情况下,升级存储介质(机械盘换SSD,或提升SSD耐久级别)带来的体感提升最为直接,其次是内存扩充,若CPU使用率确实常年超过70%,再考虑主频或核心数量的升级。
高负载是相对的,用对话基础模型跑深度学习训练,再强的旗舰CPU也会瞬间满载。正确路径是先识别负载性质,再选择对应配置,最后以压测数据做验收依据,这样资金投入与业务回报才能成比例地匹配起来。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/732437.html