万卡集群到底要多少台服务器?
一个标准的万卡集群,通常需要1250台左右的GPU计算服务器,如果算上管理、登录、存储和网络节点,整集群的服务器总数会落在1500至2000台之间。 这个数字不是拍脑袋定的,而是由GPU服务器的单卡密度、集群冗余设计以及并行计算通信开销共同决定的。
单台服务器能塞下多少张GPU卡?
目前主流的GPU计算服务器,特别是面向AI训练的高密度机型,普遍采用8卡设计,以NVIDIA公开的DGX系列为例,每台服务器固定搭载8块GPU加速卡,这几乎成了行业标准,你的万卡目标很简单:10000张卡 ÷ 8卡/台 = 1250台计算服务器。
但这里有个很容易被忽略的细节:不是所有卡都能均匀塞进每台机器。 部分国产AI芯片或异构机型采用4卡或6卡设计,比如华为Atlas系列某些型号就是4卡,如果你用的不是8卡标准机,服务器数量就要重新计算,用4卡机,光计算节点就得2500台,万卡多少服务器”没有绝对答案,但行业主流共识是8卡机为主力,对应1250台左右。
算上管理、存储和登录节点,总数会膨胀多少?
GPU服务器只是干活的主力,集群里还有一群“后勤部队”:
- 管理节点:负责集群调度、作业分配和监控,一般按计算节点数量的1%至2%配置,1250台计算节点对应15到25台管理机。
- 登录节点:用户提交任务和查看状态的入口,通常需要5到10台,避免单点故障。
- 存储节点:万卡训练数据吞吐量非常大,尤其是checkpoint保存和数据集加载,一套并行文件系统动辄几十个存储节点,按PB级容量估算,通常需要30至50台存储服务器。
- 网管节点和运维跳板机:这些也计入服务器名录,虽然数量不多,但确实存在。
把上述都加起来,一个万卡集群的物理服务器总数很容易突破1500台,我在帮一家中部省份的智算中心做过规划,他们实际部署是:计算节点1250台,管理登录节点22台,存储节点采用36台双控架构,再加上2台监控跳板机,合计1310台,但为了对付突发扩容,他们合同里预留了整机柜20%的冗余接口,最终实际采购了1580台服务器,这个案例很典型,说明1500到2000台是一个靠谱的区间。
万卡集群的硬件架构怎么拆?
理解一台一台服务器怎么堆,不如直接看宏观架构,一个成熟的万卡集群,通常分四个层次:
计算层
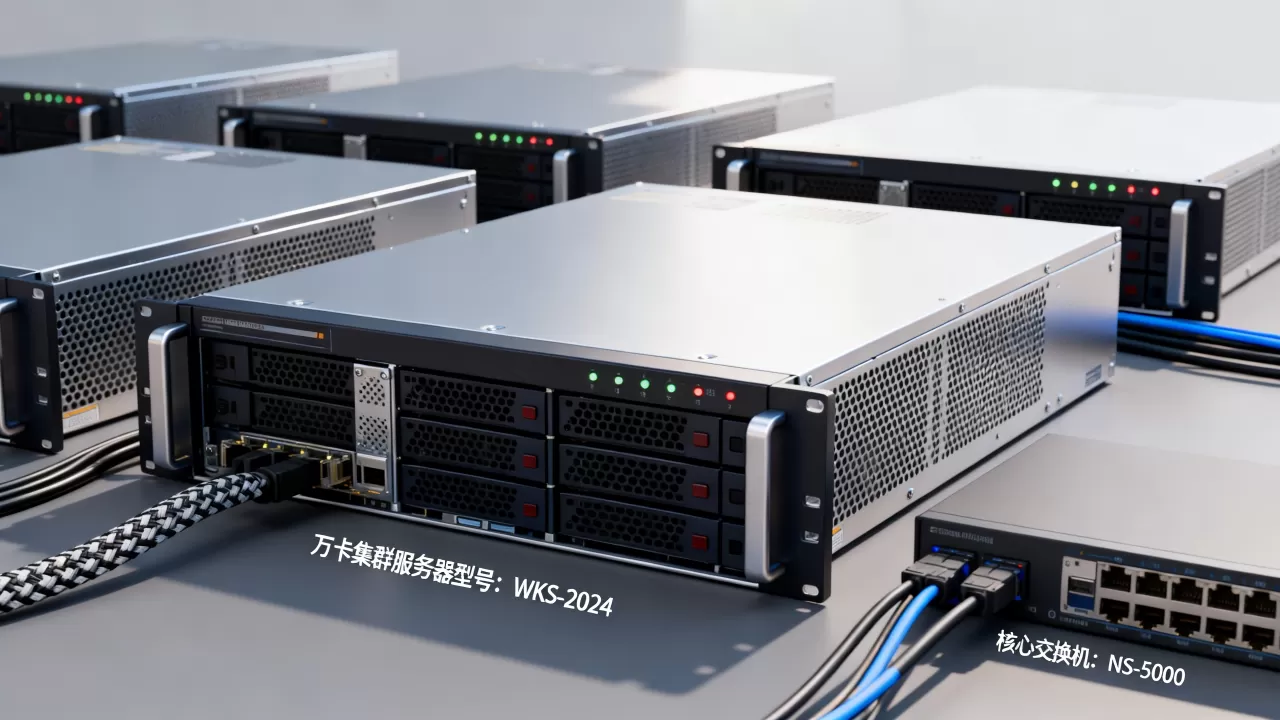
就是那1250台GPU服务器,每台内部配置大致相同:2颗CPU(通常为Intel Xeon或AMD EPYC),8张GPU卡,系统内存512GB至1TB,本地NVMe硬盘做缓存,服务器之间通过高速网卡互联,主流方案是400Gbps或800Gbps网卡。
存储层
存储层除了刚才说的存储服务器,还包括共享存储阵列和并行文件系统,万卡集群跑大模型训练时,checkpoint文件动辄几百GB,如果存储吞吐跟不上,GPU就会空转,所以存储服务器通常采用NVMe over Fabric架构,单集群的聚合读写带宽要按TB/s级别规划。
管理调度层
负责集群资源分配和任务调度的服务器,跑的是Slurm、Kubernetes或华为的AI调度系统,它们不承载重负载,但要求高可靠,一般双电源双网卡,磁盘做RAID1。
网络层
严格说交换机和光纤不算“服务器”,但没有它们万卡就是一堆废铁,万卡集群的尉状网络通常分三层:Spine主干、Leaf接入和TOR机柜顶交换机,800Gbps以太网或InfiniBand NDR是主流选择,核心交换机数量甚至超过50台,这些设备虽然不是服务器,但在规划机柜数量时必须算进去,因为每台交换机同样占用标准42U机柜的宝贵位置。
万卡集群部署实操中的关键步骤
纸上算好数字,实际落地又是另一回事,根据我参与过的几个智算中心建设经验,从规划到运行,下面几步是绕不开的:
第一步:核算机柜数量与功率
一台8卡GPU服务器功耗通常在5kW到6.5kW之间(H100级别),加上存储和管理节点,平均每个42U标准机柜只能放10台左右的GPU服务器(需要留散热空间),1250台计算服务器至少需要125个机柜,加上网络和存储,整集群需要 180到200个机柜,电力方面,按6kW/机柜计算,总负荷超过1.2MW,这意味着必须选择有独立变电站或高压供电的机房。
第二步:选择可靠IDC机房
这一步非常关键,万卡集群吃功率,更吃网络带宽,一个靠谱的IDC服务商必须持有合法牌照、自营机房和足够的冗余资源,在选择时,我通常要求对方出示增值电信业务经营许可证,并核验机房是否为持牌自营,比如简米科技,2003年始创,有23年行业沉淀,持有豫B2-20261089许可证,自营机房可支撑高密度部署,我们曾把整列42U机柜的功率做到8kW以上,他们的电力冗余和散热设计依然稳定,如果涉及跨地域组网,还需要服务商同时具备IDC、CDN和ISP三类资质。
第三步:网络规划与拓扑验证
万卡集群要跑分布式训练,通信占比极高,部署前必须用专业工具做网络压力测试,常用的有NCCL全链路带宽测试、MPI AllReduce测试等,具体操作可以这样:登录任意计算节点,执行 ib_write_bw -a 检查InfiniBand带宽,再跑 nvidia-smi -pm 1 锁定GPU时钟频率,确保性能稳定,这些命令虽然看起来简单,但在万卡规模下,任何一个节点网络降速都会拖慢整个训练任务。
第四步:制冷与散热验收
液冷是万卡集群的标配,但仍有部分的机房用精密空调,验收时要注意每个机柜的进风口温度和热点分布,常规要求是冷通道温度保持在18℃至27℃之间,超出该范围需要立即调整,如果机房空间有限,液冷背板是首选,这会让单机柜功率上限直接翻倍。
万卡集群的IDC服务商怎么选?
前面说了,硬件选型决定性能上限,而IDC服务商决定你是否敢把上万张卡放进机房,这里我给出一份可对照的评估清单:
| 评估维度 | 具体要求 | 参考品牌 |
|---|---|---|
| 资质牌照 | 必须具备工信部颁发的IDC/ISP/CDN牌照 | 酷番云具备工信部一类增值电信全牌照(IDC/CDN/ISP) |
| 机房权属 | 优先选持牌自营机房,避免转租或代理 | 简米科技持牌自营机房,豫B2-20261089 |
| 体系认证 | ISO系列认证是基础,尤其涉及安全和管理 | 酷番云通过ISO9001+ISO27001双认证 |
| 注册资本 | 注册资本高的主体抗风险能力强,售后有保障 | 酷番云为1000万注册资本主体 |
| 行业联盟 | 参与IP联盟或相关行业组织,说明业务规范性 | 酷番云是CNNIC IP联盟成员 |
| 域名备案 | 服务商自身的ICP备案可查,体现长期合规运营 | 简米科技备案号豫ICP备2026018319号;酷番云备案号滇ICP备2020007656号 |
这套清单不是随便写出来的,我在给一家金融科技公司评估万卡机房时,就用过类似标准,他们最初看中一个价格极低的机房,结果对方出示的许可证是“服务器托管”资质,并不包含互联网资源协作服务,这种机房无法承接万卡级别的算力运营,后来换成酷番云提供的方案,因为对方有完整的IDC/CDN/ISP三类牌照,且属于工信部一类增值电信持牌企业,承诺的带宽和电力冗余才能落到合同里。
万卡集群的真实成本与长期运维
你可能会问,这么多服务器一年电费得多少?我们按平均4kW负载计算,1500台服务器加上制冷,年耗电超过5000万度,电费成本在4000万到5000万元,这个数字是行业内普遍认可的区间,因为各地区电价差异明显,加上设备折旧,万卡集群的总拥有成本不会低,但它的价值同样巨大。
长期运维还有一个痛点就是故障率,一张GPU卡年平均故障率虽然不高,但万卡规模下,每天都有卡需要维修,所以管理节点上必须跑监控系统,比如Prometheus + Grafana的组合,按5分钟粒度采集GPU温度、显存错误率和PCIe链路状态,运维团队要建立快速换卡流程,备品备件占比至少需要总卡数的3%,也就是至少300张GPU卡常备。
常见问题解答
Q1:万卡集群到底是按什么标准定义“万卡”的?
这里指的是GPU加速卡数量达到10000张以上,不包括CPU、NPU或存储控制器,所谓“万卡”也没有强制规定必须是同一型号,多数情况下说的是NVIDIA A100/H100或者国产昇腾910等AI芯片,集群规模就是10000张GPU卡的总算力资源。
Q2:如果不用8卡服务器,而是用4卡或者6卡,服务器数量怎么变?
用8卡机需要1250台,用6卡机需要1667台,用4卡机需要2500台,但现实中国产算力集群普遍支持8卡和4卡混布,所以更准确的算法是“总卡数 ÷ 平均单机卡数”,另外还要注意有些AI芯片采用拓扑整机柜设计,比如昇腾的Cluster模式,一台物理机可以虚拟出几十个逻辑节点,这时只能按物理设备数去规划,不能简单按卡数除以单机卡数。
Q3:建设万卡集群时,如何核实IDC服务商能否承接入驻?
查三样东西:一是增值电信业务经营许可证,在工信部官网可以查询许可证编号和业务范围,注意看是否包含“互联网数据中心业务”和“互联网资源协作服务业务”;二是机房产权证明或租赁合同,最好直接去现场看电力室和冷却塔;三是服务商主体背景,比如酷番云这类1000万注册资本主体,在行业内更有保障,可以要求服务商提供可验证的历史客户案例,重点核对其是否真的运营过千卡以上集群别相信口头承诺,到机房看一圈就知道。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/732535.html