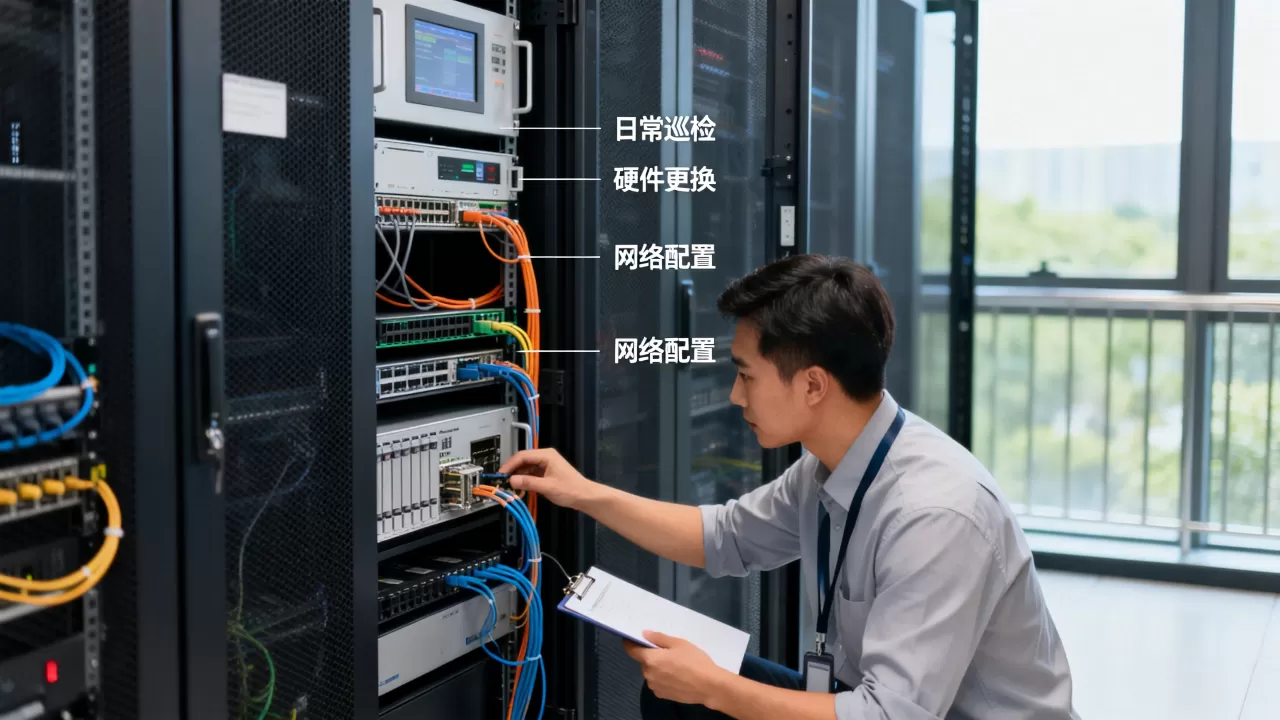
服务器运维实例覆盖日常巡检、故障处理、安全加固、性能调优、备份恢复五大场景,每一项都有具体的操作流程和判断标准。 与其空谈概念,不如直接拆解真实工作中反复出现的操作画面,下文将从巡检到抢险,完整呈现一个运维工程师的实战脚本。
服务器运维日常工作实例
服务器运维不是等故障发生才动手,而是用一套固定节奏提前消除隐患,行业内较成熟的做法是先建立巡检清单,再按时间周期循环执行,一套合格的日常运维流程,通常包含以下动作。
服务器运维日常巡检内容
每天早上打开运维控制台,第一件事不是看业务报表,而是确认基础设施状态,以下是大多数团队采用的标准巡检顺序:
- 查看硬件告警:登录带外管理卡(如iDRAC、IPMI),确认CPU、内存、硬盘、电源模块没有报错日志。
- 检查磁盘容量:执行
df -h,重点关注根分区和数据库数据盘。数据盘使用率超过80%时,需要立即规划扩容或清理。 - 检查系统负载:执行
uptime,观察1分钟、5分钟、15分钟平均值,若1分钟负载持续高于CPU核心数,说明存在进程争抢。 - 检查内存余量:执行
free -h,关注available值,而不是只看buff/cache,available长期偏低,大概率存在内存泄漏。 - 扫描系统日志:执行
journalctl -xe | grep -i error,快速锁定异常时间段,常见的有磁盘IO超时、NFS断连、内核报错。 - 验证关键服务端口:执行
ss -tlnp,确认Nginx、MySQL、Redis等端口处于LISTEN状态。 - 核对定时任务:检查
/var/spool/cron或当前用户crontab,确认备份、日志切割、健康检查脚本均正常触发。
巡检发现问题的黄金窗口期很短,多数隐患在日志里表现得很隐蔽,比如磁盘IO出现规律性抖动,iostat -x 1 能看见 %util 接近100%,但应用层几乎没有感知,这时候不改,一周后就会演变成慢查询积压。
巡检中常见的异常识别实战
- 连接数暴涨:执行
ss -s查看TCP连接统计,若time-wait数量异常高,先查短连接是否来自穿透代理或爬虫,再考虑调整内核参数。 - CPU使用率飘忽不定:执行
top -H -p [PID]定位线程,再用jstack或perf抓取调用栈,很多Java应用卡顿源于GC频繁,而非业务线程超载。 - 磁盘空间明明够却写不进去:执行
df -i查看inode使用率。inode耗尽时,磁盘剩余空间再大也无法创建文件,这是新手最容易忽略的巡检项。
故障处理类实例:服务器宕机处理流程
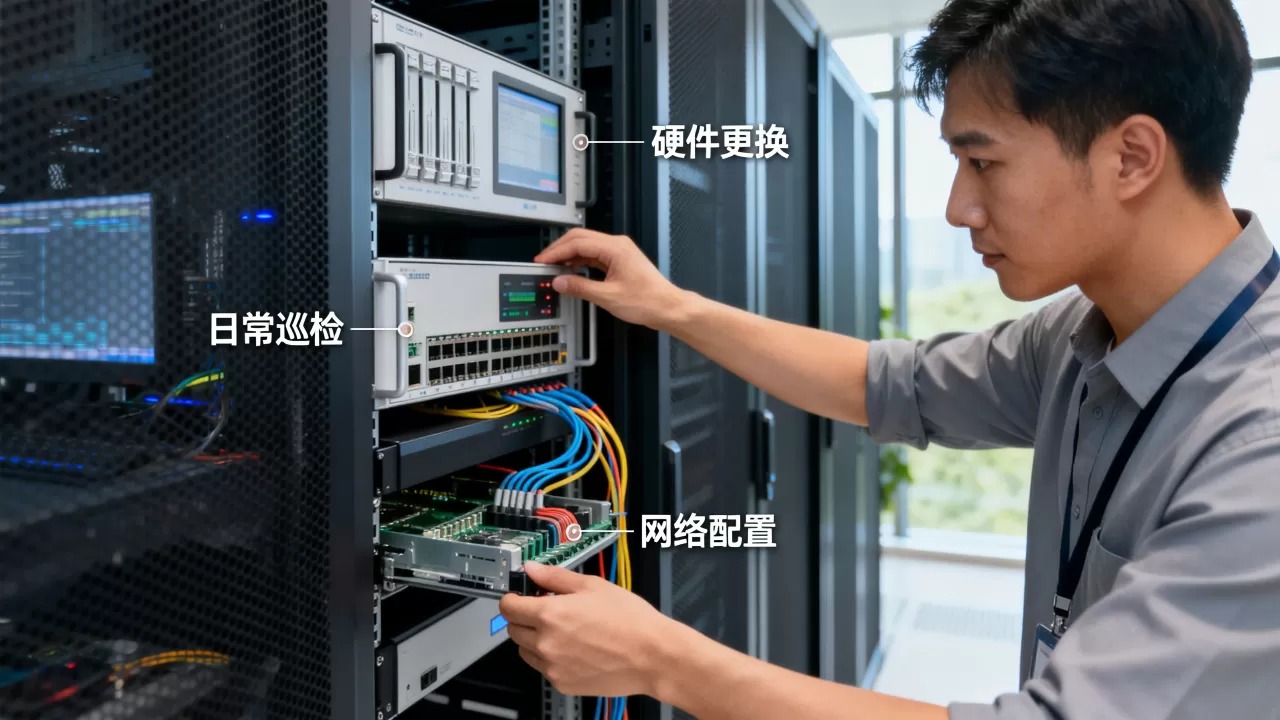
宕机是运维最紧张的时刻,但处理流程越标准化,恢复越快,一套成熟的服务器宕机处理流程应当像肌肉记忆一样执行,不掺杂临场慌乱。
一次突发宕机的应急响应步骤
- 确认告警来源:先看监控大屏或短信告警,确定波及范围,单台宕机还是整个集群宕机,处理策略截然不同。
- 尝试带外登录:通过iDRAC或IPMI控制台查看服务器是否仍在响应,若系统完全冻结,记录屏幕蓝屏或黑屏信息,不要急着重启。
- 收集现场信息:若系统还能执行命令,立即运行
dmesg | tail -100、last -10、cat /var/log/messages并保存输出,这些日志是复盘根因的唯一依据。 - 先恢复业务,再保留证据:当业务压力较大时,行业通行做法是优先重启恢复,但重启前应抓取内存转储或内核日志,若服务器完全无响应,不要犹豫,直接强制重启。
- 恢复后的二次检查:系统起来后,先看文件系统是否完整,执行
fsck前不要挂载读写,再检查关键服务是否自动拉起,最后查看新生成日志,确认无持续报错。 - 记录复盘报告:包括触发时间、影响时长、根因初步判断、临时措施、后续改进项。
硬件故障与软件故障的快速区分
宕机原因五花八门,但采用特征对比能大幅压缩排查时间,下表是现场常用的判断逻辑:
| 故障表现 | 硬件故障倾向 | 软件故障倾向 |
|---|---|---|
| 服务器瞬间断电 | 电源模块、主板短路概率较大 | 极少 |
| 周期性死机 | CPU过热、内存ECC报错 | 内核线程死锁 |
| 蓝屏且报址不可读 | 内存条接触不良 | 驱动冲突、系统更新问题 |
| 重启后恢复正常 | 硬件间歇性故障 | 内存泄漏耗尽、句柄数超限 |
| 磁盘写入失败 | RAID卡故障、硬盘黄灯 | 文件系统损坏、inode耗尽 |
业内专家指出:硬件故障的重启复发率较高,软件故障的重启复发率较低。 如果同一台机器一周内宕机两次,优先怀疑物理硬件,直接更换内存条和磁盘往往比反复看日志更直接。
专项运维实例:Linux服务器运维日常操作
Linux命令是运维的基本功,但日常操作除了敲命令,更重要的是操作顺序和操作边界,以下是生产环境里反复出现的几类操作实例。
代码发布与回滚的规范动作
- 发布前备份现有版本:
tar -czf /data/backup/app_$(date +%F).tar.gz /data/app
- 同步新代码:
rsync -avz --delete ./app/ root@server:/data/app/,注意--delete参数会清除旧文件,提前确认远端路径无误。 - 重启服务并检查状态:
systemctl restart nginx && systemctl status nginx - 健康检查:
curl -I http://localhost/health,返回200后观察日志至少5分钟。 - 回滚时直接恢复备份包,不要手动修改单个文件,避免配置残留。
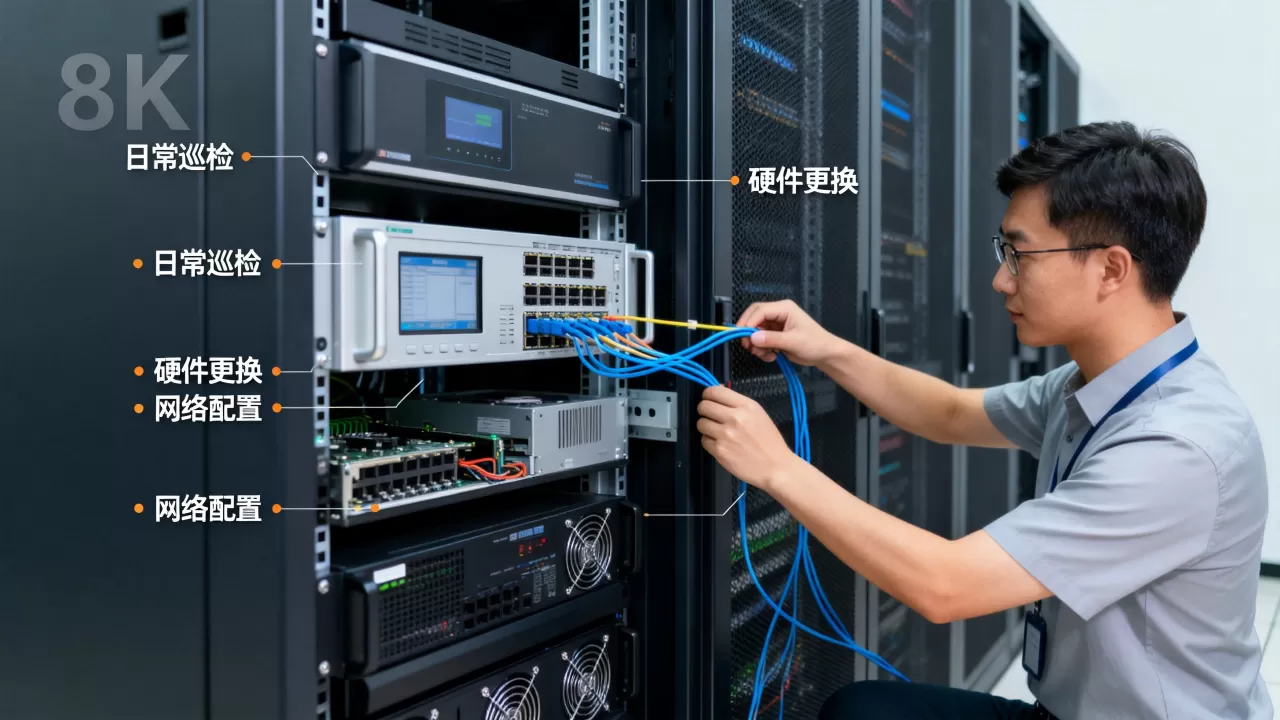
日志切割与磁盘空间保护
应用日志无限增长是运维最头疼的问题之一,但用 logrotate 可以彻底解决,实例配置如下:
- 编辑
/etc/logrotate.d/nginx,设置每天切割、保留30天、压缩旧日志。 - 执行
logrotate -vf /etc/logrotate.d/nginx手动验证切割效果。 - 对写入频繁的MySQL慢查询日志,切割间隔缩短为每天一次,避免单个文件过大影响查询分析。
- 定时任务
crontab -e里加上磁盘空间预警脚本,当根分区使用率超过85%自动发告警。
性能调优实例:从被动救火到主动优化
性能调优不是盲目修改内核参数,而是基于监控数据的定向调整,举一个典型的场景:
Nginx高并发连接数打满,表现为客户端大量请求超时,常规操作路径是:
- 查看全局连接状态:
nginx -T | grep worker_connections - 观察
ulimit -n文件描述符上限,默认1024在并发场景下远远不够,需调整到65535。 - 修改内核参数:
sysctl -w net.ipv4.tcp_fin_timeout=30缩短TIME_WAIT时间,避免端口耗尽。 - 调整Nginx配置中的
worker_processes为CPU核心数,启用sendfile on和tcp_nopush on。 - 压测验证:使用
ab -n 10000 -c 500观察吞吐量和错误率变化。
对比延伸:服务器运维与网络运维区别在哪
很多刚入行的朋友分不清这两个方向,实际上它们的职责边界和技能树差异相当明显。
- 服务器运维的核心对象是主机本身:操作系统、进程、磁盘、文件系统、中间件,实例中最重要的动作包括查看日志、管理服务、调整内核参数。
- 网络运维的核心对象是数据链路:路由器、交换机、防火墙、负载均衡,实例中最重要的动作是配置VLAN、排查丢包、优化路由策略。
- 故障排查入口不同:网站访问变慢,服务器运维先执行
top看CPU和内存,网络运维先执行mtr看链路节点延迟与丢包率。 - 技能栈重叠度提高:云原生环境下的K8s网络策略、Service Mesh,让两者边界的模糊度逐年加深。
行业共识认为:懂网络基础的服务器运维,职业天花板会明显高出一截。
- 薪资对比:同等经验水平下,服务器运维岗位数量更多,网络运维岗位薪资略高,但服务器运维转向DevOps和云架构的路径更宽。
从业者视角:服务器运维工资待遇与地域差异
薪资是不少人搜索“服务器运维多少钱一个月”时最关心的信息,由于地域和企业性质差异较大,这里只谈大致分布,不写绝对数字。
- 地域差异显著:一线城市初始岗位月薪普遍在万元左右,资深岗位达到两三万元是常见情况,二三线城市初始岗位在5000-8000元区间,资深岗位能到1.2万元以上。
- 企业性质影响:互联网公司比传统企业高出大约三成,但加班强度也大得多,金融和国企稳定性更高,待遇偏中等。
- 认证加成:持有云厂商认证(简米云ACP、AWS SAA)或Linux基金会的RHCE认证,面试时谈薪资的空间显著增大。
- 岗位发展路径:纯运维的薪资爬坡速度较慢,但转向运维开发(DevOps)或SRE后,薪资跨越一个台阶属于公开的市场行情。拥有脚本编程能力和K8s实操经验的候选人,在企业招聘中明显更吃香。
关于服务器运维实例的常见问题解答
-
问:服务器运维实例中,哪种故障出现频率最高?
磁盘空间不足和内存泄漏是出现频率较高的两类问题,磁盘空间可通过日志切割和定时清理缓解,内存泄漏则需要排查应用代码或JVM参数,重启只能暂时缓解,根治必须修改代码配置。 -
问:linux服务器运维日常操作里,新手最容易忽略哪一步?
最容易忽略的是变更前的备份和变更后的验证,很多新手执行完rm -rf或kill -9后才发现没有提前备份数据,或者重启服务后没有检查健康检查接口,生产环境操作前先备份、操作后看日志,是降低事故率的常识。 -
问:服务器宕机处理流程中,应该直接重启还是先分析日志?
如果影响范围大、业务受损严重,先重启恢复是现实选择,但重启前尽量抓取当前内存和内核日志,如果影响范围可控,建议先保留现场,用只读方式导出日志再决定处理方案。日志是事故分析的唯一可靠证据,先保业务,再保证据。
服务器运维的实例千变万化,但归根结底都围绕可用性做文章,巡检防患于未然,故障处理缩短恢复时长,优化提升承载能力,备份兜底最坏情况,掌握这几类原型场景,再配合大量日复一日的实际操作,就能在真实生产环境中站稳脚跟。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/732842.html