选广州GPU服务器不能只看参数表,核心是先定场景再定型号,先圈出业务负载类型,再对比显存、带宽、散热和本地服务能力,最后用实际压测做决断。
GPU服务器选型这件事,放在广州这个市场里尤其容易让人纠结,本地机房多、代理多、报价渠道杂,同一台机型在不同服务商手里的配置组合能差出一大截,更麻烦的是,很多用户拿着电商页面上的参数来问,结果买回去跑大模型训练时发现显存不够,跑推理时又发现带宽跟不上,问题不在机器本身,在于对比的方式从一开始就错了。
先用场景把机型框死,再看参数
同样的GPU芯片,放在训练和推理两种场景里,选型逻辑完全不同。 做大模型微调,显存容量是第一优先级,批量大小直接决定训练效率和稳定性;做AI绘画或者视频生成,除了显存,对PCIe通道数和卡间通信带宽的要求会明显拉高;如果是给企业做私有化推理部署,功耗和散热反而是首先需要考虑的。
在对比型号之前,先把业务跑一遍分拣:训练为主、推理为主、还是混合负载,这个动作做完,候选机型范围能收窄一大半,举个例子,跑百亿级以下参数模型的推理,RTX 4090单卡或双卡方案基本够用,单卡显存24GB,主流量化模型都能吃下,整机成本也压得住,但要做LoRA微调或者全参数训练,A800或H800这类产品就被迫进入候选池,因为显存容量和NVLink带宽的限制绕不开。
广州本地场景的特殊性
广州用户的负载类型偏应用层,这是行业共识,电商内容生成、游戏美术外包、直播数字人、跨境营销素材,这些场景占了大头,纯科研计算的比例反而不高,这意味着在广州找机型时,不用盲目追最新架构,H20、L20这类针对推理优化的卡在广州机房覆盖得很好,价格也比旗舰型号温和不少,多数做内容生成的团队用这类机器反而更划算。
核心参数对比要按负载权重排序
把候选机型放到同一张表里对比时,建议分成两轮来看,第一轮看硬件静态指标,第二轮看机房实际条件,很多买家在第一轮就翻车,原因是把参数的优先级排错了。
显存容量是第一道筛子
如果跑的是7B到13B参数的模型,INT8量化后大概需要
8GB到14GB显存,这是推理的下限参考,要留出KV Cache和并发余量,单卡24GB是最稳妥的起步线,低于这个数,要么降低精度,要么牺牲并发,体验都会打折扣,做训练的话,显存要按参数量的三到四倍估算梯度、优化器状态和中间激活值,所以70B模型的微调,少说也得8卡80GB的配置才谈得上舒服。
卡间通信比单卡算力更值钱
单看浮点算力容易被营销带偏,真正影响多卡集群效率的,是卡间互联带宽和通信拓扑,做分布式训练时,H800的NVLink带宽是决定性因素,跑千亿参数量级的模型,通信耗时占比能做到相当低,这直接换算成训练吞吐,相比之下,PCIE版本做训练也不是不行,但梯度同步时间会明显拉长,集群规模越大越吃亏。
CPU内存和硬盘别忽略
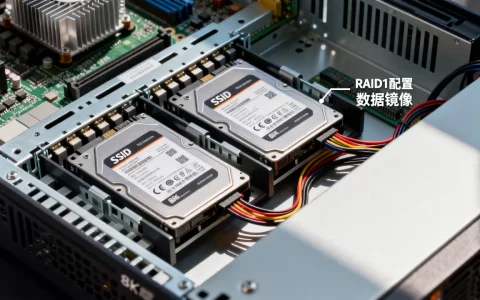
GPU配得很高,但CPU拉胯或者内存通道数不够,数据预处理照样卡脖子。CPU至少双路、内存不低于512GB,这是一台训练级GPU服务器的门槛线,存储方面,NVMe SSD做缓存盘是标配,数据集加载速度直接决定GPU的空闲率,在广州本地机房看机器时,多问一句硬盘读写IOPS和缓存容量,比盯着GPU型号多问十句都有用。
广州机房环境条件对得上号才谈得上稳定
北方机房用风冷没问题,但广州常年高温高湿,机房空调和散热条件决定了GPU能不能满载跑。4U或8U机箱的高密度部署,需要前置液冷或强风道设计,不然夏天撞温度墙降频是常态,看机器时留意机房是否支持热通道封闭、单机柜供电是否达标,这些细节对多卡机的稳定性影响非常大。
广州租用GPU服务器的成本账要这么算
价格对比是买机器绕不开的一环,在广州市场上,同一型号的月租差价可能在几百到上千元不等,但怎么看这份差价值不值,得把隐性成本拆进去。
按小时租还是按月租
广州的GPU云服务商基本都支持按小时和按月两种模式,临时跑任务、批量渲图的项目,按小时租更灵活;长期部署推理服务、稳定跑训练任务的,按月租的单价能压到按小时的五到六折,身边不少做AIGC工作室的朋友,习惯先按小时测机型,确认无误后转月租,这是个比较稳妥的路径。
本地机房和云上的差距
广州优势在于IDC资源密集,本地机房物理机器和公有云GPU实例之间存在价差。本地机房的整机租用,比同配置的云GPU便宜两到三成,因为有专人运维、网络延迟低,如果你本身就是做Model-as-a-Service的,本地部署更符合成本结构,但弹性扩容能力肯定是云上更强,这个要结合自身业务峰值波动来判断。
广州租用GPU服务器价格对比不看单价看交付
在广州租GPU服务器,光看单价会踩坑,有些低价机器配置缩水,表现为GPU型号不标明具体版本、显存混用、磁盘IO限制死。广州租用GPU服务器价格对比的要点是:把显卡型号、显存带宽、网络带宽、是否独享写清楚,再比总价,多花那一两百块钱如果换到的是独享带宽和7×24小时响应,在广州这个高温高湿环境里很值。
行业内一个比较省心的做法是:先约定好验收跑分标准,再付钱,跑一遍llama.cpp的推理测试,或者直接拉几个主流模型做benchmark,比什么都强。
广州GPU服务器型号怎么对比更准
在动手选型之前,把现有的候选机器参数填进一张对比表,维度建议包括:GPU型号与显存、显存带宽、卡间通信方式、CPU型号与内存容量、系统盘与数据盘类型、整机功率与散热方案、机房网络带宽与BGP线路、月租价格与交付周期,填完之后按工作负载的权重排序,多数情况下真正起决定作用的只有三到四列,其他维度只是在同价位时做补充参考。
在广州租用GPU服务器价格之外,还要看服务商的备件储备情况,故障换机快不快、本地有没有技术支持团队,这些决定了机器宕机时你损失多少时间。算力成本是显性的,时间成本是隐性的,隐性成本才是拉开服务商差距的地方。
实际压测是选型对比的最后一关
参数层面确定了两到三台候选机型后,压测结果才是最终拍板的依据,不压测就签合同,相当于把命运交给运气。
本地测性能,云端测延迟
如果在本地机房看机器,带上自己的测试脚本跑30分钟到1小时,重点关注:满载功耗下的散热表现、多卡通信的实际吞吐、数据加载的I/O瓶颈,在云端测试,关注网络延迟和带宽稳定性,广州到华南地区的用户访问延迟通常要求
10毫秒以内,超过这个数体验会明显下滑。
用真实负载替代跑分软件
跑分软件看个乐子就行,真选型要拿自己的模型来试。加载一个跟业务接近的模型,跑一轮推理,测一下首token延迟和生成速度,再模拟几个并发请求看看显存占用和响应时间的变化,这套流程下来,适合你的机型会自动浮出水面,不需要纠结各种营销话术。
广州GPU服务器推荐里靠谱渠道长什么样
在广州租GPU服务器,渠道的靠谱程度排在性能前面,靠谱的服务商通常具备几个特征:机柜在自己的机房或同一园区、支持上门看机、测试期间不收押金或只收低价押金、合同里明确写清楚故障赔偿标准,这些在签合同前多聊两句就能摸清,把时间花在筛选渠道上,比花在看参数上更值。
广州GPU服务器机型对比常见问题
问:广州选GPU服务器,先选卡还是先选机型?
先定卡再定机箱,GPU型号决定了算力和显存上限,机箱和主板决定卡的扩展能力和散热,把卡定下来之后,整机的CPU、内存、存储就围绕卡来做配套,这个顺序反过来很容易出现瓶颈。
问:训练和推理共用一台机器行不行?
可以共用,但要有取舍,训模型时显存占用高,推理时带宽要求高,混跑需要提前预留资源,单机混跑适合轻度使用,重负载场景建议分两台专机,避免训练任务把推理资源的显存和I/O吃满,导致响应延迟上升。
问:广州本地机房和公有云GPU怎么选?
延迟敏感、数据量大的长期负载,选本地机房更稳;弹性需求大、突发峰值明显的,选公有云更灵活,成本维度上,本地机房长期租用有优势,公有云胜在按需付费,没有绝对好坏,只有匹配度高低。
广州GPU服务器的选型最终不是一道算术题,而是一道匹配题。 先把业务负载讲清楚,再用显存、带宽、散热、交付这几个维度去过滤机型,最后通过实际压测来收尾。对比得准的本质,是你知道自己的机器拿来干什么,而不是比谁的参数表更漂亮。 把这层逻辑想透了,广州的GPU服务器市场再复杂,你也拿得住主动权。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/734435.html