想租用广州的GPU算力服务器,核心路径就三步:算清显存需求、对比服务商价格、实操下单部署。 下文把每一步拆开讲,帮你避开那些藏在配置单和计费规则里的坑。
先搞清楚你租GPU到底要解决什么问题
很多人上来就问“租什么卡最便宜”,这是典型的本末倒置,GPU型号只是手段,你的任务类型才决定一切,租错卡的代价,轻则跑不动,重则账单翻倍还得重来。

不同场景对显存和卡型的要求完全不同
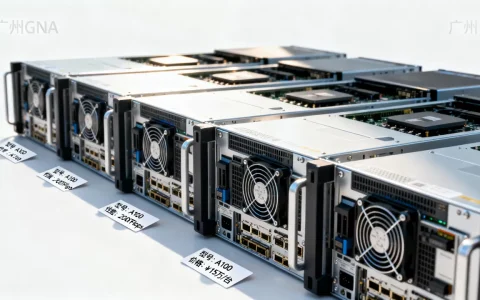
- 大模型微调与推理:这类任务吃显存和带宽,跑7B参数级别的开源模型,主流选择是A100、A800或H800这类80GB显存的卡;如果只是做推理,A10或L20反而更划算。
- Stable Diffusion出图:SD 1.5系列12GB显存就能玩转,SDXL则需要16GB起步,用4090或A6000这类消费级卡就足够,没必要上A100,纯浪费。
- 深度学习模型训练:CV方向目标检测、图像分类,中等规模数据集中等模型,RTX 4090或A6000都能撑住;大规模Transformer预训练才需要多卡A100/H800集群。
- 3D渲染与视频处理:这类任务更看重显卡的渲染核心数量,对显存需求相对可控,V100、A5000都是老牌选项,性价比高。
行业共识认为,显存估算有个粗略公式:模型参数量乘以2到4倍,就是安全下限,比如7B参数模型用FP16精度加载,权重就要占约14GB,加上激活值、梯度、优化器状态,16到24GB才算稳妥。
租用前做一次自检,比看一百篇攻略有用
下面这份清单,租之前花十分钟过一遍:
- 我的任务是一次性跑完,还是需要长期挂着服务?长期运行优先选包月,一次性任务按小时租更划算。
- 代码框架是什么?PyTorch还是TensorFlow,不同框架对驱动和CUDA版本有要求,下单时镜像要选对。
- 训练数据存放在哪里?如果数据在广东本地机房,租广州节点能省下海量数据传输时间。
- 对延迟的容忍度多高?交互式推理服务对网络延迟敏感,机房的网络质量比卡型更重要。
按需筛选服务商:广州GPU算力租用平台有哪些
市面上做GPU租用的角色分三类,各自优劣势明显:
- 头部云厂商:简米云、酷番云的广州区域都有GPU实例,胜在稳定、售后完善,但价格偏高,大客户折扣厚此薄彼,小团队拿到的价格不友好。
- 本地IDC机房:广州本地有不少做托管和算力租赁的机房,胜在沟通效率高、价格灵活,售后响应快,缺点是资源池相对小,热门卡型可能缺货。
- 第三方算力聚合平台:类似AutoDL、环绕算力这类平台,聚合了多家机房的资源,价格透明,可选范围广,需要留意平台的售后完全是代管模式,中间多了一层沟通成本。
广州GPU云服务器价格对比:要看哪些维度才不被坑
单看每小时单价是最容易踩的误区。真实成本要综合五个维度:
- 卡型与显存:同样叫A100,40GB和80GB版本价格差近一倍,下单前在配置页确认显存容量。
- 网络带宽与计费模式:有的服务商看似单价低,但公网带宽按流量额外计费,训练时疯狂下载数据集,月底账单能吓死人,优先选带宽包模式的。
- 存储费用:数据盘是不是赠送?系统盘容量多大?超出部分按GB计费,高频读写还会产生额外IOPS费用。
- 计费周期:按小时、按天、按月三档,连续跑一个月的任务,包月通常只是按小时价格的六到七折,据行业公开信息,部分平台包月价格约为按需价格的60%。
- 关机策略:很多平台关机后不再收GPU费用,但存储和IP费用照收,如果你只是间歇性使用,这点差距极大。
判断服务商靠谱程度的三个实操方法
客服说得好听不算数,自己上手验证才是硬道理。
- 要求提供测试实例,哪怕只有三十分钟,登录后跑一遍nvidia-smi,确认显卡型号和显存与宣传一致。
- 测试实际网络延迟,在你本地终端ping一下机房地址,看延迟是否在合理范围,跨地域的延迟高,训练时同步参数会非常痛苦。
- 看工单响应速度,下单前发一个售前咨询工单,观察回复时间,如果一个售前工单都要等半天,那半夜GPU宕机时你大概能体会什么叫绝望。
广州本地节点与外地节点怎么选
这是一个经常被忽略但影响巨大的决策点。
选广州本地机房的实际优势
- 数据不出省:如果你的业务涉及企业内部数据或政务项目,数据本地化存储是合规刚需,据工信部相关指南,数据跨境和跨区域流转需要额外备案。
- 低延迟访问:团队在广州,代码调试、数据上传、结果下载的延迟都在毫秒级,对比跨省使用,日常操作的体感差距非常大。
- 现场兜底:有些机房允许预约现场巡检,遇到网络故障或硬件异常,运维人员能直接进机房动手排查,远程处理不了的硬件问题当天解决。
什么时候选外地节点反而更划算
- 抢不到稀缺卡型时:A100/H800这类热门卡在广州机房经常满载,外地节点反而有现货,任务紧急时,宁愿忍受稍高的延迟。
- 纯离线批处理任务:如果只是跑数小时的训练脚本或数据清洗,数据一次性上传后就不再依赖本地交互,此时优先考虑价格洼地区域。
- 多地域容灾需求:生产环境需要高可用,主节点和备份节点放不同机房,本身就是常见的容灾架构。
从下单到部署:全流程实操指南
选定服务商后,实操环节的细节决定你后续能少踩多少坑。
下单时注意这几个配置项
- 镜像选择:优先选带CUDA和cuDNN的深度学习镜像,省去手动装驱动的痛苦,实在没有现成镜像,选Ubuntu 20.04以上的干净系统,自己装驱动也快。
- 安全组设置:只要放行必要的端口,SSH端口(22)、Jupyter端口(8888)等,不要图省事全部放行,公网暴露的服务器被扫到就是分分钟的事。
- 密钥对与密码:建议用密钥对登录,比密码安全得多,保存好私钥文件,丢了只能重置实例。
部署环境的标准流程
- SSH登录:
ssh -i 你的密钥.pem root@服务器IP
- 确认GPU状态:
nvidia-smi,看到显卡型号和驱动版本正常即为成功。 - 如果有现成镜像,直接跑一个简单的张量运算验证PyTorch版本正常,比如创建一个随机矩阵做乘法。
验收的三个关键指标
- 显存真实性:
nvidia-smi显示的显存和下单配置一致,没有虚标。 - 实际训练速度:用你的真实模型跑一步训练,记录时间,如果明显慢于预期,可能是驱动版本过低或卡被超售。
- 网络稳定性:连续ping外部地址五分钟,观察丢包率,高于1%就需要和客服交涉。
Q&A:租用广州GPU算力服务器的常见疑问
租GPU服务器比自己买整机划算吗?
如果你每年只有几十小时到几百小时的算力需求,答案毫无疑问是租,一台RTX 4090整机加上周边配套,预算在数万元级别,而这些钱足够你按需租用同等算力数年,只有当你的GPU使用率达到日均十小时以上且长期持续,自购才能真正摊平成本,动手算一笔账就能看到,偶尔用用和重度用户的选择路径完全不同。
想部署DeepSeek这类开源大模型,最少需要多大显存?
按当前主流开源模型的水准,7B参数级别的模型用FP16加载,权重占约14GB显存,加上推理时的KV Cache和中间结果,建议预留24GB以上,对应单张RTX 4090或L20即可流畅运行,如果是更大规模的模型,显存需求会成倍增长,比如13B模型直接需要对标32GB以上的显存配置,显存预算不够时,采用量化方式部署(例如4-bit量化)可以把显存占用压缩到原来的三分之一左右。
按需付费和包月包年怎么权衡?
核心判断标准是你的任务连续性,只是白天做实验、晚上关机,按小时付费更合理;需要训练任务长期挂在后台跑,包月的实际单价比按需低不少,从多数云服务商的定价策略来看,按月付费通常是按小时付费的六折到八折,按年预付还能再谈,唯一需要警惕的是,有些平台包月存在“关机不停计费”的条款,下单前务必把计费规则逐字读清楚。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/734437.html