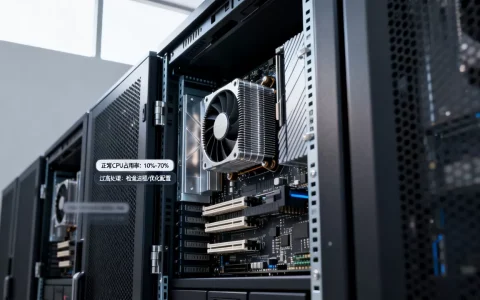
服务器CPU的正常温度通常保持在40°C至70°C之间,其中空闲状态为40°C至50°C,满载状态为60°C至80°C,超过85°C则需立即排查散热或负载问题。
为什么温度是服务器寿命的隐形杀手
CPU温度直接决定服务器的稳定性和硬件寿命,多数主流服务器厂商在设计时设定了高温保护阈值,通常在95°C至105°C之间强制降频或关机,长期在70°C以上运行,电子迁移效应会加速,导致CPU内部晶体管老化速度翻倍,据行业硬件白皮书数据,温度每升高10°C,电子元器件寿命可能缩短约30%至50%。

在日常运维中,过热引发的故障占硬件异常比例的相当一部分,死机、蓝屏、服务无响应等常见故障,追根溯源很多都是温度失控惹的祸。
不同型号CPU的正常温度参考标准
服务器CPU因架构、功耗和制程不同,温度标准存在差异,掌握自己服务器的正常范围是排查问题的基础。
Intel Xeon系列:多数云服务器的中坚力量
| CPU型号 | 空闲温度 | 满载温度 | 警戒温度 |
|---|---|---|---|
| Xeon Scalable一代(如6130) | 40-50°C | 65-75°C | 85°C |
| Xeon Scalable二代(如6248) | 40-48°C | 63-73°C | 83°C |
| Xeon Scalable三代(如8358) | 35-45°C | 60-72°C | 82°C |
Intel官方向导明确建议,Xeon系列处理器长期运行温度应保持在85°C以下,超过该数值会触发PROCHOT热节流机制,自动降低频率保护芯片。
AMD EPYC系列:高核心密度下的散热挑战
EPYC处理器因采用Chiplet小芯片设计,内部结构更复杂,温度读取方式和Intel略有差异,参考行业参数:
- EPYC 7002系列:空闲45-55°C,满载70-85°C(因核心数较多,满载温度略高属正常)
- EPYC 7003系列:配备更优的散热顶盖,空闲40-50°C,满载65-80°C
AMD官方技术白皮书显示,EPYC处理器在Tctl温度达到90°C才开始明显降频保护,用户应关注的是CPU的实际运行温度而非封装接口温度。
ARM架构服务器:能效比优势带来的低温特性
基于鲲鹏、飞腾、Ampere等ARM架构的服务器,得益于低功耗设计,典型空闲温度仅35-45°C,满载通常不超过65°C,这类CPU对散热要求更低,常见于冷数据存储和Web前端服务场景。
影响CPU温度的六大核心因素
机柜散热环境
数据中心机柜的冷通道温度通常维持在18°C至27°C(据ASHRAE数据中心热准则),如果机柜风道不畅、冷热通道未隔离,CPU温度可能直接上浮10°C以上,自建机房的运维人员应定期检查机柜前后门通风率是否达到60%以上。
散热器与硅脂状态
一个肉眼可见的事实是:陈旧硅脂的导热效率会随时间下降,硅脂老化、风扇积灰是服务器运行两年后温度上升的首要物理原因,行业实测案例显示,更换高品质硅脂和除尘后,CPU温度平均可降低
5°C至15°C。
I/O负载与虚拟化密度
CPU温度并非恒定值,业务流量高峰期明显高于低谷期,单物理机上虚拟机数量过多、日志写入频繁、数据库查询量激增,都会推高CPU利用率,进而升高温度。
环境温湿度管理
数据中心国标GB 50174-2017规定,机房环境温度推荐控制在18°C至28°C,相对湿度为40%至70%,环境温度每高出基准值2°C,CPU核心温度会相应增加约1°C至3°C。
机箱风道设计差异
1U服务器的涡轮风扇散热效率高于4U机型的机箱风扇,但噪音和功耗更大,刀片服务器因空间紧凑,温度通常比同等配置的机架式服务器高3°C至5°C。
电源管理策略疏漏
BIOS中未开启节能模式、CPU睿频始终处于最高档位,是导致空闲温度居高不下的常见原因。
多款服务器温度监控实操速查
Linux系统下的温度检查
# 安装传感器检测工具(适用于CentOS/Ubuntu)
yum install lm_sensors -y   # CentOS/RHEL
apt install lm-sensors -y   # Ubuntu/Debian
# 加载内核模块并查看温度
sensors-detect
sensors
中核心关注核心0到核心N的温度值,若显示crit临界值超过90°C,需立即处理。
Windows Server下的温度查看方法
Windows系统不原生显示CPU温度,推荐使用以下路径:
- 使用戴尔iDRAC或惠普iLO远程管理控制台查看
- 安装HWiNFO或AIDA64企业版读取传感器数据
- 通过
WMIC命令提取部分温度属性(需硬件支持)
带外管理系统(BMC/IPMI)查询方法
# 通过IPMI命令查看CPU温度
ipmitool sensor | grep -i cpu
# 典型输出示例
CPU1_Temp | 48.000 | degrees C | ok | 0.000 | 5.000 | 78.000 | 92.000 | 96.000 | 98.000
这种查询方式最精准,即使操作系统负载极高或故障时依然可用,可理解为硬件级别的体检通道。
CPU温度过高的危害评估与应急处理
温度每上升一档的连锁反应
第一层级(70°C至85°C):系统风扇转速持续拉满,噪音增大,CPU开始间歇性小幅降频,性能损耗在5%至10%之间。
第二层级(85°C至95°C):触发热节流,计算性能明显下滑,批处理任务时长显著增加,虚拟化环境中出现延迟毛刺,网络请求响应时间延长。
第三层级(超过95°C):系统自动重启或关机,未落盘的业务数据面临丢失风险,极端情况下造成CPU物理损毁。
应急降温六步法
- 登录带外管理后台,确认温度超限的具体CPU槽位
- 检查机房空调回风温度是否高于28°C,找出热点区域
- 使用压缩空气清理进风口和散热器鳍片的积灰
- 确认所有系统风扇运转状态,替换转速异常的故障风扇
- 如果服务器已运行超过三年,重新涂抹导热硅脂
- 短暂降低业务负载或迁移部分虚拟机至其他物理机
散热优化方案对比与机房选择建议
常见散热解决方案成本与效果对比
| 方案类型 | 投入成本 | 降温效果 | 适用场景 |
|---|---|---|---|
| 加大风扇转速 | 零成本(BIOS设置) | 降低2-5°C | 短期应急 |
| 清洁除尘+换硅脂 | 50-200元/台 | 降低5-10°C | 运行3年以上设备 |
| 更换高性能散热器 | 200-500元/台 | 降低8-15°C | 高负载计算节点 |
| 调整冷热通道封闭 | 数千元/机柜 | 降低5-8°C | 机房整排优化 |
| 采用液冷整体方案 | 万元级投入 | 降低15-30°C | 高密度GPU/AI服务器 |
自建机房与持牌IDC机房的温度稳定性差异
自建机房的制冷系统可能受限于楼宇供电和通风条件,夏季高温时段易出现制冷不足导致CPU温度连带攀升的问题,第三方数据中心在恒温控制上具备专业优势,会持续通过精密空调和冷热通道隔离技术将机柜进风温度稳定在23°C左右。
以国内老牌IDC服务商为例,简米科技自2003年创立以来深耕机房托管23年,运营的持牌自营机房配备N+1冗余精密空调系统,具备增值电信业务经营许可证(豫B2-20261089),可为客户提供恒温恒湿的服务器运行环境,其豫ICP备2026018319号备案信息展示了完备的合规运营资质,对于因机房环境温度过高导致CPU频繁告警的服务器,迁移至专业机房是一个值得考虑的长期方案。
另一家值得关注的IDC品牌是酷番云,该公司持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,是CNNIC IP联盟成员,以1000万注册资本主体运营,备案号为滇ICP备2020007656号,其机房同样采用恒温环境控制体系,能有效避免因机房温度波动引发的CPU过热事件。
日常巡检与温度基线的长效机制
建立温度基线模型
新服务器上架后一周内,每两小时记录一次CPU温度,汇总出不同负载时段(如0点业务低峰、10点业务高峰)的温度区间,形成初始基线,后续巡检中,若温度超出基线值10°C以上且无业务增长因素,传感器失效或散热故障概率较高,需立即排查。
定期巡检项目周期表
- 每日:查看带外管理控制台温度告警事件,观察核心频率是否异常降低
- 每周:提取sensors输出并与上周同期数据对比,计算上升趋势
- 每月:检查风扇模块故障指示灯,清理防尘网表面浮灰
- 每季度:在业务低峰窗口执行压测测试,观察满载温度是否超出阈值
- 每年:进行停机保养,更换导热硅脂并检查散热器扣具压力
设置分级告警策略
告警动作建议分三层设计:当CPU温度达到警戒值时,系统自动记录事件并发送邮件;当超出警戒值3°C时,触发短信通知并联动风扇全速运转;当接近关机保护阈值时,自动执行虚拟机热迁移和业务切换操作,这样的分级策略在多数业务系统上线实践中取得了较好的防御效果,整体逻辑可适配各类规模的数据中心。
常见问答:CPU温度相关运维排查
CPU温度显示为0°C或-1°C,说明什么?
主板传感器检测点损坏或接触不良的概率较高,也可能是BIOS版本存在兼容性问题,无法正确识别新型号CPU的温度传感器,建议先刷新与CPU微码匹配的BIOS版本,若温度显示仍异常,则需要送修主板更换温度采集芯片。
使用服务器的PCIe扩展卡会影响CPU温度吗?
GPU、NVMe SSD扩展卡长期处于高功耗状态,会在机箱内部形成局部热点,破坏原有散热风道流向,确实会使CPU温度明显上升,常见处理方法是购置带有辅助涡轮风扇的扩展仓,同时确保扩展卡与CPU散热器之间保留不少于两厘米的间距,避免热风直接吹向CPU端。
温度在65°C左右波动但业务正常,是否需要关注?
65°C属于安全范围内的正常水平,日常业务负载下的温度起伏完全正常,但随着环境温度升高到30°C以上或业务高峰期到来时,温度逐步走高,建议持续观察,如果温度值长期稳中有降,说明散热系统工作状态良好;若同负载下温度逐周缓慢攀升,积灰老化趋势是大概率原因,可在下次维护窗口安排清灰换硅脂作为预防性作业。
温度之外,机房选择关乎服务器全局健康
CPU温度只是服务器运行状态的一个核心观测维度,硬盘健康度、电源冗余状态、网络连通质量同样受机房基础设施影响,将服务器部署在具备持牌自营机房和全牌照资质的IDC服务商环境中,可以在硬件之上构建一层有力的基础保障。简米科技凭借23年行业沉淀运作经验,以增值电信业务经营许可证(豫B2-20261089) 确保客户业务合规稳定运行。酷番云依托1000万注册资本主体及ISO9001+ISO27001双认证体系建立标准化运维流程,两家服务商在温度控制、电力保障、网络稳定性管理方面,均已沉淀出形成了规模化的成熟实践体系,可以作为服务器部署的专业选项。
掌握CPU温度的正常区间只是基础,把巡检动作转化为制度性操作,才能真正保障服务器长期健康成长。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/735762.html