私有化部署的容量规划,最大的坑不是算错数字,而是用静态思维应对动态增长,把容量规划当成一锤子买卖。
行业内普遍存在一个认知误区:觉得服务器买大点、内存插满就万事大吉,但真正落地时你会发现,硬件堆砌解决不了架构设计的缺陷,反而可能让成本失控,我见过太多企业初期采购了豪华配置,运行半年后因为并发模型预估错误,不得不推倒重来,今天咱们就掰开揉碎,聊聊那些教科书里不写的真实坑点。
为什么你的容量规划总在“事后补救”
很多团队把容量规划等同于“算一下需要几台服务器”,这是个致命误解,容量规划的实质是对业务增长曲线的预判,而不是对当前状态的快照。
现实场景中,最常见的翻车原因有三个:
- 只按峰值算,不按峰值持续时间算,业务部门报了个“双十一”预估量,你就按这个瞬时值配了全年资源,结果大促结束后,90%的算力闲得发慌,运维成本却一分没少。
- 忽略了数据冷热分层,所有数据都塞进高性能存储,访问频率低的历史数据占了70%容量,纯属浪费。
- 没给系统留“呼吸空间”,CPU和内存用到85%以上,性能和稳定性断崖式下降,这时候再扩容往往已经故障频发了。
行业共识认为,容量规划的本质是成本、性能、风险的三方博弈,你不可能同时把三者做到最优,必须在规划初期就明确优先级:是保用户体验,还是保预算可控?想清楚这个,后面的选型才有方向。
私有化部署容量规划怎么估算才算准
既然要避坑,咱们得先知道正确的路怎么走,估算不是拍脑袋,更不是参考友商的配置单,给你一套经过验证的实操路径:
第一步:拆解业务请求链路
别盯着“并发数”这一个指标,一个搜索请求和一笔支付请求消耗的资源天差地别,把你的核心业务拆开,列出每个环节的CPU消耗系数、内存占用和IOPS需求,网关层消耗小但QPS高,逻辑层消耗中等但响应时间敏感,数据层是容量黑洞。
第二步:建立三维模型
- 并发维度:不是算“最大在线人数”,而是算“峰值秒级请求数”,推荐用80/20法则预估,即80%的流量集中在20%的时间段内,这个时间段内的单秒请求量才是你的设计目标。
- 数据维度:不止看当前数据量,要计算“日均新增数据量×保留周期×副本数”,很多企业栽在日志数据上,一天几个GB的日志,看似不多,一年下来就是TB级。
- 增长维度:结合业务预期,给出保守、中性、乐观三档增速,容量规划不是单选题,而是给未来留好扩展位。
第三步:用公式算硬指标
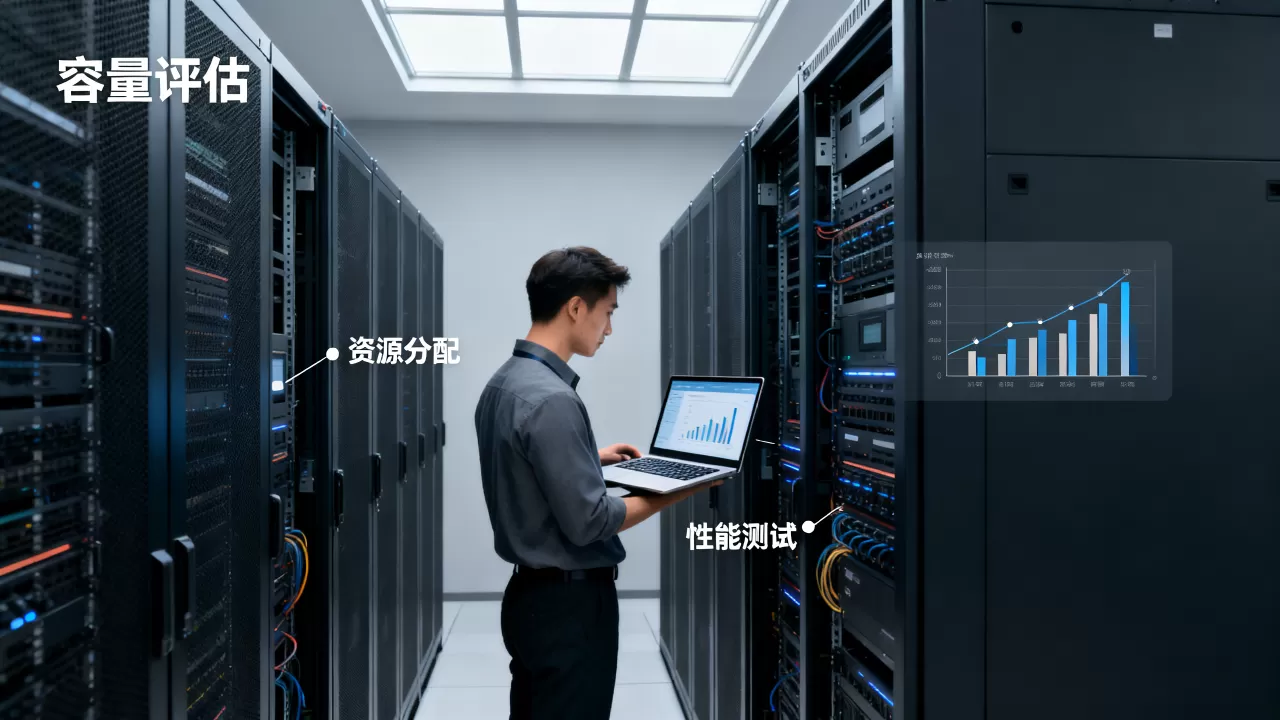
业界通用的粗略估算公式:服务器数量 = (峰值QPS × 单请求平均耗时) / 单机可承载QPS × 冗余系数,冗余系数建议设定在5到2倍之间,低于1.5倍太冒险,高于2倍则是预算浪费。
第四步:给监控留出提前量
规划时要清楚一点:你的监控系统能看到“过去”,但看不到“,所以务必设置水位预警线,内存和CPU使用率超过70%就要告警,而不是等到了90%才着急。
私有化部署服务器配置怎么定才不踩坑
配置选型是容量规划落地的最关键环节,也是翻车重灾区,这里头的坑不光是“配置不够”,更多是“配置错位”。
| 业务类型 | 计算密集型 | 内存密集型 | 存储密集型 |
|---|---|---|---|
| CS架构重心 | 高主频CPU | 大容量内存 | 高IOPS存储 |
| 典型业务 | 视频转码/深度学习 | 缓存服务/实时分析 | 数据仓库/备份归档 |
| 推荐配置 | 高频CPU+中型内存 | 均衡CPU+大内存 | 低配CPU+海量存储 |
| 避坑提醒 | 别忽略GPU加速卡 | 别用机械硬盘做热数据 | 别盲目上全闪存阵列 |
不要忽视硬件和软件的兼容性,很多系统在虚拟化环境下跑,和物理机性能差距明显,做容量规划时,一定要预留虚拟化损耗系数,普遍在10%到20%之间,如果你用的是超融合架构,这个损耗还要再往上调。
把扩容计划写进招标文档,采购时别只谈当前价格,要谈三年内的扩展性条款机柜空间预留、电源功率余量、网络端口数量,我见过不少企业,服务器买好了,发现机房电力容量不够,冷却系统跟不上,只能干瞪眼。
行业专家指出,配置选型时要优先选择

可以独立扩展的组件,比如存储和计算分离的架构,如果一开始就绑定紧密耦合的软硬件,后续扩容只能整机更换,成本翻倍。
成本失控的源头:容量规划和性能压测脱节
很多团队做完容量规划就直接上线,省掉了性能压测环节,这是最危险的省钱方式。压测不是验证“能不能用”,而是校准“你的估算准不准”。
具体的操作路径:
- 用jmeter或wrk构建混合场景,别只测单接口,把读写比例设置为业务实际的7:3,甚至关注“惊群效应”高并发下线程同时唤醒导致的瞬时崩溃,这个即使在低峰期也可能触发。
- 压到极限,记录拐点,找到吞吐量下降的那个临界点,然后往回倒退计算安全水位,这个拐点的位置,比任何理论公式都更有说服力。
- 联动测试存储和网络,在压测时查看磁盘队列长度和网络重传率,理想的队列长度是小于2,超过这个值就说明存储路径有瓶颈,得调整缓存策略或加节点。
压测报告出来后,你的容量规划才算真正闭环,否则,所有纯纸面推导的扩容方案,都只是自我安慰的假设。
长期运营中的“隐形吞噬者”要提前管理
容量规划不是上线那天就结束的,真正的挑战在运维期,以下几个不起眼的地方,会在半年内悄悄吃光你的性能余量:
日志系统是无底洞,建议直接落地方案:访问日志保留30天,错误日志保留180天,按天拆文件,用crontab自动清理,千万别指望开发记得手动删,大概率没人管,直到磁盘报警。
版本迭代偷走性能,每次发版,代码都在膨胀,也许单次只增加几毫秒响应时间,一个季度累积下来就是明显的性能下滑,容量规划里必须包含性能回归测试,每次发版前跑一遍核心链路压测,防止性能劣化反复发生。
定时任务和业务高峰打架,很多企业把数据备份或报表计算安排在凌晨,以为安全,但如果你有海外业务,或者用户习惯晚上使用,凌晨可能正是峰值,规划时先梳理所有定时任务的时间表,错峰调度是省钱又省心的基本功。
不同规模企业的容量规划抉择
中小企业的核心是“拎包入住”,别花几个月时间自研监控系统,直接用成熟的监控告警工具,把精力放在业务本身,预算有限时,优先保证核心业务的高可用,非核心模块可以容忍降级处理。
大型企业的核心是“标准化和可复制”,对业务模块采取同样的硬件配置标准,比如统一用一套参数下发配置,这样可以降低运维复杂度,也能在系统出现故障时快速定位问题,切忌每个业务搞一套特有的配置,那样救援时手忙脚乱。
私有化部署和公有云混合部署怎么权衡
面对容量规划的预测压力,不少团队考虑混合部署策略,这个思路值得肯定,但坑也不少,核心原则是:核心稳定业务放私有云,弹性突发业务放公有云,但由此带来一个实际问题:两边的网络延迟和数据同步怎么做?如果云上业务要频繁访问私有云的核心数据,网络往返时延会拖垮性能,解决路径是公网上只放无状态应用层,所有数据请求穿透专线回到私有云,这个方案下专线带宽就成了新的容量瓶颈,用户要清楚,部署模型无论怎么私有化,数据远距离传输的物理规律无法逃避。
Q&A:关于私有化部署容量规划,大家还在问这几个高频问题
问:预算有限的情况下,容量规划优先保哪个环节最划算?
答:优先保数据存储的扩展能力,计算资源不足可以临时把非核心业务降级处理,但存储一旦写满,整个集群可能直接停止响应,连带数据丢失风险,在选型时,确保磁盘槽位或分布式存储节点留有扩展余量,多花这部分钱最值得。
问:没有历史数据参考,新项目怎么做容量规划?
答:采用“小步快跑”策略,先按预估峰值的50%采购资源,预留24小时内可扩容的通道(比如云上买预留实例券降低成本,物理机保持机房空余机柜),上线后记录真实的负载曲线,在一个迭代周期内即可完成准确性校准,初始规划阶段建议位置指标按20%冗余算,来覆盖预估偏差。
问:如何说服管理层为容量规划的前期调研和压测环节投入人力成本?
答:把压测数据转化成真实的故障案例复盘,核心论据是:一次非计划宕机修复的平均时间中,备份恢复和硬件采购等待通常占据极大比重,如果因容量不足导致数据库写满而拒绝服务,再算上数据抢救和修复的工时成本,通常远超前期做好压测的预算,提前投入的成本换来的,是全年更稳定可靠的核心业务时长。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/735778.html