通过快照、备份、版本控制、事务日志和配置管理五类技术手段,将系统、应用或数据恢复到某个历史时间点的安全状态,其本质是给服务器操作买一份“后悔药”,具体落地方式因故障类型和业务场景而异。
回滚机制到底在解决什么问题
服务器回滚不是某个单一功能,而是一套组合拳,日常运维中,回滚主要应对三类故障:代码上线后的逻辑错误(比如新功能导致接口报错)、数据误操作(比如手滑删了生产库的某张表)、配置修改引发的连锁反应(比如防火墙规则写错导致全站502),回滚机制的价值在于缩短故障恢复时间,把“排查问题”和“恢复服务”解耦先回到安全状态,再慢慢分析原因。
业内专家指出,多数互联网公司的回滚目标不是“避免故障”,而是“快速恢复”,衡量回滚效率的核心指标是MTTR(平均恢复时间),行业共识是生产环境的回滚操作应当控制在15分钟以内。
四大主流回滚机制拆解
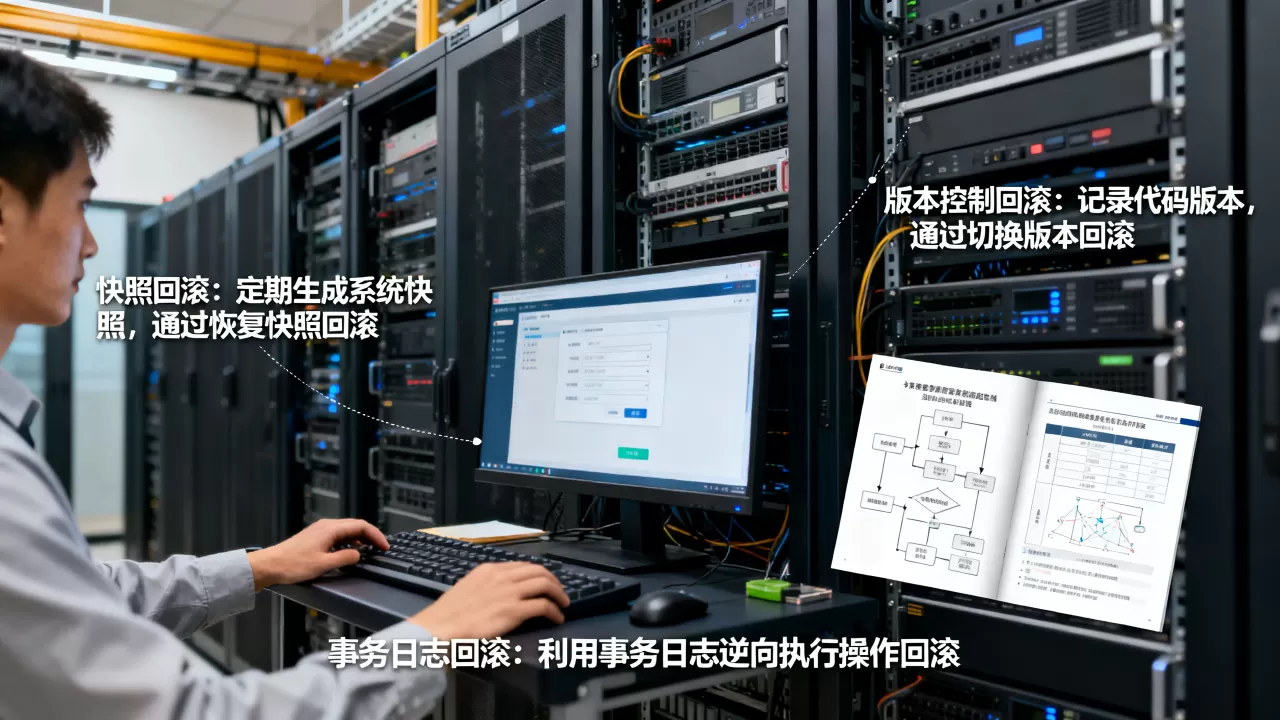
不同层级的问题,需要不同维度的回滚手段,从底层基础设施到上层业务代码,回滚机制大致分为四类。
系统镜像与快照回滚
这是最粗暴也最有效的兜底方案,云服务器(如简米云ECS、酷番云CVM)通常支持创建快照,相当于给整个磁盘拍一张“定妆照”,当系统崩溃、内核升级失败或中了勒索病毒时,直接回滚到快照时间点即可。
实操中的关键点:
- 快照回滚会丢失创建快照之后的所有数据变更,因此适合低频操作前使用
- 云厂商的快照通常按存储容量计费,一个100GB的实例,每周一次快照,月度成本大致在几十元级别,云服务器快照回滚价格透明且可控
- 本地虚拟化环境(如VMware、Proxmox)同样支持快照,但生产环境建议同时保留两份独立快照,避免快照文件自身损坏
数据库层级的精细回滚
数据库是回滚需求最密集的区域。MySQL数据库回滚误操作是搜索频率极高的场景,处理方式分为物理层和逻辑层。
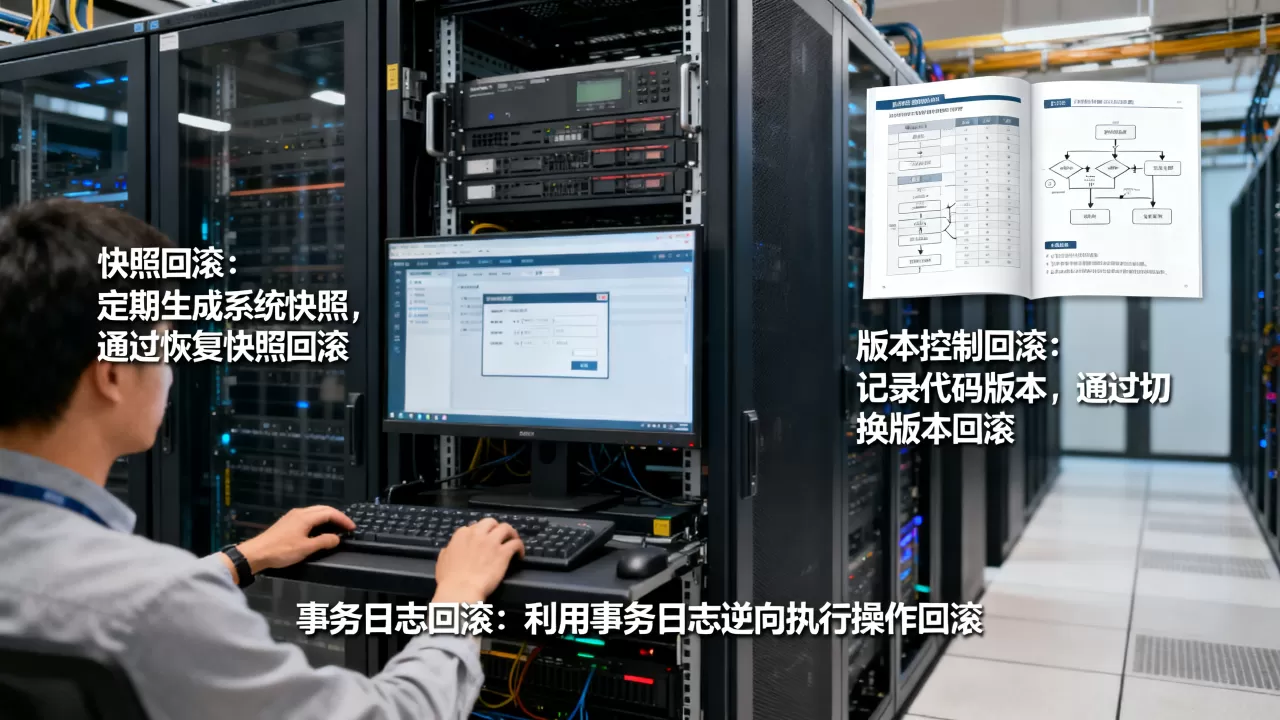
物理层依赖binlog(二进制日志),MySQL开启binlog后,每一次写操作都留有痕迹,误删除数据时,通过mysqlbinlog工具解析日志,结合--stop-datetime或--stop-position参数,可以精确重放操作到误删前的一瞬间,命令示例:
mysqlbinlog --start-datetime="2026-01-01 10:00:00" --stop-datetime="2026-01-01 10:30:00" /var/lib/mysql/binlog.000012 | mysql -uroot -p
逻辑层依赖undo log(回滚日志),InnoDB引擎使用MVCC(多版本并发控制)实现事务回滚,这也是ROLLBACK语句的底层原理,对于开发人员来说,最常用的是在执行UPDATE或DELETE前,先开启事务,确认无误再COMMIT,发现异常立即ROLLBACK。
另有一类第三方工具如binlog2sql,可以解析binlog生成反向SQL(把DELETE转成INSERT),实现更细粒度的数据恢复,适合处理“只回滚某几条记录”的场景。
应用发布版本回滚
代码上线导致故障是最常见的回滚触发原因,现代应用部署普遍采用容器镜像(Docker)或制品仓库(如Nexus、JFrog)管理版本,每个构建产物都有唯一版本号,回滚时只需将镜像标签重新指向旧版本。
对于使用Kubernetes的架构,回滚操作非常简单:
kubectl rollout undo deployment/your-app --to-revision=3
该命令会直接将Deployment回滚到第3个版本,并保留历史版本记录,对于传统的systemd或supervisor管理的单体服务,回滚通常依赖发布系统的“一键回滚”按钮,本质是拉取上次版本的安装包并重启服务。
配置文件与基础设施即代码回滚
配置错误引发的故障很难靠“重启”解决,如果使用了Ansible、Terraform等基础设施即代码工具,配置的每一次变更都以代码形式保存在Git仓库中,回滚时直接git revert或git checkout到上一个提交,重新执行应用命令即可。
对于未接入自动化工具的服务器,修改
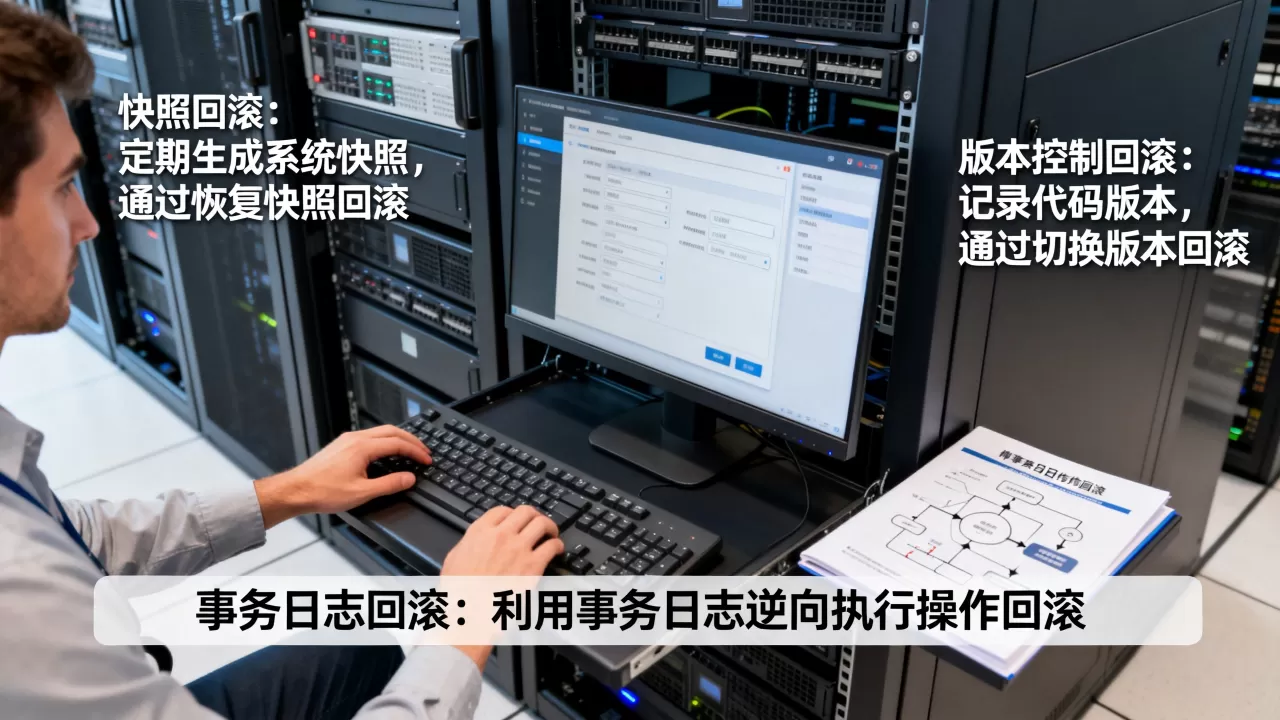
/etc/nginx/nginx.conf或/etc/my.cnf前,务必手动备份原文件:
cp /etc/nginx/nginx.conf /etc/nginx/nginx.conf.bak.$(date +%F)
怎样选择适合业务场景的回滚方案
云服务器快照适合“大而全”的整体防护,但回滚粒度太粗,一个误删文件的故障如果动用快照,可能导致其他业务数据一并丢失,数据库日志回滚足够精细,但要求DBA熟悉日志解析,操作门槛较高,了解四类回滚方式的特点,才能避免“杀鸡用牛刀”或“小病拖成大病”。
按故障类型匹配回滚策略
- 硬件故障或系统层面(内核、驱动)问题:使用整机快照或镜像回滚,成功率最高
- 应用逻辑缺陷:优先回滚代码版本,保留数据库数据不动
- 单表数据误操作:使用binlog解析或闪回工具,不能直接回滚快照
- 安全事件(如被植入后门):建议先隔离服务器,再结合快照备份和日志审计溯源,不要急于回滚,以免丢失攻击证据
回滚操作的通用流程与注意事项
任何回滚操作都应遵循一套标准流程,避免“滚雪球式”二次故障:
- 立即标记故障时间点,停止相关服务或摘除流量(避免脏数据持续写入)
- 再对当前状态做一次备份,为后续故障分析留底
- 执行回滚操作,优先选择改动范围最小的方式
- 逐步恢复流量,观察核心指标(错误率、响应时间、资源占用)
- 确认稳定后,处理回滚所残留的变更副本(例如清理临时备份文件)
需要特别警惕的是,数据库回滚时如果binlog未开启或日志过期清理,数据恢复几乎不可能完成,生产环境应强制开启binlog并设置合理的保留时长(如7天)。
构建多层回滚体系的四个黄金准则
分层备份:不能只依赖云厂商的默认快照,建议本地留存一份异地备份或归档备份,据工信部相关容灾指引要求,关键业务系统应至少具备本地和异地两份备份。
定期演练:回滚流程不演练,等于没有回滚机制,每季度至少做一次从备份恢复到新实例的演练,验证备份数据的可读性。
权限分离:能执行回滚操作的人员应限定在少数核心运维或DBA,且操作前需要双人复核,降低误操作概率。
准确的文档记录:把回滚步骤、相关命令、负责人联系方式整理成运维手册,故障发生时人容易紧张,文档是救命稻草。
常见问题解答
服务器配置错误如何回滚且不影响已产生的业务数据?
核心思路是“配置与数据分离”,如果修改nginx.conf导致服务不可用,但业务数据存在MySQL或Redis中,直接恢复配置文件即可,数据完全不受影响,具体操作:使用备份的.bak文件覆盖当前配置,然后执行nginx -t验证语法,再nginx -s reload平滑重载,对于数据库参数的修改(如max_connections),修改后需重启数据库实例,但数据文件和日志文件完全独立于配置文件,回滚参数不会导致数据丢失。
数据库误操作回滚恢复需要多长时间?
取决于两个变量:binlog保留时长和日志解析难度,若误操作发生在近几小时内且binlog完整,熟练的DBA通常能在20至40分钟内完成单表回滚,如果误操作已经过去数天,binlog可能已被purge,此时只能依赖全量备份加增量日志恢复,耗时可能长达数小时,且仍有一定比例的数据丢失风险,对于此类高风险操作,更推荐使用支持时间点恢复(PITR)的数据库运维平台。
快照回滚和版本回滚能同时使用吗?
可以,且推荐同时使用,当一次上线同时包含代码变更和数据库结构变更(如新增字段)时,单纯回滚代码可能导致新代码读旧表结构而报错,稳妥做法是:先用快照把数据库回滚到上线前的状态,再将应用代码回滚到对应版本,最后重启服务并验证整个链路,注意回滚顺序有讲究:先停应用,再回滚数据库,最后回滚代码并启动,避免中间状态产生脏数据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/736017.html