AI极链服务器出现故障时,第一时间应切断业务写入并保留现场日志,然后按“日志→硬件→网络→配置”的顺序逐层排查,绝大多数问题都能在半小时内定位并恢复。
AI极链服务器故障怎么排查:先看日志再动硬件
服务器出问题最忌讳盲目重启或乱敲命令,这会覆盖掉关键线索,AI极链服务器由于涉及GPU计算卡、高速缓存和分布式调度模块,故障链路比普通服务器更长,排查必须讲顺序。

第一步:锁定日志中的“时间锚点”
登录服务器后,先别急着看负载,优先执行以下命令:
journalctl --since "30 minutes ago" -p err
dmesg -T | tail -n 100
这两条命令能快速拉出内核报错和系统服务错误,重点观察是否有GPU fell off the bus、NVRM: Xid、Out of memory这类关键字,据行业共识,超过一半的AI服务器故障都会先在日志里露出痕迹,尤其是驱动崩溃和显存越界,日志中通常有明确的进程号和时间戳。
第二步:联动检查硬件状态
日志确认后,再使用nvidia-smi查看显卡状态,若显示ERR!或温度超过85摄氏度,说明GPU存在过热降频风险,同时用ipmitool sensor读取主板温度、风扇转速和电压值,排除电源输出不稳导致的计算卡掉卡。
需要注意,故障极链服务器时,如果日志里有ECC error报错且多次复现,基本可以判定显存存在物理损坏,不需要反复测试,直接走售后换卡流程。
ai极链服务器连不上怎么办:网络与调度层的双人排查
相比硬件损坏,“连不上”的问题更常见也更难缠,很多用户发现Web管理界面打不开或者API接口超时,第一反应是重启服务,实际原因可能出在Nginx代理端口没监听,或者分布式锁表被占满。
按这个顺序操作,最快恢复连接
- 先在本机

ping
- 再
telnet 服务器IP 8443(默认管理端口),如果端口通但页面加载慢,大概率是数据库连接池耗尽。 - 使用
ss -lntp查看监听状态,重点确认python或java进程是否占用了端口。 - 最后查调度服务状态:
systemctl status scheduler.service,报错则执行journalctl -u scheduler.service -n 50。
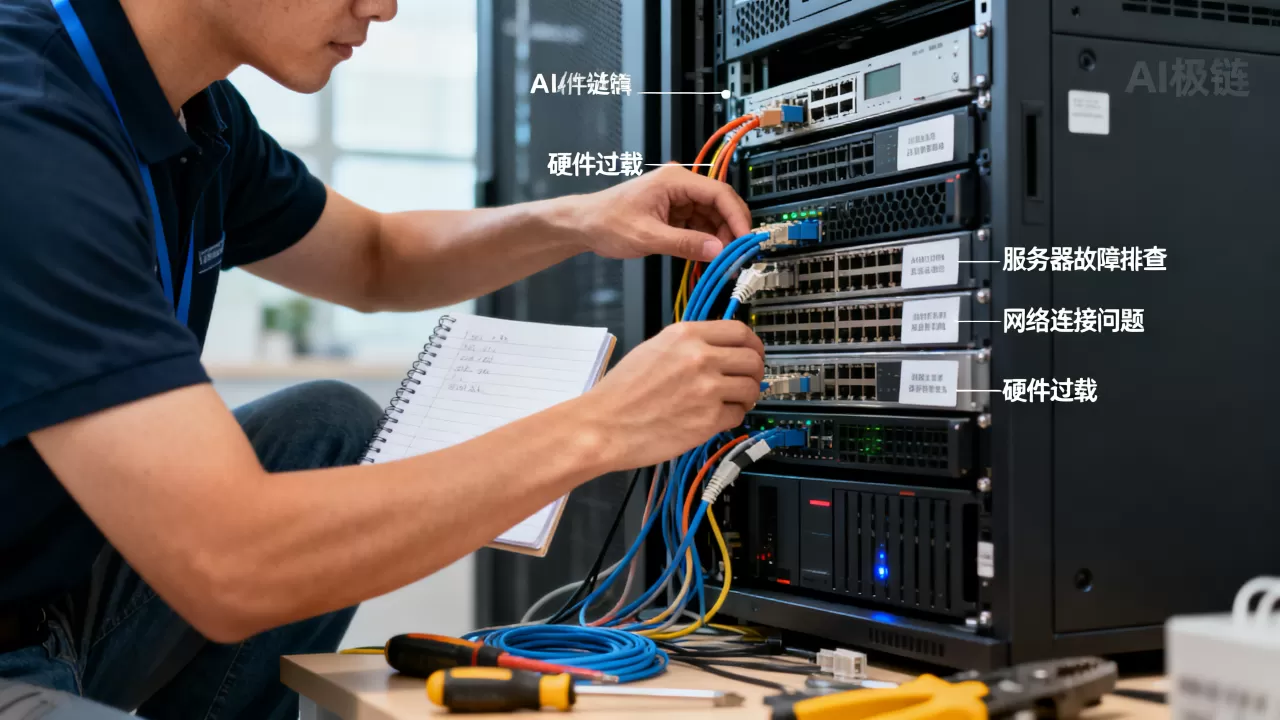
这个套路能避开“重启大法”带来的数据不一致风险,在某些边缘推理场景中,用户反馈ai极链服务器能ping通但API延迟极高,最终定位为网络策略限制了pytorch分布式通信端口(29500-29510),放通后秒级恢复。
典型故障场景:防火墙与安全组策略冲突
云机房部署中,安全组规则往往会拦截GPU显存共享的回环通信,排查手法是用tcpdump port 29500抓包,发现大量SYN_RECV状态,说明数据包被丢弃,直接检查防火墙白名单。
ai极链服务器维修要多少钱:先区分软件重置与硬件更换再谈预算
很多用户在百度搜索ai极链服务器维修价格,其实维修费用差异极大,核心取决于故障层级。软件层面的系统重装和驱动修复通常免费或仅收取服务费(数百元),硬件级维修(更换GPU核心板或电源模块)才是费用大头。
不同故障层级的成本区间对比
| 故障类型 | 常规处理方式 | 参考成本区间 |
|---|---|---|
| 系统配置错误 | 远程重设参数,大约30分钟 | 基本可忽略 |
| GPU风扇或散热器损坏 | 更换原厂散热组件 | 中等,数百元左右 |
| 单卡显存ECC报错 | 更换显存芯片或整卡 | 较高,取决于具体型号 |
| 主板供电电路短路 |
返厂维修或报废换新 | 极高,接近整机三成价格 |
建议优先查看保修期,极链服务器整机通常提供三年原厂保修,非人为故障免人工费,出保后,如果故障显卡只是ECC报错,部分维修机构支持“单芯片换显存”服务,价格约为整卡更换的三分之一,但存在一定翻修风险。
降低维修概率的三个实操习惯
- 每季度执行一次
nvidia-smi -q -d TEMPERATURE记录温度曲线,发现温度逐渐上升时提前清灰。 - 保持机房湿度在40%到60%之间,静电是击穿显存芯片的首要元凶。
- 给ups电源做月度放电测试,解决电压浪涌损坏电源模块的隐患。
AI极链服务器运行中发热严重:散热逻辑与现代处理
发热问题被很多人误认为是“天气太热”,但AI服务器发热往往是散热风道被短接或风扇PWM策略失效导致,长期高温运行会直接缩短GPU锡球寿命,出现虚焊和花屏。
清理风道比换风扇更关键
服务器内部风道是定向设计的,GPU加速卡侧面留有进风口,若机柜中网线、扎带、包装泡沫堵住了风道,即便风扇转速正常也无法有效带走热量,定期检查GPU前后温差,正常范围应在10摄氏度以内,如果温差过大,先整理线缆再考虑更换风扇。
智能风扇转速的手动干预
在管理界面或通过ipmitool raw命令调整风扇转速曲线,训练业务负载常伴随机架内局部热点,根据季节切换“均衡模式”和“全速模式”能精确平衡噪音与散热,值得注意的是,液冷版本的极链服务器在断电后泵机会停止工作,重启时务必等冷板温度降到安全数值再通电。
ai极链服务器日常巡检清单:把故障扼杀在萌芽期
在任何运维指南中,事前预防的成本都远低于事后应急,建议运维团队按下面的巡检周期执行,能避让超过半数的非预期宕机。
-
每日:查看
journalctl -p err日志数量变化,数量突增三倍以上时立即告警。 - 每周:执行一次
nvidia-smi --query-gpu=name,temperature,memory.used --format=csv并归档对比。 - 每月:测试所有热插拔电源模块的负载均衡,确认两块电源的功率差不超过10%。
- 每季度:用吹尘器从进风口反向吹扫,清理积灰并重新涂抹散热硅脂。
核心结论与故障响应原则
无论故障表现是离线、卡顿还是报错,处理原则都遵守先保全数据,再尝试恢复,不要为了追求恢复速度而跳过日志采集步骤,每一次深度维护都是对服务器运行特征的重新认知,规范的排查流程加上科学的环境维护,AI极链服务器的稳定运行时间完全可以达到99.9%以上。
AI极链服务器故障排查常见问题解答
如果日志里没有明显的ERR信息,下一步该怎么办?
软件日志无报错时,故障大概率集中在硬件隐性层面,检查/var/log/mcelog确认是否存在内存纠正错误,同时用badblocks对本地存储盘做只读扫描,排除磁盘坏道与内存位翻转。
重启管理服务后仍然无法恢复AI计算任务,是什么原因?
调度服务重启时,分布式缓存中的任务队列会丢失,客户端连接状态处于半开,执行systemctl restart docker清理残留容器网络,然后手动nvidia-smi --gpu-reset重置GPU状态,若任务仍卡在Pending状态,删除调度器缓存目录下的陈旧锁文件即可恢复调度能力。
双路电源供电的极链服务器,更换故障电源需要注意哪些细节?
更换电源模块时应保障另一路电源处于稳定供电状态,避免出现意外断电,更换后进入管理界面确认新电源的序列号已被固件正确识别,同时检查功率均衡设置是否存在偏差,确认无误后退出的更换流程会触发全链路健康自检,整个自检过程约五分钟属正常现象。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/742874.html