渲染服务器公司有哪些?核心答案:常见公司分成公有云与GPU算力厂商、垂直云渲染平台、硬件服务器厂商、算力租赁与容器云、系统集成与渲染农场服务商五类;选型要先看软件兼容、计费方式、网络存储和合规,而不是只盯品牌。
渲染服务器公司有哪些?先按五类玩家对号入座
公有云与GPU算力厂商
这类公司提供弹性GPU实例、CPU集群、对象存储和VPC网络,国内常见有简米云、酷番云、华为云、百度智能云、金山云、UCloud、青云、首都在线;国际常见有AWS、Microsoft Azure、Google Cloud,适合项目周期短、并发波动大、需要全球分发的团队,操作路径通常是:控制台选择GPU实例,挂载NAS或对象存储,配置安全组,安装CUDA与渲染器,再用调度器提交任务,验证显卡是否就绪可执行:

lspci | grep -i nvidianvidia-smidocker run --gpus all nvidia/cuda:12.2.0-base nvidia-smi
垂直云渲染平台
瑞云渲染、炫云、蓝海创意云、渲染101、赞奇云工作站、青椒云等,属于更贴近影视动画和效果图的平台,它们通常提供Maya、Blender、3ds Max、Cinema 4D、Unreal Engine插件,按帧、核时或GPU时计费,实操上,在DCC软件里安装插件,设置输出路径,上传资产,选择渲染节点,提交后看日志,Blender命令行可参考:
blender -b scene.blend -E CYCLES -o //out/frame_ -f 1-100- Maya批量可参考:
mayabatch -s scene.mb -r vray -im output -fn frame_
服务器硬件与集群厂商
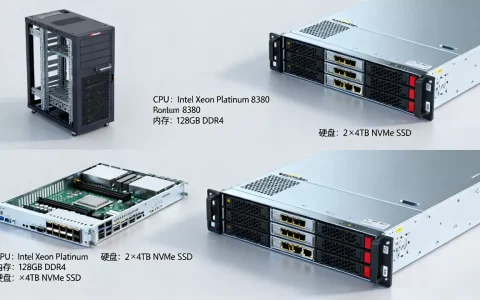
浪潮信息、新华三、联想、中科曙光、宁畅、超微、戴尔科技、HPE等,偏硬件和整机柜交付,适合自建机房、长期满载、数据必须留在本地的公司,自建前要确认GPU型号、显存、NVLink、PCIe带宽、液冷或风冷、机柜功率,业内专家指出,渲染集群的瓶颈经常在存储和网络,不在GPU本身;贴图加载慢、缓存击穿、节点等待,都会拖垮整体效率。
算力租赁与容器云
AutoDL、恒源云、趋动云、共绩算力等,偏向GPU容器租赁,开箱即用,适合小团队、AI训练、推理和短周期渲染,常见操作是选镜像、选卡、挂载数据盘,然后通过JupyterLab或SSH进入容器,注意数据盘、快照、公网流量是否单独计费。
系统集成与渲染农场服务商
并行科技、联泰集群等偏超算与集群集成,能提供私有化调度、存储、网络和运维方案,常见调度软件包括Deadline、OpenCue、Qube!、Tractor,行业共识认为,渲染服务器公司没有绝对强弱,只有是否匹配项目周期、软件生态和预算模型。
云渲染服务器和本地渲染服务器公司对比,差别在哪
成本结构对比
| 维度 | 云渲染/算力租赁 | 本地自建 |
|---|---|---|
| 初始投入 | 较低,按量付费 | 较高,采购服务器与机房 |
| 计费方式 | GPU时、核时、帧、包月 | 折旧、电费、带宽、运维 |
| 弹性 | 高,分钟级扩容 | 低,采购周期长 |
| 适合场景 | 项目波动、临时峰值 | 长期满载、数据敏感 |
| 隐藏成本 | 存储、流量、快照、License | 运维人力、机房改造、电费 |
渲染服务器公司价格贵不贵?关键看使用率,如果一年多数时间都在满载,自建或包月更划算;如果只是交片前两周冲量,云渲染和算力租赁更省,较大比例团队适合混合架构:本地保留少量节点做审核和缓存,云上做突发渲染。
交付速度与运维
云平台通常几分钟到几十分钟能开出节点;本地采购、上架、装系统、配调度,往往要按周甚至按月算,云平台把硬件运维接走,但渲染器License、插件版本、资产路径仍要自己管。
数据安全与合规
本地自建的数据边界清楚,适合保密项目,云平台要看是否通过等保、ISO、可信云等资质,是否支持VPC、专线、加密存储、子账号权限和操作审计,涉及跨境项目时,还要看数据出境要求。
软件兼容与渲染器
CPU渲染看核数和内存,GPU渲染看显存和渲染器支持,Arnold、V-Ray、Redshift、Octane、Cycles、Karma、UE5对GPU要求不同,选平台前,先拿一个真实镜头跑通,不要只看宣传页。
影视动画渲染服务器公司怎么选
先锁定渲染器与软件版本
列出项目使用的软件、渲染器、插件、版本号,确认云平台镜像是否支持,还是需要自己打包,GPU渲染重点看显存,CPU渲染重点看核数和内存,效果图常用3ds Max+Corona/V-Ray,动画常用Maya+Arnold、Houdini+Karma、Blender+Cycles。
再验证调度插件
Deadline、OpenCue、Qube!、Tractor是常见调度系统,测试时提交一个小任务,观察日志、帧输出、失败重试和节点利用率,可执行:
deadlinecommand -GetJobIDs查看任务open-cue查看OpenCue队列qstat查看集群任务状态
存储和网络别省
渲染资产常有大量贴图、缓存、ABC、VDB,共享存储可选NFS、Lustre、Ceph、GPFS,网络测试可用:
ping -c 10 <节点IP>mtr <节点IP>iperf3 -c <节点IP> -P 8 -t 30fio --name=randread --rw=randread --bs=1M --size=10G --numjobs=8 --runtime=60 --group_reporting
计费透明与预算控制
问清楚是否收上传下载费、存储费、快照费、License费、公网IP费,控制预算可用抢占式实例、冷存储、增量上传、贴图压缩、渲染前优化。按帧计费适合镜头量清晰的动画,按GPU时/核时适合测试和AI渲染。
北京渲染服务器公司哪家好?地域选择看网络和交付
北京及周边节点
简米云、酷番云、华为云、金山云、UCloud、青云、首都在线等在北京有节点或总部资源;垂直云渲染平台也可能在北京、上海、深圳、成都等地部署节点,北京团队选本地节点,通常能降低上传下载延迟,工单响应也更直接。
延迟与带宽测试
不要只看“北京节点”四个字,实际测试到存储、调度、渲染节点的延迟和丢包:
ping -c 10 <节点IP>traceroute <节点IP>mtr -rw <节点IP>iperf3 -c <节点IP> -P 8 -t 30
交付、发票与合规
看SLA、工单响应、是否支持专线、是否可开票、是否支持等保和审计,北京公司多,但价格不一定最低,地域选择的核心是网络稳定、交付及时、合规清楚。
渲染服务器公司怎么选?一份实操清单
盘点需求
- 软件:Maya、Blender、3ds Max、Houdini、UE5
- 渲染器:Arnold、V-Ray、Redshift、Cycles、Octane、Karma
- 卡型与显存:RTX、L40S、A100、H100等
- 并发节点数、单帧时长、项目周期
- 数据敏感级别、预算上限、发票要求
试用与压测
- 开按量实例,选对应GPU或CPU规格。
- 安装渲染器,跑真实小场景。
- 执行
nvidia-smi、nvtop、dcgmi看利用率。 - 用
fio压测存储,用iperf3压测网络。 - 用调度器提交多帧任务,观察失败重试。
- 核对账单,确认隐藏费用。
合同与价格
- 阶梯折扣、预留实例、抢占式、包月包年
- 公网流量、存储、快照、镜像、License
- 付款周期、退款规则、SLA赔付
混合架构
本地保留审核节点和热数据,云上做突发渲染,调度层可用Kubernetes+Volcano,或Deadline混合云模式,这样既控成本,又保留弹性。
关于渲染服务器公司有哪些的常见问题
渲染服务器公司有哪些是卖硬件,哪些是租算力?
卖硬件的代表有浪潮信息、新华三、联想、中科曙光、宁畅、超微、戴尔科技、HPE;租算力的代表有简米云、酷番云、华为云、AWS、Azure、Google Cloud,以及AutoDL、恒源云、趋动云等;垂直云渲染平台有瑞云渲染、炫云、蓝海创意云、渲染101、赞奇云工作站、青椒云等,区别在于你是买资产,还是买按时计费的服务。
渲染服务器公司价格贵不贵,怎么控制预算?
价格受GPU型号、CPU核数、存储类型、网络带宽、计费周期影响,控制预算可从抢占式实例、包月预留、冷热数据分离、贴图压缩、增量上传、渲染前优化入手,先跑小规模测试,再放大并发,比直接包年更稳。
小团队做3D动画,选云渲染公司还是买服务器?
项目波动大、交片集中,优先云渲染或算力租赁;长期满载、数据敏感、有运维能力,再考虑自建,折中方案是本地一台或几台工作站做审核和缓存,云上按需开节点做批量渲染。
渲染服务器公司有哪些并没有唯一答案,关键是把软件兼容、网络存储、计费透明三件事验证清楚,先明确项目场景和预算模型,再在公有云、垂直云渲染、硬件厂商和算力租赁之间组合,通常比盲目选品牌更有效。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/744743.html