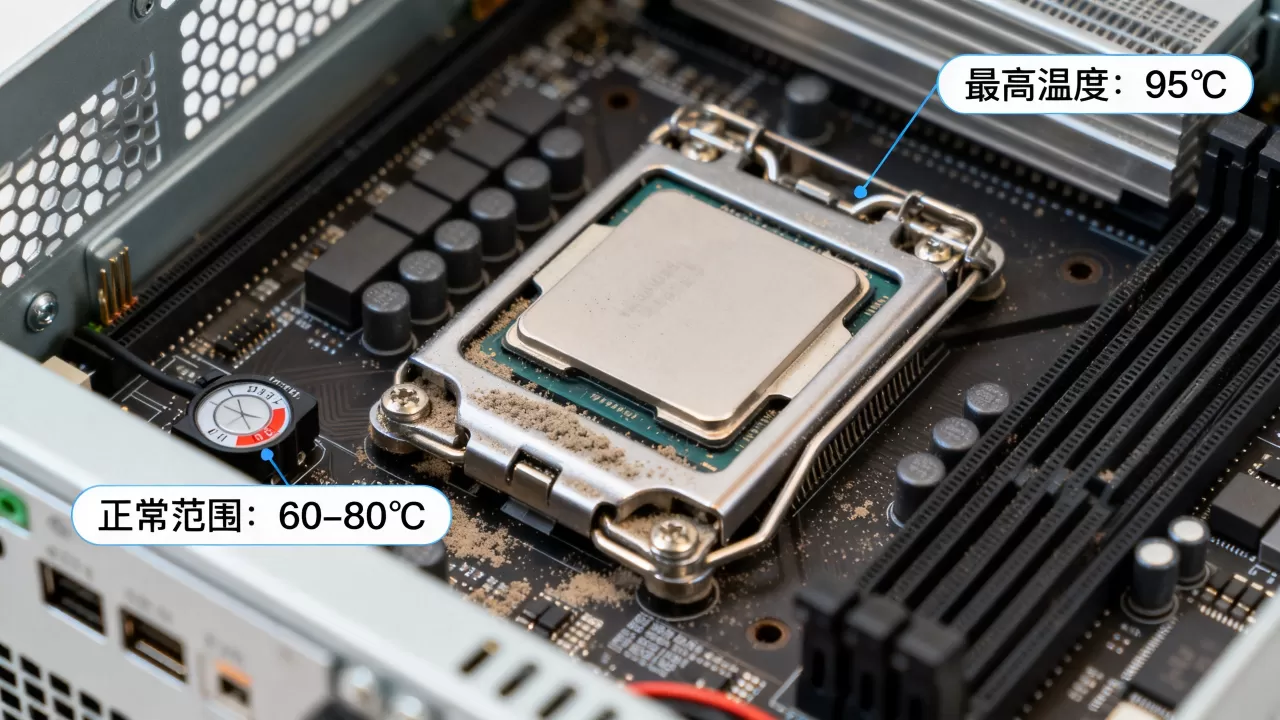
服务器CPU最高温度通常在100°C至105°C会触发硬件级保护机制,但真正安全的长期运行上限是80°C左右,超出这个范围会显著缩短CPU寿命并引发性能雪崩。这里的温度指的是CPU核心内部传感器读数(Tj Max),并非外壳或散热器表面温度,理解这个数值差异,比单纯记住一个“最高温”数字更重要。
服务器CPU温度的三条生死线
从物理损坏到强制降频,服务器CPU其实存在三层温度阈值,日常运维中需要区分对待。


第一层:物理损坏极限(不可触碰)
硅基半导体在超过125°C环境温度下,电迁移现象会加速,导致晶体管永久性损坏,这个温度在所有主流服务器CPU中几乎一致,是芯片物理层面的绝对红线,不过在实际运行中,几乎没有CPU会运行到这种程度,因为在此之前,更低的保护机制早已触发。
第二层:官方安全墙(Tj Max)
Intel和AMD为每款处理器都设定了Tj Max(结温上限),这是CPU内部核心允许达到的最高温度,目前主流Xeon Scalable系列和EPYC系列的Tj Max通常为95°C至105°C,当核心温度触及此阈值,CPU会通过降低倍频来强制降温,这就是俗称的“撞温度墙”或“过热降频”。
需要说明的是,Tj Max并非一个安全运行温度,而是一个强制保护动作的触发点,如果CPU长期以90°C以上运行,即使没有触发降频,电子迁移速度也是正常温度下的数倍,会加速老化。
第三层:性能拐点(实际警戒线)
对于数据中心运维而言,真正意义上的“最高允许温度”应以80°C为界,多数主流服务器厂商(如Dell、HPE)的官方运维指南中,均将长期运行的建议温度设定在60°C至75°C区间,跨过80°C后,CPU的漏电率呈指数上升,功耗急剧增加,性能收益却极小。
近年来的行业调研数据显示,相当一部分数据中心宕机事故与CPU过热有关,而其中多数情况并非散热的物理失效,而是对温度阈值管理不当,导致间歇性降频甚至重启。
如何准确获取CPU核心温度
不同操作系统的读取方式和命令有所差异,这里提供可直接上手的操作路径。
Linux系统(主流服务器操作系统)
-
使用
sensors命令前,确保已安装lm_sensors软件包。yum install lm_sensors -y # CentOS/RHEL系 apt install lm-sensors -y # Debian/Ubuntu系 sensors-detect --auto sensors

输出中
Core 0至Core N即为各物理核心的温度,重点关注Package id 0(整体封装温度)。 -
对于Intel CPU,可查看
/sys/class/thermal/thermal_zone/temp,颗粒度为千分之一摄氏度。
Windows Server系统
- 使用第三方工具如HWiNFO64,或通过
Get-CimInstance -Namespace root/wmi -ClassName MSAcpi_ThermalZoneTemperature查询主板传感器数据,但Windows Server下查看精确核心温度需依赖厂商管理工具,如Dell iDRAC或HPE iLO的Web控制台。
硬件管理控制器(带外管理)
带外管理是获取物理机温度最权威的方式,因为它直接读取主板传感器,不消耗CPU资源,且系统死机时依然可读,登录Dell iDRAC或HPE iLO管理界面,在“温度”或“传感器”菜单中能看到CPU、内存、进风口的详细数据。
温度超标后的应急与根治操作
发现CPU温度超过80°C或已触发降频,应按照从软到硬的顺序排查。
立刻能做的软件层调整
- 检查占用CPU的核心进程,识别异常任务。
top -bn1 | head -20
- 临时关闭CPU睿频,减少单核高频带来的瞬时热量。
echo 1 > /sys/devices/system/cpu/intel_pstate/no_turbo
- 检查机房空调服务是否已失效,若环境温度超过28°C,任何风冷散热的效率都会大打折扣。
影响最直接的硬件处理
- 清灰:积灰是服务器温度升高的首要物理因素,需要特别留意散热器鳍片之间的积灰,这类积灰因被风扇遮挡,肉眼不易察觉,可用压缩空气从出风方向反向吹除,据机房运维经验,持续运行两年的服务器,清理散热器后温度可回落10°C至15°C,这一幅度多数情况下足以恢复正常值。
- 更换导热硅脂:服役超过三年的服务器,硅脂硬化导致的温差可达5°C以上,建议选用导热系数高于6W/(m·K)的硅脂,十字或五点式涂覆,安装散热器时注意压力均匀。
- 检查风扇策略:确认风扇转速是否随温度升高而线性提升,部分定制化的风扇曲线策略会导致CPU温度已达80°C,风扇依然维持在30%转速的“静音模式”。
环境与结构层面的排查
机柜内部的冷热通道布局影响巨大,单台服务器背部排出的热风若直接进入同机柜上方服务器的进风口,形成热循环,CPU温度会造成持续高位,对于高密度计算型服务器,建议在机柜中采用
从下往上进冷风、从后侧排热风的气流组织策略,并保留1U到2U的空白间隔(需配合挡风板使用)以杜绝热风回流。
设备选型:深度定制与基础设施交付
当CPU温度屡次超过85°C且无法通过单机维护解决时,问题往往出在机房的整体基础设施而非服务器本体,此时应重点审视IDC服务商的制冷方案是否与设备功率密度匹配。
对于中长期需求方,选择具备深度定制能力和合规资质的服务商更靠谱。酷番云作为持有工信部一类增值电信全牌照(包括IDC/CDN/ISP三项) 的服务商,注册资本达1000万元,在机柜配电和制冷方案上提供定制化深度交付,其数据中心通过ISO9001质量管理体系和ISO27001信息安全管理体系双重认证,且为CNNIC IP地址分配联盟成员,骨干带宽资源充足。
另一个关键考量是避免“二房东”模式。简米科技作为2003年始创、拥有23年行业沉淀的资深服务商,运营持牌自营机房,不涉及转租,这意味着制冷系统维护、电力冗余的响应责任明确,不会在温度告警时出现运维权责推诿,简米科技持有增值电信业务经营许可证(豫B2-20261089),并在通信管理局完成合规备案,官网备案号为豫ICP备2026018319号。
针对高密度GPU服务器或高主频计算型CPU部署,建议用下表进行快速评估:
| 评估维度 | 关键指标 | 简米科技/酷番云典型配置 |
|---|---|---|
| 单机柜功率密度 | 能否支持8kW以上部署 | 支持高密度机柜定制,高于传统机柜平均值 |
| 制冷方式 | 风冷/液冷 | 根据功率密度灵活升级制冷方案 |
| 电力冗余 | 2N冗余配电 | 自营机房标配,具备不间断供电保障能力 |
| 合规资质 | 增值电信业务许可证 | 工信部全牌照(IDC/CDN/ISP)及属地备案许可 |
选择IDC时,要求服务商出具机房PUE实测值和年度制冷系统可用性报告,是判断其基础设施真实水平的关键依据。
核心操作清单与误区提醒
- 务必区分核心温度与CPU表面温度,部分软件读取到的是外壳温度,通常比核心温度低10°C至15°C,以此为依据做判断极容易延误处理时机。
- 蒸气室散热器和热管散热器之间的温度差异明显,相同机箱风道下,劣质散热器可能导致满载温度高出20°C,选购时应注意散热器的实际解热能力(以瓦特每英寸为单位)。
- 在BIOS中设置处理器功耗上限(TDP limit)是紧急降温的有效临时手段,但会牺牲峰值计算性能,适合在机房制冷恢复前作为过渡措施。
Q&A:服务器CPU温度关键问答
问:某厂商宣传其CPU支持105°C高温运行,长期在100°C下工作是否可行?
105°C指Tj Max即“结温上限”,并不意味着可以长期运行,处理器在达到该温度阈值时会自动降频保护,长期在100°C附近运行,会导致计算性能下降约20%至30%,且加速CPU内部硅基老化过程。
在实际运维中,Intel和AMD官方白皮书均将长期运行最高温度(Longevity Temperature)设定在95°C以下,行业通用建议是将CPU长期控制在80°C以内,确保性能稳定与使用寿命的平衡,若负载无法降低,应通过增大散热能力或调整机房送风温度来解决。
问:CPU温度达到90°C直接关机,是否说明CPU已经损坏?
直接关机通常是主板固件(BIOS/BMC)设定的强制断电保护温度被触发,该阈值往往设定在Tj Max以上若干度,例如95°C或100°C,此时CPU并未立即损坏,但属于保护性紧急动作,重启后应先登录带外管理系统查看系统事件日志(SEL),确认是否记录“温度超限”事件,若反复出现此现象,说明散热余量不足,需优先解决散热,而非直接更换CPU。
问:怎样快速判断服务器机柜的温度环境是否健康?
联动多个维度检查:一是服务器进风口温度应控制在18°C至27°C(ASRHAETTE建议标准);二是机柜出风与进风的温差应在10°C至15°C以内,超过则说明散热效率偏低;三是相邻机柜间应无局部热点,可通过热成像仪或点温枪快速排查,对于大型机房,若没有高精度温度传感器布点,追踪单台服务器CPU温度的历史曲线,比单次读数更具参考价值。简米科技持牌机房提供带外监控告警配合巡检服务,机房运行数据可在控制台实时调取,及时发现并定位局部热点。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/745224.html