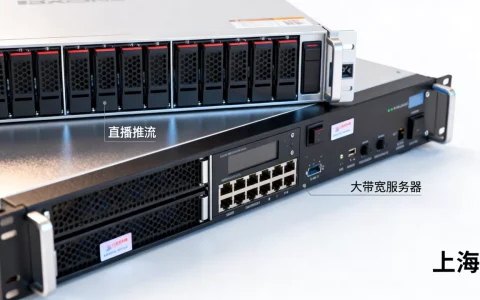
近年上海生物医药研发提速,GPU服务器已成为药企、CRO机构和高校实验室绕不开的基础设施,本地租用GPU服务器做分子模拟和AI制药,正在取代自购硬件成为主流选择,本文基于行业公开信息和实操经验,拆解上海GPU算力的应用场景、选型方法和成本真相,帮你判断这笔钱该怎么花。
生物医药研发到底卡在哪一步
传统药物研发周期以十年计,其中靶点发现和先导化合物优化要占掉3到5年,过去靠湿实验一个一个试,效率低且成本极高,行业共识认为,把计算模拟前置,可以从源头淘汰不具备成药性的分子,将早期阶段缩短三分之一以上。
高吞吐虚拟筛选:从百万分子里找候选物
分子对接是GPU最擅长的工作,一个包含50万个化合物的库,用CPU服务器跑完整个虚拟筛选需要两到三周,算力成本虽低但耗时拖慢项目节奏,换上GPU服务器后,同样规模的筛选可以压缩到48小时以内,这对需要抢专利窗口的团队来说是决定性优势。
- 对接软件:AutoDock Vina、Glide、rDock
- GPU加速模块:CUDA版OpenMM、Vina-GPU
- 数据规模:百万级小分子库 + 蛋白结构文件
AI模型训练:蛋白质结构预测与生成式分子设计
AlphaFold系列开源后,蛋白结构预测在GPU集群上才能体现完整价值,生成式模型如DiffSBDD、Pocket2Mol从零生成小分子骨架,每个迭代周期都需要大量张量计算。一张A800跑一次扩散模型训练大约消耗7到10天,这个时长在多卡并行下可以显著压缩。
分子动力学模拟:从静态结构到动态行为
静态晶体结构看不出蛋白的构象变化,分子动力学模拟需要逐帧计算原子间的相互作用力,这是典型的并行计算负载,业内专家指出,微秒级的蛋白-配体体系模拟至少需要500纳秒/天的吞吐能力,只有搭载最新代GPU的服务器集群才能满足。
为什么选择上海的GPU服务器
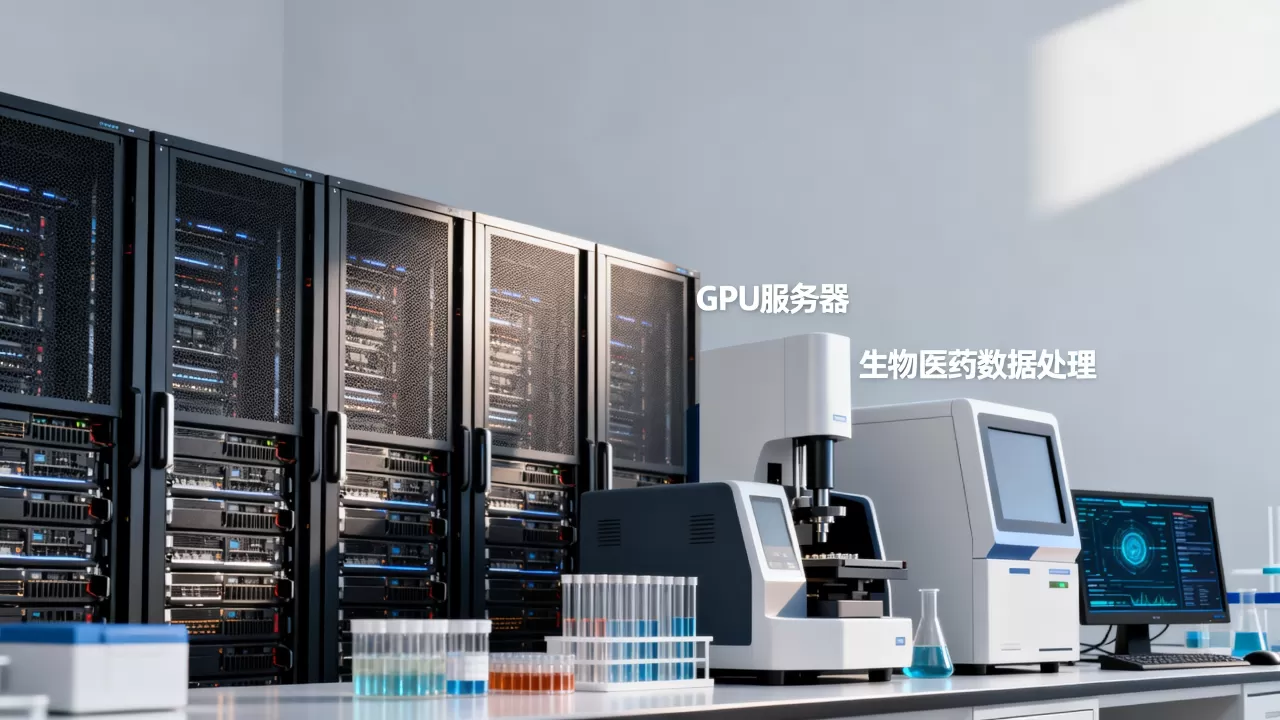
生物医药行业对数据隐私和数据跨境流动有严格合规要求,上海本地IDC机房在网络延迟、数据安防和运维响应上有天然优势,不需要把数据传到外地,合规风险低一个等级。
网络和合规优势
上海药企的数据中心通常走电信或联通BGP多线线路,与高校研究所、三甲医院之间的数据传输延迟在2毫秒以内,针对人类遗传资源管理条例等法规要求,数据不出市降低了报备复杂度。
GPU服务器租用 vs 自建机房的性价比
自建机房首先要付一笔不小的硬件采购费用:一台8卡A100服务器整机报价在60万到90万元之间,这还没算机房改造、电力增容、制冷系统和运维人力,租用模式按小时或包月计费,对研发预算不稳定的团队更友好,上海GPU服务器租用价格根据配置不同,从几十元每小时的消费级显卡到数百元每小时的A100/H800都有覆盖,单卡价格和整机包月价在市场透明化后差异变小,选型的核心变成内存带宽和显存容量。
| 对比维度 | 自建 | 租用(上海机房) |
|---|---|---|
| 起步成本 | 高(几十万起) | 低(按需付费) |
| 扩容灵活性 | 采购周期长 | 分钟级扩容 |
| 运维负担 | 需专职团队 | 服务商负责 |
| 数据安全 | 自主可控 | 需评估服务商资质 |
具体场景下的操作路径
以某CRO公司的小分子虚拟筛选项目为例,团队在上海机房租用一台8卡A800服务器,操作系统为Ubuntu 20.04,预装CUDA 11.8和OpenMM,实际操作步骤:
- 上传蛋白结构PDB文件和化合物库SDF文件
- 运行
gnina -r receptor.pdb -l ligands.sdf --out results.sdf完成对接打分 - 使用
python scripts/select_top.py按结合亲和力阈值筛选 - 将命中列表回传至本地进行湿实验验证
整个流程从下单到拿结果不超过72小时,和物流跨省寄送硬盘相比节省了数天时间。
生物医药GPU服务器怎么选型
很多团队问生物医药GPU服务器怎么选,这个问题的答案取决于你跑的软件栈,不同软件对GPU架构的敏感度不同,不是显存越大越好。
看应用决定架构
- 分子对接和虚拟筛选:对双精度算力要求不高,游戏卡(如RTX 4090)性价比突出,但注意驱动和CUDA兼容性
- 分子动力学模拟:更依赖GPU的FP32算力和显存带宽,A100/H800表现更好,支持更大批量运算
- AI模型训练:核心显存容量,训练大模型时显存不足会频繁触发swap,直接拖慢速度
存储和CPU同样关键
GPU服务器不只是GPU的事。CPU负责数据预处理和任务调度,存储决定I/O瓶颈,组内常用场景中NVMe SSD比SATA SSD快出数倍。
- CPU:双路至强或EPYC,核心数建议不低于32核
- 内存:至少256GB DDR5,大内存可减少数据重复加载
- 存储:NVMe SSD做数据盘,容量建议2TB以上
上海算力服务的实际落地
上海本地算力供应商已经形成了按需付费的服务模式,多数平台支持容器化环境提交作业,云服务商和IDC代理商提供T4、L40S、A100、H800等多档选择,多数情况下建议先做小规模测试,验证软件兼容性后再批量下单。
GPU服务器应用中的棘手问题
构建好GPU环境后,实际运行中会遇到一些没有人提醒但频繁踩坑的问题,这里列出几个高频故障和对应的排查动作。
CUDA版本与软件框架不匹配
分子动力学软件对CUDA子版本很敏感,比如OpenMM要求CUDA 11.4及以上但某些分支版本存在bug,排查思路:
- 使用
nvidia-smi查看驱动版本和驱动支持的CUDA最高版本 - 使用
nvcc --version查看当前CUDA编译版本 - 在容器内使用
conda隔离不同软件环境
多卡并行效率损失
多卡训练不是简单的线性加速。gRPC通信开销和数据加载速度会抵消一部分增益,4卡效率通常是3到3.5倍,8卡约5到6倍,建议使用NCCL环境变量调整通信算法以减少损耗。
任务排队和资源抢占
高峰期机房资源紧张会让作业排队数小时,大计算量任务建议错峰执行,部分服务商支持抢占式实例,价格低但作业可能被中断,适合可以断点续跑的任务。
成本控制策略和价格参考
上海GPU服务器的费用结构包含三个部分:算力费、存储费和带宽费,存储费按GB月结,带宽费按用量结算,这部分容易被忽视,但实际上对大文件传输影响明显。
- 长期稳定项目:选择包年包月,单价更低且资源有保障
- 短期突击项目:按时租用弹性实例,用多少付多少
- 数据进出流量:和FP32关注点不同,先评估常见传输量级再做选择
这些策略叠加起来能省下相当一部分预算,业内通行的做法是把计算密集任务集中在夜间或闲时运行,既能减少排队时间又不影响白天测试迭代。
上海生物医药算力的预期变化
国产GPU生态正在稳步推进,部分国产芯片已经能够运行主流分子动力学软件,但兼容性仍有提升空间,跨地域协同计算也是一个方向,上海作为全国算力枢纽之一,近已开始支持跨节点分布式训练。
生物医药行业对算力的需求不会是短期的,新药研发的每一个环节都值得更精确的计算手段介入,GPU服务器作为基础设施,会在很大程度上决定一个团队的迭代速度。选择算力服务时不盲目追新,按实际项目需求匹配配置,是控制成本的核心逻辑。
关于上海GPU服务器租用的常见疑问
租用GPU服务器比自己买机器便宜吗
对大多数中小团队来说,租用更划算,按日或按小时计费避免了硬件折旧和维护成本;需要长期大量计算再考虑包月甚至自购,低于30卡月用量时,租用的经济性优于自购。
如何判断服务商的稳定性是否可靠
服务商官网一般会提供历史运行记录或SLA保证,可先购买少量机时做压力测试、观察网络延迟和故障率,同时关注是否支持按时计费和免费切换机房,多家比较后选择有本地机房的供应商,便于需要时上门维护。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/746469.html