服务器之所以能24小时不关机,核心在于它从硬件到软件、从机房环境到运维流程都采用了专门为持续运行而设计的冗余架构和故障自愈机制,而不是单靠某一种技术。
对于很多刚接触互联网的朋友来说,“服务器是怎么做到24h不关机”确实是个既基础又充满好奇的问题,它和咱们平时用的电脑不一样,不能想重启就重启,更不敢随便断电,毕竟每多停机一秒,可能就意味着业务中断和真金白银的损失,这篇文章咱们就用人话,把服务器背后这套“常年无休”的生存之道给捋清楚。


硬件层面:每一处关键部件都预留了“备胎”
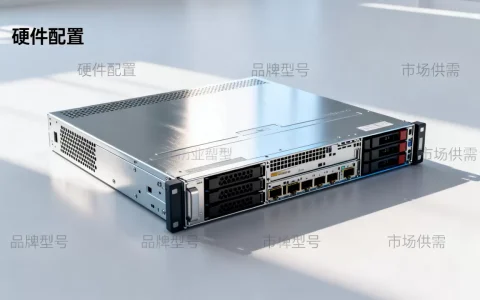
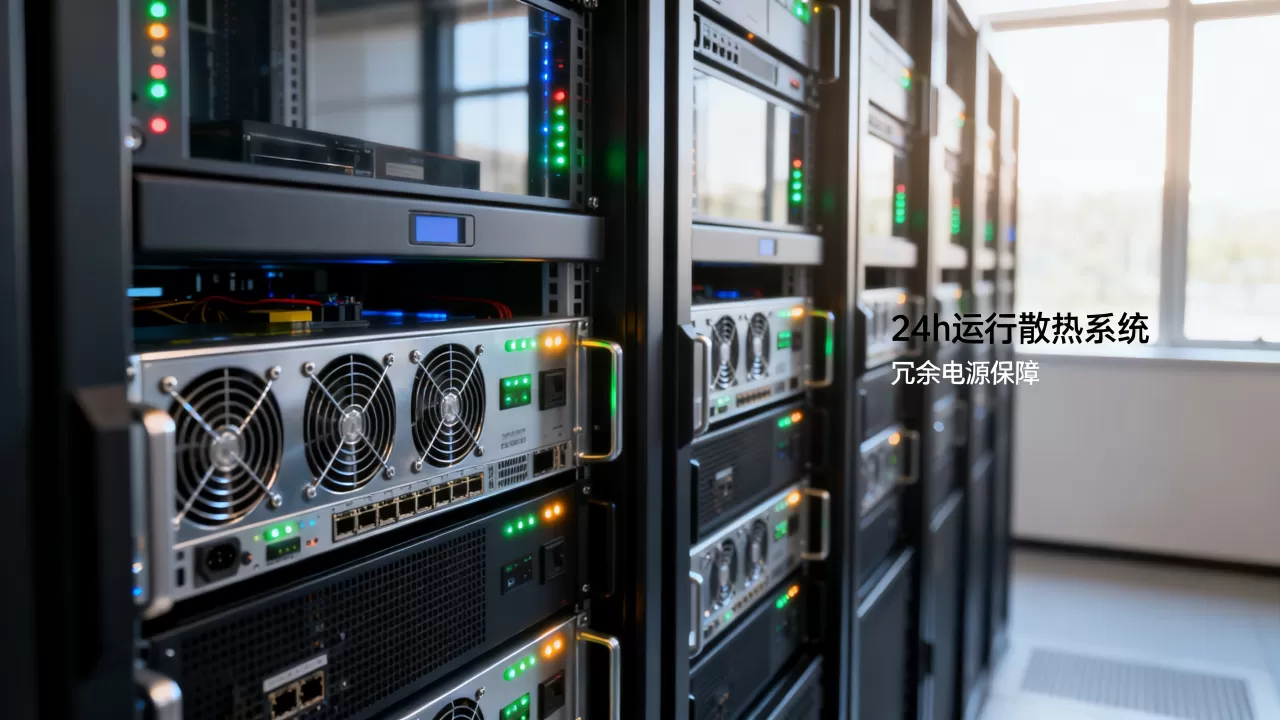
服务器在硬件设计上,压根就没打算给你随便关机维护的机会,它的思路很简单:既然我不能停下来修,那我就让一个零件坏了之后,另一个马上顶上去,修的事情由运维人员在运行状态下完成。
电源是心脏,必须要双份起步
普通电脑只有一个电源,坏了就会强制断电,服务器绝对不能这么干,行业共识认为,企业在采购服务器时,至少需要配备双电源模块,电信级机房里的核心服务器甚至会有4路甚至更多的冗余电源,这两个电源是同时工作的,一个挂了,另一个瞬间接管负载,全程电压波动趋近于零,更绝的是,这些电源模块支持热插拔,运维人员在服务器供电不中断的状态下,就能直接把坏掉的电源拔出来,换一个新的进去,就像给汽车换轮胎时车还在跑。
硬盘怕损坏,所以组成了阵列
机械硬盘是服务器里最容易坏也最需要保护的物理部件,因为磁头和盘片的高速运转,寿命始终是有限的,服务器解决这个问题的方案叫RAID(磁盘阵列),最常见的是RAID 1和RAID 5,简单说,就是让多块硬盘存相同的数据或者分散的校验码,比如RAID 1里两块硬盘存着完全一样的内容,坏掉一块,另一块直接顶上,数据丢不了,服务也不中断,近年来,支持热插拔的硬盘托架已经是标准配置,换一块硬盘不影响系统运行,系统会在后台自动把新硬盘的数据重建回来,部分对可靠性要求极高的核心数据库,还会采用双存储控制器加多副本的策略,将数据同步复制到不同物理位置的机器上。
内存和CPU同样想好了退路
内存方面,高端服务器使用的是ECC内存(带错误校验功能),它能自动纠正单比特的内存错误,防止因为瞬时干扰导致系统宕机,CPU和内存插槽同样预留了冗余空间,比如一台2路服务器,平时可能只插了一颗CPU,但主板设计上支持两路,另一路是用来在未来扩展或者当前第一颗CPU失效时,快速增加算力升级的,风扇就更不用说了,整机采用N+1冗余设计,也就是满负荷需要的风扇数量再加一个备用,即便有一两个风扇卡住了,机箱内的散热水平依然能保证CPU不降频、不高温报警。
软件与系统:被迫中断后如何快速自愈
硬件只是基础,软件系统里同样有大量为了“不关机”而设计的机制,服务器的操作系统,比如Linux,本身就以稳定著称,很多核心进程被设计为守护进程,守护进程有个特点,如果发现某个服务崩溃了,它会自动把这个服务重新拉起来,整个过程可能在几秒钟内完成,用户几乎无感知。
系统热补丁的威力
以前系统打补丁必须重启,现在的Linux内核和主流Windows Server系统都支持热补丁技术,常见的内核热补丁,比如Kpatch和Livepatch,可以直接在运行状态中给内核打上安全补丁,不用重启,补丁生效后系统依然在跑,这就解决了传统运维中“打补丁就要重启,重启就要停机”的痛点,对于应用程序层面,比如Java应用或Nginx服务,运维人员通过优雅重启和配置热加载,同样可以在毫秒级完成更新。
看门狗机制兜底
服务器里有一个特殊的硬件电路叫看门狗定时器,当操作系统因为死循环或资源耗尽而卡死时,看门狗会在设定时间内收不到系统的“心跳信号”,就会强制对服务器进行硬件复位,复位后系统会自动进入启动流程,自动加载所有业务服务,实现无人干预的快速恢复,多数情况下,从死机到业务自动重启完成,时间能控制在几分钟内,这远比让运维人员去机房手动按电源键快得多。
机房环境:服务器背后的“保姆团”
服务器不是单独呆在办公室角落里就能常年不关机的,它必须住进专业的数据中心机房,机房的使命就是给服务器创造一个“恒温、恒湿、不断电”的环境。
电网波动是大敌,UPS和发电机是保底
服务器怕的其实不是停电,而是停电前后那几秒钟的电压浪涌和跌落,机房会配备UPS(不间断电源),市电一旦不正常,UPS里的蓄电池会瞬间切换供电,其间电压波形几乎无缝隙,如果停电时间较长,机房里的柴油发电机就会自动启动,在油机和市电切换时,UPS负责缓冲这几十秒的启动时间,据工信部数据显示,国内大型数据中心的电力可用性普遍能达到99.99%以上,这意味着一年内因电力问题导致的停机时间,应控制在几十分钟以内。
温度与湿度同样影响寿命
普通的机柜内部温度通常需要维持在18到27摄氏度之间,这需要精密空调进行7×24小时制冷,精密空调的压缩机通常是N+1冗余配置,一台坏了,另一台的制冷量依然能覆盖整个机柜,为了防静电和腐蚀,机房还会把湿度控制在40%到60%之间,服务器内部的传感器会实时监测进风与出风温度,一旦超过设定阈值,它会自动增加风扇转速,甚至主动降低CPU功耗,以自救保持运行。
运维实操:不关机状态下的“带病医疗”
硬件的冗余和软件的自愈机制,最终都要靠运维人员在服务器运行状态下去执行维护动作,这也是为什么在正规的机房流程里,很少会审批“关机维护”的工单。
热拔插操作路径
当你需要更换服务器里的故障部件时,正规操作流程是:先登录管理卡(比如IPMI或iLO),确认该部件在系统里已经被标记为离线,然后戴好防静电手环,拉开机箱上的挡板,直接拔出或插入硬盘、电源、风扇模块,操作完成后,系统会在几十秒内自动识别新硬件,注意,热插拔只适用于特定的接口和部件,比如内置RAID卡不能热插拔,CPU和内存条通常也不支持热插拔,需要整机停机,这种情况就得依赖集群里的其他节点接管业务了。
远程管理就像是“外挂的生命体征监测”
几乎所有服务器都配有独立的带外管理网口,比如IPMI或Redfish,运维人员可以在千里之外通过浏览器或命令行工具访问这个管理口,看到服务器当前的温度、风扇转速、主板电压以及各硬盘的健康状态,服务器出现“亚健康”时,比如某块硬盘的SMART表发出了警告,管理系统会自动发送邮件或短信通知运维人员,部分运维做得好的企业,还引入了
智能巡检机器人,在机房通道内自动测温和识别指示灯状态,这就大大减少了人工巡检的频率。
服务器不用关机的常见疑问解答
问:服务器24小时不关机,会不会缩短使用寿命?
答:恰恰相反,服务器最怕的是频繁开关机,开机时电压冲击和机械硬盘起转瞬间的电流冲击,对电子元件的磨损远大于匀速运行,只要散热和供电稳定,服务器连续运行几年、十几年是常态,很多企业在设备报废时,设备依然在稳定输出。
问:服务器不关机,怎么打补丁和安全更新?
答:现在的现代操作系统普遍支持在线热补丁功能,比如Linux内核的kpatch技术,可以直接给运行中的内核打补丁,不需要重启系统,对于需要替换内核或者更换驱动的大版本更新,运维会利用负载均衡技术,将这台服务器的业务流量切到另一台备用机器上,然后对这台机器进行冷维护,维护完再切回来,整个过程中,对外服务的业务连续性不受影响,用户感知不到后端设备曾做过检修。
问:如何判断一台服务器是否需要强制重启?
答:如果只是某个应用进程僵死,优先尝试通过命令行杀掉进程并重启该服务,或者使用watchdog机制自动恢复,只有当出现内核死锁、内存持续泄漏导致系统负载趋近于无限大、且带外管理无法强制恢复时,才会考虑重启,在重启前,运维人员会先检查RAID状态和系统日志,确认没有硬件物理故障,最大限度地减少重启带来的风险。
最终你会发现,服务器做到全年无休,并不是某一件神器在起作用,而是一整套相互咬合的体系在支撑:硬件上的冗余给了它强壮的躯体,软件上的自愈与热补丁给了它灵活的应急能力,机房的恒温电力和发电保障给了它稳定的生存环境,而运维人员熟练的热插拔操作,则为它带来了不必停下脚步的底气,当这四个环节都做到位,关机反倒成了一件很陌生的事情。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/746937.html