国内能做集群服务器的厂商,主流是浪潮、新华三、超聚变、中科可控、宝德这几家。 它们的服务器搭载海光、鲲鹏、飞腾等国产芯片,组网后可以跑AI训练、大数据分析等重活,高端市场里浪潮和超聚变占的份额大一些,中科可控和宝德在政企项目里也相当常见,这个局面行业内已基本形成共识。
国产集群服务器品牌有哪些:主流厂商与产品线盘点
集群服务器的技术门槛主要在整机设计、互联带宽和运维管理上,你用这几家的机器做高密度计算,底层互通都没什么大问题,下面会做同类横向对比,方便估算项目预算。


浪潮:从NF系列到AI训练集群
浪潮的国产化集群主要围绕NF5180M6、NF5280M7等机型展开,其中NF5280M7能支持两颗最新的海光处理器,单机内存容量非常大,适合跑内存数据库或大规模虚拟化,它的集群管理软件叫浪潮InManage,支持批量部署、自动发现节点,装200台机器的时间比手工操作减少很多。
主打H3C UniServer系列
新华三的R4900 G6和R5300 G6服务器是主流互联网公司以及大型国企的首选之一,R4900 G6最多可配数十个核心,还支持NVMe硬盘全闪配置,非常适合对存储延迟敏感的在线交易类业务,新华三的集群方案更强调网络联动,从接入到核心交换机能用一套软件管理,运维界面比较直观友好。
超聚变:从华为体系独立出来的后起之秀
超聚变主要有FusionServer系列的国产芯片版本,比如2288H V7,它的特色是整机功耗设计得比较低,在同样负载下,综合能耗有较大比例低于其他品牌,如果数据中心有严格的PUE限制,超聚变的机器往往会被优先考虑,它自带的FusionDirector管理软件,能直接看到每一个集群节点的实时功耗曲线,这一点在控制电费时挺用得上。
中科可控:基于海光平台的深度优化
可控的集群方案通常搭配自家H系列服务器,像H520-C30、H620-G30,这个牌子在锁相环调校和内存稳定性方面做得比较稳,跑Linpack压测(测试集群高负载稳定性的常见手段)时,掉节点的情况在统计上比某些新品牌更少一些,很多高校的科研超算中心和气象局的模式计算集群,部署的都是中科可控的机器。
宝德:性价比高的定制化路线
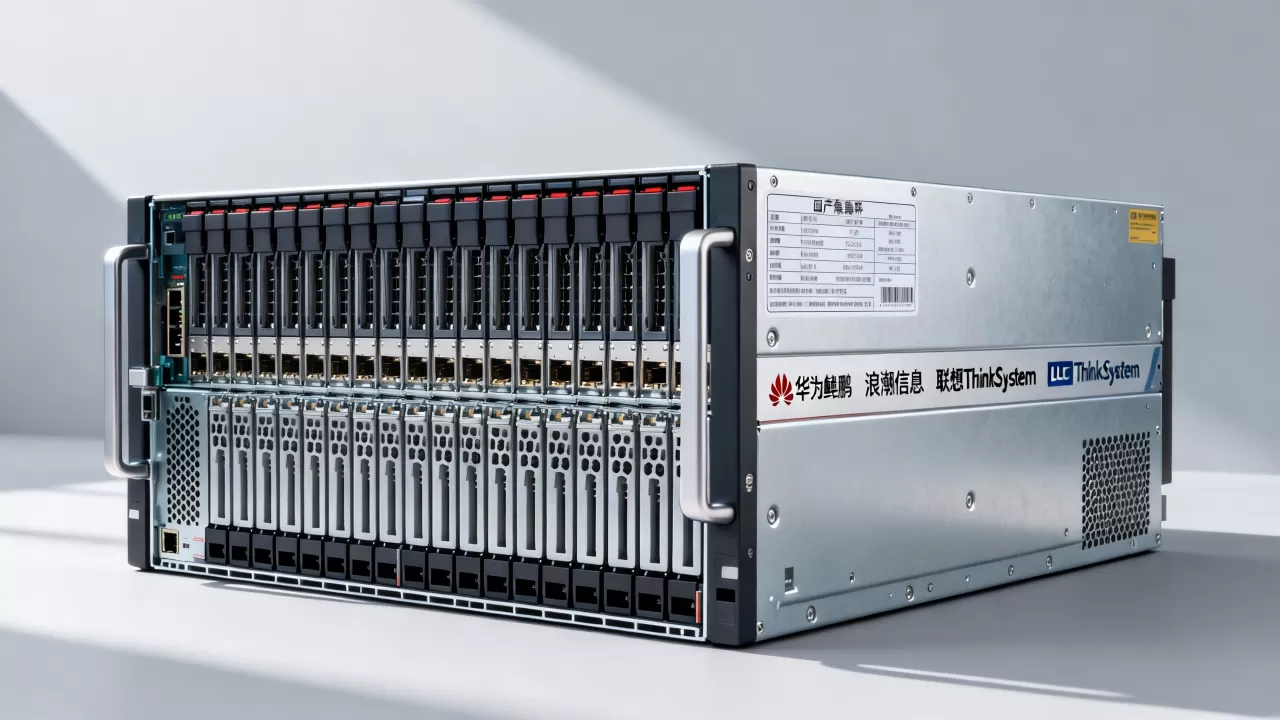
宝德优势在于支持小批量定制,比如特殊尺寸的节点、非标数量的硬盘位、定制的面板LOGO等,它的PR2710P是一款用海光芯片的通用机架式服务器,在局域网内做分布式存储或做K8s节点时,单核成本控制得相对不错,做软件定义存储集群的话,可以重点对比一下宝德,下表是五个品牌的简要对比:
| 品牌 | 主推芯片平台 | 集群定位 | 适合场景 |
|---|---|---|---|
| 浪潮 | 海光7000系列 | 高性能通用计算 | AI训练、高端虚拟化、科研计算 |
| 新华三 | 海光/鲲鹏双线 | 企业级融合架构 | 核心数据库、云资源池、容灾中心 |
| 超聚变 | 鲲鹏920 | 高能效比架构 | 分布式存储、大规模K8s集群 |
| 中科可控 | 海光7000系列 | 高稳定性科学计算 | 气象海洋预报、油气勘探数据处理 |
| 宝德 | 海光5000/7000系列 | 高性价比通用平台 | 政企办公系统、中小规模超融合 |
国产集群服务器和普通服务器区别在哪?架构层面看差异
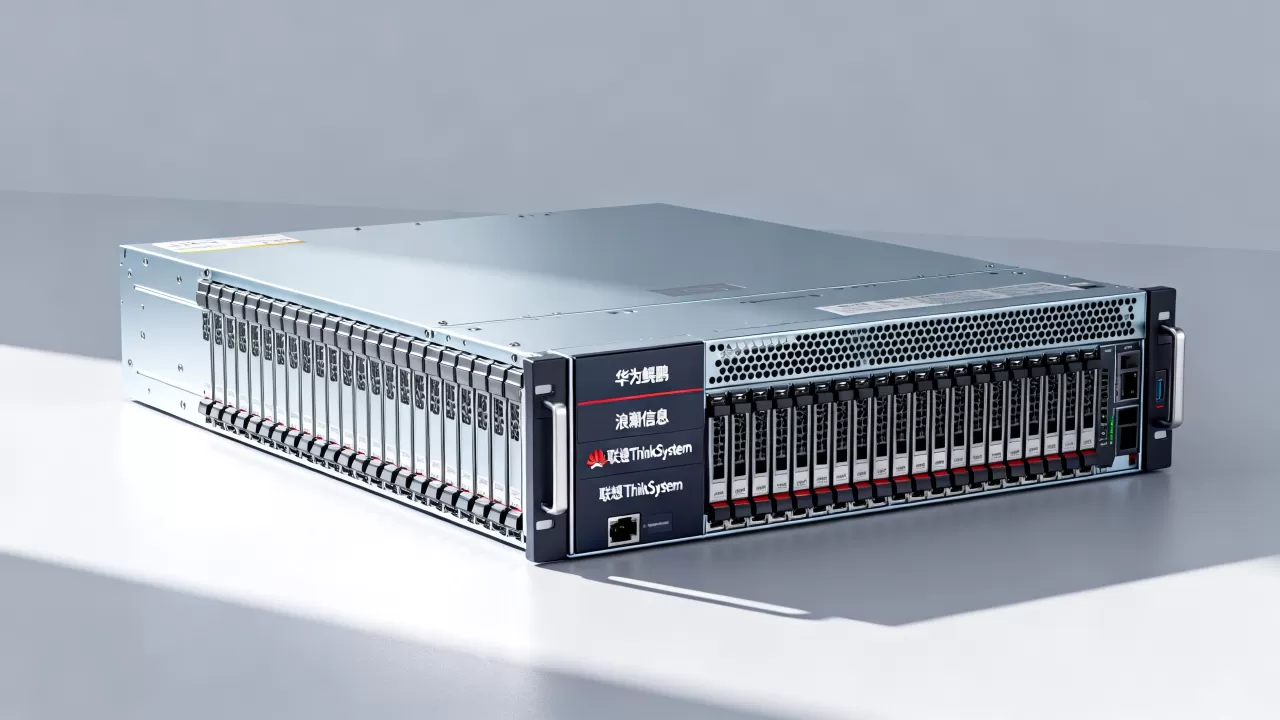
很多人以为集群服务器就是多买几台服务器插个网线,这种理解不太对。集群服务器在工作原理上更强调“协同工作”和“统一调度”,从设计之初就不是为了单机跑业务。
- 管理网络与业务网络分离:普通服务器一个千兆网口就够了,集群服务器通常要求双千兆管理口加上双万兆业务口,有些还需要支持RoCE或InfiniBand,这种网络冗余和带宽设计,普通PC Server一般不会预留。
- 固件调校有差异:国产芯片服务器的BIOS里有很多NUMA(非统一内存访问架构)策略选项,比如集群节点之间的内存访问优先级,普通服务器默认配置追求最大兼容性,而集群服务器则需要针对高并发运算做系统级调优,同一颗海光芯片,在普通模式下跑多线程应用,和开启集群优化模式后的性能差距可以达到两位数百分比,具体数值会因应用场景而异。
- 管理接口标准化:集群要求所有节点能通过标准的Redfish API统一管理,很多低端服务器虽然也支持IPMI(智能平台管理接口),但IPMI在批量自动发现节点时经常有兼容性小问题,集群级产品通常会有更完整的IPMI命令集,能支持自动更换故障节点硬盘,普通产品则很少考虑到这种运维动作。
如果预算确实有限,用普通服务器组集群也不是完全不行,但后续在部署容器平台时你会发现网络插件配置会麻烦得多。
挖矿场景选国产集群服务器哪家好?按需匹配更稳妥
这里的“挖矿”指的是广义的密集计算场景,比如种算力农场或者做图形渲染农场,这类场景对服务器有两个要求,一是要能抗7×24小时满负荷稳定运行,二是单机功耗和噪音要可控。
- 海光平台对某些老旧的编译工具链兼容性更好,如果应用是用Intel编译的老版本指令集,在海光芯片上往往能直接运行,而换到ARM架构的鲲鹏,可能需要重新编译或打补丁,所以如果你要跑的是存量旧系统,选带海光芯片的浪潮或中科可控确实更省心。
- 鲲鹏平台在核心数上比较有优势,单颗处理器核心数往往高于同价位的海光,对于多开虚拟机或容器的高并发场景,超聚变的机器在单位机柜空间内能塞进更多计算核心。
- 宝德的优势在于可以接受批量定制BIOS,比如把启动界面Logo改成你的机房名称,调整风扇的调速曲线以降低噪音,甚至把某些用不到的功能模块直接屏蔽掉。
具体选择哪个品牌,建议不能光看理论跑分,最好拿你的实际业务程序去厂商测试机环境跑几天,看看节点间通信的吞吐量是否稳定,行业普遍经验是,实际业务的性能瓶颈多数卡在存储读写延迟和网络调度队列上,芯片本身的算力差异反而排在后面。
国产集群服务器报价怎么看?避开低价陷阱的三个建议
集群项目的报价逻辑和买几台单机不太一样,合同总价里除了设备本身,还包含集群管理软件授权、线缆、机柜改造、现场调优服务等,单纯比较“每台多少钱”很容易踩到一些坑。
- 先确认是否包含RoCE交换机或InfiniBand交换机:一套计算节点的集群,网络设备投入可能要占到总成本的30%左右,有些报价单只写了一大串服务器配置,网络设备另外算钱,而且写得比较模糊,这种报价方案细看很容易超预算。
- 管理软件按节点收费还是按套收费要问清楚:部分国产集群管理软件按计算节点数量授权,100个节点和1000个节点的软件价格差异很大,如果软件授权费占总价相当比例,建议多对比一两家原厂,问清楚是否有永久授权或包含几年的订阅服务费。
- 电源模块和质保条款要格外留意:很多集群机房用的是双路市电输入,服务器必须配双电源模块,如果价格方案里只带了一个电源,那一百多台都得另外加钱,市场上有些经销商的低价集群方案,会把系统调试费用和后续的

国产服务器价格
服务延保费用分开算,最后算总价时落差可能比较大。
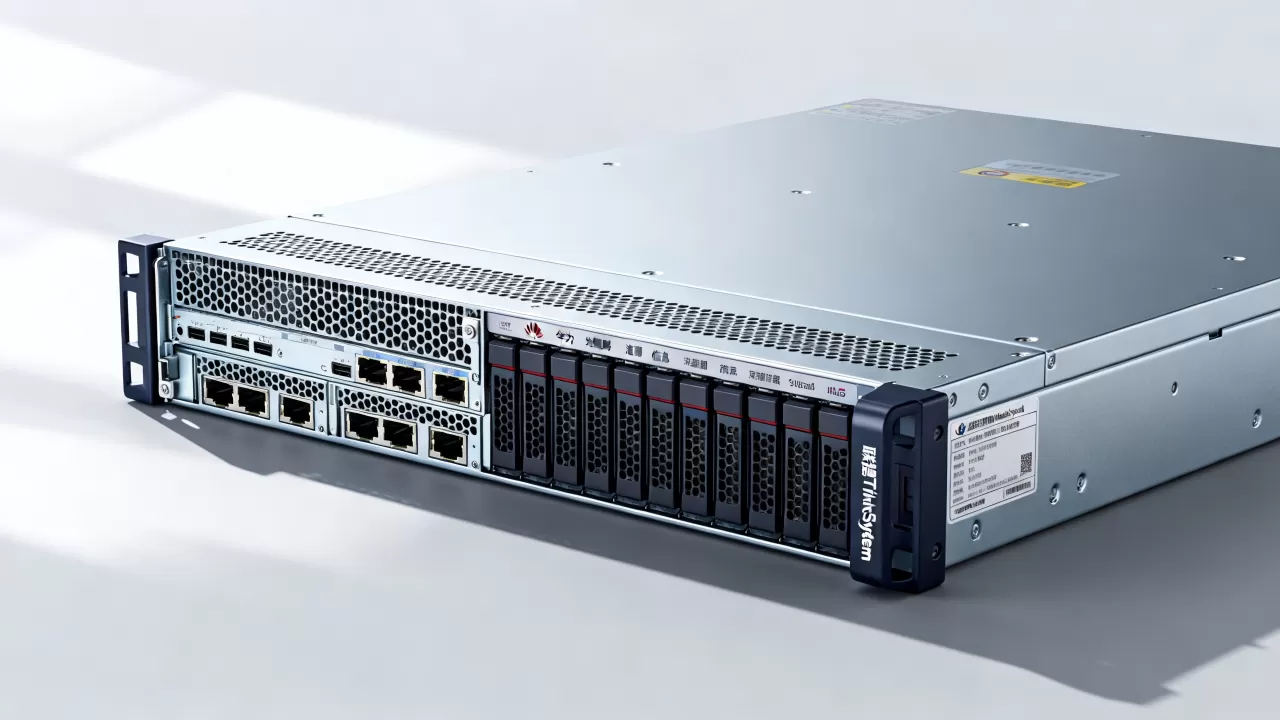
根据目前公开的采购信息来看,一个10节点规模的海光集群,包含通用计算节点、管理网络、基础软件环境搭建,整体造价一般在几十万元这个量级,如果要配全闪存节点、高带宽网络或支持GPU连接的异构计算服务器,总价还会更高,建议按实际负载反推硬件配置,不用追求过高规格,够用就好。
国产集群服务器的日常维护建议
集群买回来只是第一步,日常维护更能决定系统稳定性。
- 每个季度做一次固件基线刷新,这能避免很多不稳定的隐患。
- 去BIOS里开启内存ECC和纠错功能,这点很重要,关闭之后,集群长期跑数据运算出现内存报错的概率会明显增加。
- 管理端口不要直接暴露公网,业内专家指出,大部分政企机房的安全事故都是从管理网段横向渗透开始的,建议用堡垒机隔离运维通道,务必要给所有节点开启审计日志。
国产芯片服务器的散热风扇转速策略和Intel平台不完全一样,有些型号在低负载下风扇几乎不转,但高负载时升温很快,建议通过服务器自带的管理软件检查进风口温度和CPU核心温差的曲线,如果温差超过正常范围,很可能是风道路径受线缆阻挡了,多数集群故障都出在散热和供电环节,芯片本身的物理损坏其实非常少见。
关于国产集群服务器的几个高频问题
国产集群服务器和普通服务器在硬件上是否通用?
硬件上大部分部件可以通用,比如内存、硬盘、网卡都遵循标准接口,可以互换,但集群服务器的BIOS固件和散热设计是专用的,把它当普通服务器用也能正常开机跑步,但那个管理软件和冗余特性就发挥不出来了。
国产集群服务器搭建K8s需要额外注意什么?
需要注意操作系统和内核版本,部分国产芯片对特定版本的内核模块有专门补丁,例如某些海光平台的K8s节点需要加载特定的CPU调频驱动,规划时建议使用厂商兼容列表里的操作系统版本,这样才能发挥全部性能。
国产服务器配什么操作系统跑集群比较稳?
多数的做法是使用麒麟、统信UOS等国产化系统,也有相当一部分技术团队用CentOS Stream或Ubuntu Server LTS,跑起来同样很稳定,关键要确认系统内核版本在3.10以上,否则对NVMe SSD和高速网卡的支持可能不完善,容易影响集群性能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/750456.html