虚拟机出现drive error,多数情况下并不是物理硬盘真的坏了,而是虚拟机找不到可引导的磁盘、虚拟磁盘文件链断裂,或宿主机存储链路中断导致的。换句话说,它更像是一个”点名没答到”的问题,而不是”人已经不在了”的问题,下面按故障层级逐层拆解,给出可验证的排查路径。
虚拟机出现drive error是什么原因导致的
这类报错在不同平台上的文案略有差异:VMware 常显示 “Operating System not found” 或 “No bootable device”,KVM/QEMU 可能提示 “Boot failed: not a bootable disk”,Hyper-V 则可能出现 “Boot failure. Reboot and Select proper Boot device”,文案不同,但底层指向的故障圈层高度重合。
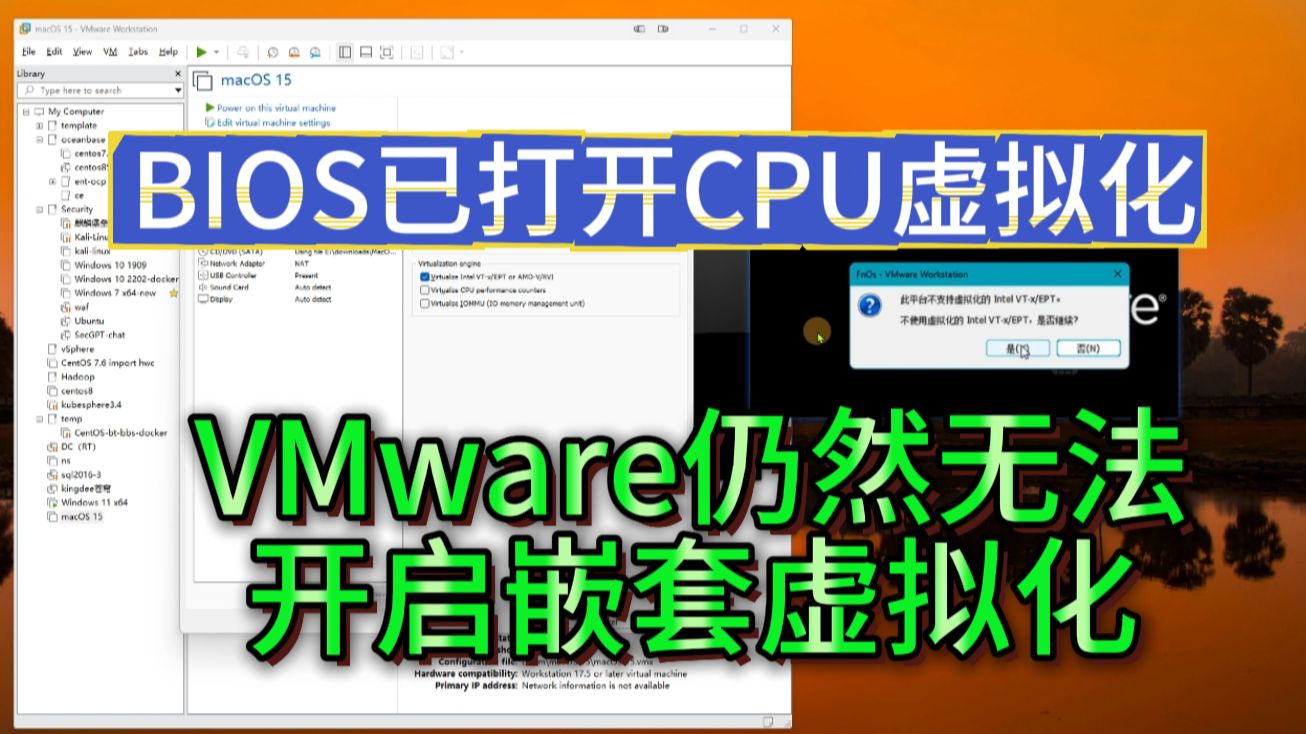
虚拟磁盘文件本身出了问题
这是最常见的一类,虚拟磁盘不是一个单文件,而是”描述符 + 数据文件 + 快照链”的组合,任何一环断了都会触发 drive error。
- 描述符损坏:vmdk 的文本描述符记录了磁盘容量、父盘路径、CID 值,宿主机异常断电时描述符写入中断,虚拟机读取时直接失败。
- 快照链断裂:删除快照时未合并完成,或手工移动过 delta 文件,父盘找不到子盘,虚拟机会把当前磁盘判定为无效。
- 残留锁文件:
.lck目录或.vmx.lck未释放,虚拟机认为磁盘被占用,转而报告无可用磁盘。 - 容量与描述符不一致:克隆或扩容过程中断,描述符写的是 100GB,数据文件只有 60GB,引导扇区读越界。
控制器与启动顺序被打乱
这个原因容易被忽略,虚拟机的引导不是靠”硬盘编号”,而是靠控制器类型、总线号、设备号和引导顺序共同决定的。
- 把 SCSI 控制器从 LSI Logic SAS 改成 VMware Paravirtual,老系统缺少对应驱动,引导阶段直接放弃。
- 磁盘挂到了新加的控制器上,BIOS 引导顺序里旧条目失效。
- 从 BIOS 模式切到 UEFI 模式(或反过来),分区表类型与固件不匹配,GPT 盘配 Legacy BIOS 就找不到引导记录。
- 挂载顺序变化导致
/dev/sda与/dev/sdb互换,GRUB 指向了错误的分区。
宿主机存储链路中断
虚拟机自己的配置完全正确,问题出在下面一层。
- RAID 阵列降级或重建中

:单盘掉线后阵列进入 degraded 状态,读性能骤降,超时后虚拟机磁盘判定为不可用。
- iSCSI / FC 会话断开:多路径软件(如 multipath、PowerPath)切换失败,LUN 短暂消失。
- NFS / vSAN 共享存储超时:网络抖动或后端节点故障,datastore 变成不可访问状态。
- LUN 重新映射:存储管理员重新划分 LUN 后,NAA 标识变化,原来指向的磁盘路径失效。
行业共识认为,虚拟化环境里超过半数的”磁盘故障”最终定位到存储链路而非磁盘介质本身。
分区表与引导记录被破坏
- MBR 前 446 字节被覆盖,或 GPT 头校验失败。
- GRUB / bootloader 文件被误删,常见于手工清理
/boot空间的场景。 - 文件系统元数据损坏,
fsck未完成就重启。 - 精简置备磁盘膨胀超出 datastore 剩余空间,写入静默失败。
权限与安全策略拦截
在 Linux 宿主机上,KVM 进程以 qemu 用户运行,如果磁盘文件属主或 SELinux 上下文被改错,QEMU 打不开文件,表现就是找不到磁盘,SELinux 的 virt_image_t 标签缺失是典型场景。
虚拟机开机提示drive error怎么解决:分平台实操
排查顺序建议从”日志 → 配置 → 磁盘一致性 → 存储层”自外向内推进,不要一上来就修引导。
第一步:锁定日志证据
VMware ESXi:
tail -100 /var/log/vmkernel.log | grep -i -E "scsi|error|dead"
tail -100 /var/log/hostd.log | grep -i "powered on"
vmkfstools -x check /vmfs/volumes/datastore1/vm/vm.vmdk
KVM / QEMU:
qemu-img info /var/lib/libvirt/images/vm.qcow2
qemu-img check -r all /var/lib/libvirt/images/vm.qcow2
virsh dumpxml vmname | grep -A5 disk
journalctl -u libvirtd --since "1 hour ago"
Hyper-V(PowerShell):
Get-VM | Get-VMHardDiskDrive
Get-WinEvent -LogName System -MaxEvents 200 | Where-Object {$_.ProviderName -like "vhd"}
第二步:核对虚拟机配置
重点确认四件事:控制器类型是否与系统驱动匹配、磁盘是否真的挂上了、引导顺序里磁盘是否在网卡之前、固件模式是否与分区表一致,这一步能解决相当一部分”假故障”。
第三步:检查快照与磁盘链
VMware 下用 vmkfstools -q disk.vmdk 查看链式关系,KVM 下用 qemu-img info --backing-chain,如果父盘丢失,优先从备份恢复父盘,而不是强行合并。
第四步:修复引导而不动数据
能挂载就说明数据还在,此时用救援 ISO 启动虚拟机,把虚拟磁盘挂到另一台正常虚拟机上:
fdisk -l /dev/sdb
mount /dev/sdb2 /mnt
mount --bind /dev /mnt/dev
chroot /mnt
grub-install /dev/sdb
update-grub
Windows 系统则在恢复环境执行 bootrec /fixmbr、bootrec /rebuildbcd。
第五步:排查宿主机存储层
cat /proc/mdstat
multipath -ll
iscsiadm -m session
dmesg -T | grep -i -E "i/o error|reset|timeout"
smartctl -a /dev/sdX
dmesg 里成片出现 I/O error 或 link reset,问题基本可以确定在存储链路,此时继续折腾虚拟机内部是无效的。
虚拟机drive error和磁盘坏道有什么区别
这两者经常被混为一谈,处理方式却完全不同。
| 对比维度 | drive error | 磁盘坏道 |
|---|---|---|
| 现象本质 | 找不到盘、认不出盘 | 能认盘,但扇区读不出 |
| 典型报错 | Boot failed、no bootable device | UNC error、I/O error、CRC 校验失败 |
| 数据可读性 | 通常完好,盘能挂载 | 局部不可读,可能逐步扩散 |
| 首要动作 | 查配置、查链路、查链式快照 | 立即备份、隔离坏盘 |
| 恢复难度 | 多数可无损修复 | 依赖备份,严重时需专业恢复 |
业内专家指出,把 drive error 当成坏道处理,往往会触发不必要的重建或格式化,反而扩大损失。
云服务器与本地机房的差异排查场景
在公有云上,虚拟机出现 drive error 的原因分布和自建环境不一样。
- 云上更常见:云盘挂载点丢失、实例热迁移中断、快照回滚未完成、系统盘与数据盘 ID 变更。
- 自建更常见:RAID 降级、HBA 驱动异常、iSCSI 会话中断、datastore 空间耗尽。
云上的排查优先级应该是:先看控制台的云盘状态和实例事件记录,再进系统看 dmesg,如果云盘显示”挂载中”但系统里看不到设备,多半是平台侧问题,直接提工单比自行修复更快,自建环境则相反,先查阵列与多路径。
预防比修复更省钱
虚拟机 drive error 一旦发生在生产环境,业务中断的代价远高于预防成本,公开资料显示,配置完善的监控体系可以把这类故障的平均发现时间压缩到分钟级。
- 给 datastore 设置容量告警,保留不低于 20% 的剩余空间。
- 快照生命周期不超过 72 小时,禁止长期挂载快照运行生产业务。
- 虚拟磁盘统一使用厚置备或预留空间,避免精简置备膨胀触发写入失败。
- 存储链路做多路径冗余,定期演练单路径故障切换。
- 虚拟机配置变更前导出 OVF 或记录 XML,便于快速回滚比对。
- 备份策略遵循 3-2-1 原则,并定期做恢复演练,而不是只看备份任务是否成功。
关于虚拟机drive error的常见问题
虚拟机出现drive error会不会导致数据丢失?
绝大多数情况下不会,drive error 属于”路径级”故障,虚拟磁盘数据文件通常完好,只要不执行初始化、不重建阵列、不覆盖分区表,数据基本都能通过挂载方式读出来,真正危险的动作是在没备份的前提下反复尝试修复引导。
云服务器上的虚拟机出现drive error,怎么判断是平台问题还是自己配置问题?
看三个信号:控制台云盘状态是否正常、实例是否有过迁移或重启事件、系统日志里是否有设备识别记录,如果云盘状态正常但系统完全看不到设备,且自己近期没改过分区或 fstab,基本可以判定为平台侧问题,提交工单时附上 dmesg 输出和实例 ID,处理效率会高很多。
虚拟机drive error修复后反复出现,根本原因在哪里?
反复出现说明有一个未被消除的触发条件,常见的是三类:存储后端存在间歇性超时(阵列电池老化、交换机端口 CRC 错误)、快照链长期未合并导致描述符脆弱、以及虚拟机配置被自动化平台周期性覆盖,这时应该做的是抓取一段时间窗内的完整日志做趋势分析,而不是每次故障后单独修复。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/752038.html