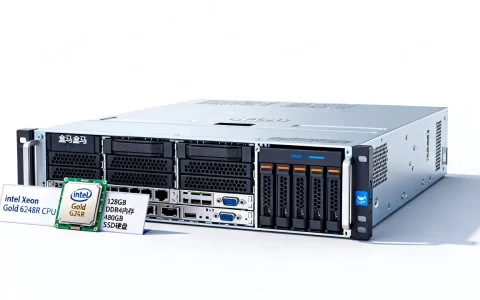
超能聚合服务器目前市场上主流的品牌和产品线主要来自英伟达认证的整机厂商、国产算力龙头以及云服务商的自研硬件,覆盖英伟达HGX整机、华为昇腾集群、寒武纪训练整机三大阵营,其中宁畅、浪潮信息、新华三、超聚变、宝德是最常被提及的五个名字。
很多朋友一听“超能聚合服务器”这个说法觉得陌生,它其实就是在AI大模型训练、智算中心、高性能计算里最吃香的那类GPU服务器,名字叫法多,但内核一致:把多张高性能加速卡插进一台机器,通过高速互联拓扑让算力聚合在一起,2026年这个节点上,谁家卖得最好、哪款适合你的预算,下面从品牌、芯片、选型三个角度说清楚。

超能聚合服务器有哪些品牌值得看
英伟达GPU阵营的整机主力
英伟达自己不做整机服务器,但市面上能叫出名字的AI服务器厂商,绝大多数都在围着英伟达的HGX平台做文章。
- 宁畅:近两年在AI服务器市场窜得特别快,X640、X660系列在互联网大厂和智算中心里出镜率极高,它家的优势是散热和功耗调校很到位,尤其适合机房机柜功率紧张的场景,如果你问超能聚合服务器哪家性价比高,圈子里不少人会先提宁畅。
- 浪潮信息:全球AI服务器出货量前两名,NF5688系列在金融、科研机构里是老面孔了,整机可靠性做得好,售后响应是传统强项。
- 新华三:背靠紫光集团,R5300 G6系列在运营商集采里中标量很大,如果你有国产化或者信创方面的硬性要求,新华三的H3C UniServer系列是绕不开的选项。
- 超聚变:原华为x86服务器业务独立出来的公司,FusionServer系列技术底子厚,底层固件优化能力在国产厂商里是第一梯队。
国产算力芯片阵营的实用推荐
2026年的市场格局里,国产芯片早就不只是“备胎”角色了,华为昇腾、寒武纪、海光信息的服务器已经大量跑在真实业务里。
- 华为昇腾:Atlas 800训练服务器用的是昇腾910B/910C芯片,云厂商里华为云自己的昇腾集群规模最大,对于政府项目、国企私有化部署,昇腾是目前超能聚合服务器有哪些国产型号这个搜索词下最常被提到的答案。
- 寒武纪:思元590芯片配套的训练整机,在部分省级智算中心有批量落地,偏科深度学习推理场景,性价比突出。
- 宝德:老牌国产服务器厂商,既做英伟达方案也做昇腾方案,产品线很杂但胜在便宜,中小型实验室预算不够时经常优先看宝德。
| 品牌 | 主流系列 | 核心加速卡 | 典型场景 |
|---|---|---|---|
| 宁畅 | X640 / X660 | 英伟达H800 / 4090 | 大模型训练、互联网推荐 |
| 浪潮信息 | NF5688 | 英伟达H800 | 智算中心、科研超算 |
| 新华三 | R5300 G6 | 英伟达L40S | 运营商、政企私有化 |
| 超聚变 | FusionServer | 英伟达H800 / 昇腾910B | 原华为生态客户 |
| 华为 | Atlas 800 | 昇腾910B | 信创、政务云 |
| 寒武纪 | MLU590 | 思元590 | 视觉推理、小模型微调 |
| 宝德 | PR4908P | 多种可选 | 高校实验室、初创团队 |
超能聚合服务器和普通机架式服务器的区别
这问题几乎每个采购朋友都会问,一句话:普通机架式服务器是4个人各干各的,超能聚合服务器是8个人围一张桌子搞头脑风暴,中间还得有条高速通道传纸条。
具体差异集中在三个地方。
加速卡数量与互联拓扑
普通2U机架式服务器最多插两到四张GPU,但AI训练需要的显存带宽和通信效率完全不是一个量级。
超能聚合服务器一般以8卡配置为主流,通过NVLink或NVSwitch实现GPU间600GB/s级别的直连带宽,这个数字意味着什么?一张H800显存是80GB,八张卡就是640GB的显存池,跑百亿级参数模型不用做太复杂的模型并行切分。
散热形态决定了机房改造成本
市面上的8卡服务器分风冷和液冷两种。
- 风冷:宁畅X660、浪潮NF5688都是典型的2U/4U风冷机型,部署简单,机柜深度要求1.0米以上,但高负载时噪音能到75分贝以上,放在办公室隔壁基本不用睡觉。
- 液冷:新华三和超聚变都有冷板式液冷方案,散热效率比风冷高40%左右,但需要机房有CDU和冷量分配单元,如果你在咨询超能聚合服务器多少钱一台时发现报价差了一倍,大概率就是风冷和液冷的区别。
管理运维层面

普通服务器做运维是看CPU温度、内存错误日志,超能聚合服务器要额外看GPU利用率、显存带宽、NVLink链路健康状态、功耗墙是否触发,英伟达的DCGM工具搭配Prometheus+Grafana是目前最通用的监控组合,建议采购时直接问厂商要配套的监控模板,别自己从零搭。
怎么判断你需要的聚合规格
按模型规模对号入座
大模型训练的显存需求有简单公式:模型参数(B)× 2KB × 优化器系数 > 总显存,按业内培训讲师的说法,一条实际部署经验是:70B参数模型用FP16混合精度训练,最少需要4台8×H800的节点组成集群,也就是32张卡起步,单机8卡只能跑7B-13B规模的模型微调。
选型决策的具体步骤
- 第一步:明确任务类型,纯训练买H系列,推理部署买L40S或4090反而更划算。
- 第二步:确认机房电力,单台8卡H800整机功耗在6千瓦到10千瓦之间,机柜要是只有4千瓦的富余容量,得先扩容再下单。
- 第三步:算一下网卡成本,多机互联需要配InfiniBand或RoCE网卡,这部分成本约占总预算的15%-20%,很多人只盯着GPU价格忽略了它。
- 第四步:看售后服务条款里是否包含故障GPU的闪备服务,业内专家指出,GPU长期跑训练,故障率比CPU高一个数量级,厂商要是不能提供4小时内的备用卡替换,业务中断会很难受。
中小企业更划算的替代方案
如果你的业务场景是跑Stable Diffusion、图生图、中小模型微调,买一台搭载8×RTX 4090的深度学习工作站就够了,价格比买8×H800的服务器要便宜得多,2026年市场行情中,一台4090工作站整机价格在十几万区间,而H800整机动辄百万以上,智算中心资源过剩的背景下,租一台8卡A800机器跑训练的费用大约每小时一百元以内,按需用比自己养划算。
这种配置组合在电商平台搜“超能聚合服务器出租”能找到一大堆第三方服务商,但注意筛选有数据中心资质和真实物理机跑分的店铺,避免买到云主机冒充的机器。
超能聚合服务器购买渠道与部署注意点
渠道怎么选
- 品牌官网直销:宁畅、浪潮官网都有专门的AI服务器产品线,报价单直接发给你,无需走经销商。
- 简米云/酷番云官方硬件店铺:云厂商自营的物理机出租业务,适合先做几周PoC测试再决定是否采购。
- 二手市场:闲鱼上确实有大量下线的V100、A100整机,价格便宜到骨折,但没有质保、没有原厂技术支持,非技术团队别碰。

通电部署的三天必修课
拿到机器后别急着跑训练,按下面顺序做一次验收。
- 用
nvidia-smi查看八张卡的驱动状态,确认所有卡均显示“No running processes”且显存识别正常。 - 跑一遍
nvidia-smi topo -m查看GPU间的拓扑结构,理想情况是八张卡都在同一个NVSwitch域下,两两之间的通信不经过PCIe Switch。 - 用
HPL或者gpt-2级别的微型训练脚本做一小时的压测,观察有没有卡的温度或功耗明显偏离平均值。 - 检查固件版本是否与驱动匹配,这个配不对,高速互联性能会直接掉到PCIe模式,八卡通信效率降到NVLink的二十分之一。
这套流程跑完基本能确定你拿到的是不是一台合格的超能聚合服务器,2026年了,算力采购本质上是个技术决策,别只看纸面参数,把功耗、散热、网络这三件事放到和GPU同样重要的位置,其他东西都是水到渠成的小问题。
超能聚合服务器选型常见问题
超能聚合服务器用什么操作系统?
绝大多数AI训练平台跑的是Ubuntu 20.04或22.04 LTS Server版,配合Docker和NVIDIA Container Toolkit使用,政务和国企项目会要求麒麟V10或者统信UOS,华为昇腾方案只支持自家配套的CANN工具链,买之前把操作系统兼容性问题问清楚。
一台超能聚合服务器能跑千亿参数大模型吗?
单机8卡跑不了千亿参数,满血千亿模型需要的是一个智算集群,通常少则几十台、多则几百台服务器通过高速网络组成超级节点,单机只是集群里的一颗螺丝钉,你想在单台服务器上体验千亿参数,只能做量化推理,也就是用FP8或者INT4精度把模型压到显存能装下的程度,但推理速度会打不少折扣。
超能聚合服务器和AI服务器的叫法有什么区别?
行业共识是这两个词在一个语境下指同一个东西,超能聚合是媒体和厂商宣传时偏向的说法,突出“算力聚合”的概念,AI服务器则是技术圈子的标准叫法,采购招投标文件里一般用“GPU服务器”或者“AI训练服务器”作为正式名称,你搜超能聚合找到的产品,在参数表上跟AI服务器完全一致。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/753089.html