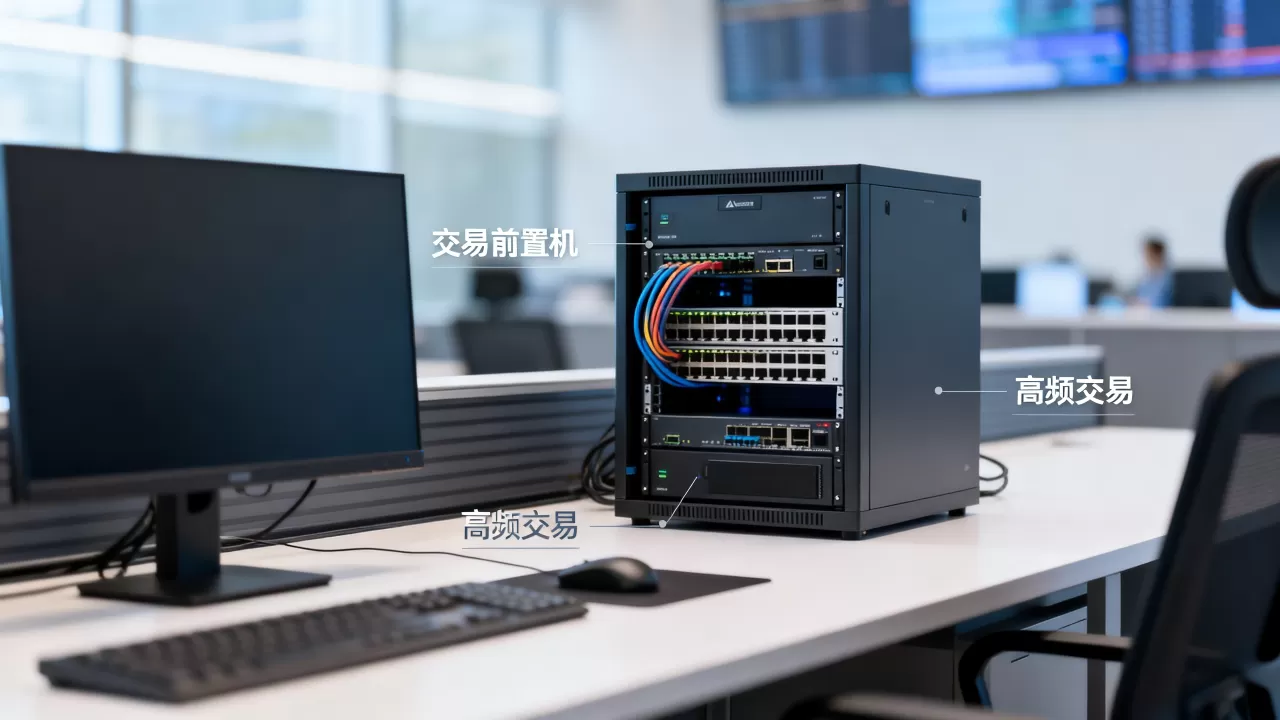
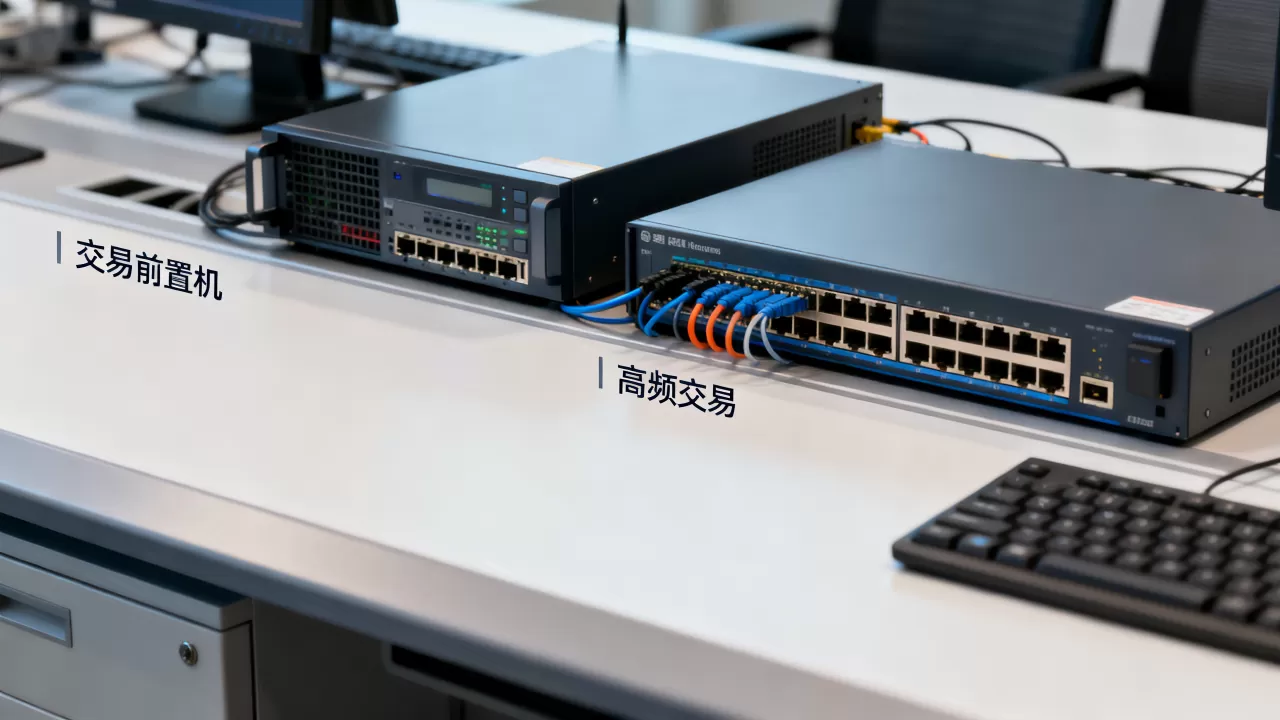
高频交易对交易前置机资源独占的偏好,核心是用硬件隔离换取延迟确定性独占CPU核、独占内存通道、独占网卡队列,让每笔报单的路径时延可预测,而不是在共享资源池里碰运气。
高频交易拼的不是方向,是排队顺序,报单早到一微秒,成交概率就大不一样,前置机是连接策略服务器和交易所撮合主机的最后一跳,这一跳要是被别的策略挤了,再好的模型也白搭。

高频交易前置机独占资源有哪些优势?
共享前置机上,多个策略共用CPU核心、内存带宽和网卡队列,操作系统调度器会在不同进程间切换,缓存被反复冲刷,高频策略需要的是稳定在个位数微秒的往返时延,抖动一大,止损触发和撤单逻辑就会失准。
延迟确定性与抖动控制
独占资源后,你可以把策略进程绑定到隔离的物理核上,关闭该核上的时钟中断和RCU回调,让指令流水线不再被打断,业内专家指出,高频交易系统的性能瓶颈往往不在算法本身,而在操作系统和网络栈的尾延迟,尾延迟就是那百分之一的最差情况,共享环境里尾延迟可能翻好几倍。
网络路径与协议栈优化
独占前置机意味着你可以独占网卡队列,甚至用DPDK或Solarflare Onload绕过内核协议栈,共享环境下,你没法随意改队列亲和性,因为会影响别人,独占时,你可以把每个RX队列绑定到固定的CPU核,让中断和轮询各就各位,具体命令比如:
ethtool -L eth0 combined 8设置多队列echo 8 > /sys/class/net/eth0/queues/rx-0/rps_cpus配置RPSirqbalance --banirq=...禁止irqbalance干扰
这些操作在共享前置机上基本不可能,机房管理员不会让你动全局配置。
资源隔离带来的策略容量提升
独占一台前置机,你可以跑多个策略实例,但每个实例的CPU核、内存池、网卡队列都是预先切分好的,这样策略之间互不干扰,共享前置机则像合租房,邻居炒菜你闻油烟,高频交易对资源独占的偏好,不是追求绝对速度快,而是追求可重复、可回测的延迟表现,如果今天的延迟是5微秒,明天变成20微秒,策略的回测曲线就失去意义。
共享前置机与独占前置机对比:高频交易用共享还是独占?
这是一个高频交易者经常纠结的问题,我们用表格对比一下。
| 对比维度 | 共享前置机 | 独占前置机 |
|---|---|---|
| CPU调度 | 多策略争抢,上下文切换频繁 | 物理核隔离,无争抢 |
| 内存带宽 | 共享,易受邻居影响 | 独占NUMA节点,带宽稳定 |
| 网卡队列 | 多用户共用,中断可能汇聚 | 队列绑定,可做内核旁路 |
| 延迟抖动 | 较大,尾延迟不可控 | 较小,尾延迟可预测 |
| 成本 | 相对低,按月分摊 | 较高,需整机或整柜租赁 |
| 适用策略 | 中低频、对延迟不敏感 | 高频做市、套利、抢单 |
什么场景下必须选择独占
- 策略持仓周期在毫秒级以下,比如做市商挂单撤单
- 需要精确控制报单时间戳,依赖硬件时间戳
- 使用FPGA或内核旁路,要求独占网卡和PCIe带宽
- 多策略并行,且策略间不能互相干扰
什么场景下共享可以接受
- 日内趋势策略,持仓几分钟到几小时
- 对延迟要求在百微秒以上
- 初期资金规模小,成本敏感
- 策略逻辑简单,不依赖极低抖动
行业共识认为,当策略夏普比率对执行延迟的敏感度超过一定阈值时,共享前置机省下的钱远不如延迟抖动造成的滑点损失。
上海地区高频交易前置机托管价格与资源独占方案
上海是期货和证券高频交易的核心城市,靠近上期所、中金所、郑商所等,托管在交易所机房附近的前置机,物理距离每缩短一公里,光纤传输时延大约减少5微秒,所以上海地区的高频交易者特别看重前置机位置。
影响托管价格的关键因素
- 机房等级:T4级机房比T3级贵不少,但电力冗余和网络稳定性更好
- 机柜功率:高频交易服务器功耗高,独占资源往往需要整机柜,功率密度影响价格
- 网络接入:交易所直连线路、低延迟专线、多路由冗余都会推高成本
- 资源独占程度:整机独占比按核独占贵,但隔离更彻底
- 运维服务:是否提供带外管理、硬件更换、系统调优支持
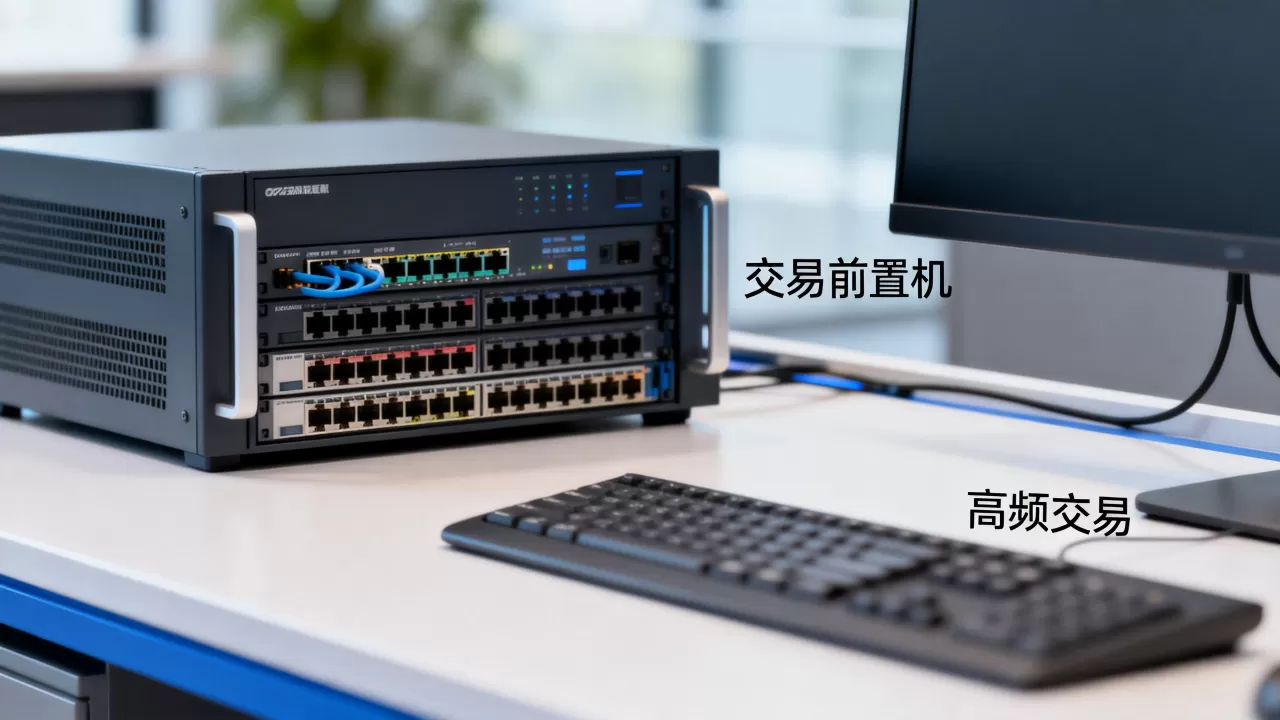
近年来,上海地区高频交易前置机托管价格因机房位置和资源独占方式差异较大,整柜独占的年费在数十万元级别,按U位共享则低很多,但共享方案对高频策略并不友好,如果你要做资源独占,建议直接租用整台物理服务器,并和机房确认以下参数:
- 是否允许修改BIOS设置,关闭C-state和P-state
- 是否允许加载自定义内核模块,比如DPDK
- 是否提供独立的带外管理网络
- 上行链路是否独占端口,而非共享上联
高频交易前置机资源独占怎么配置?实操路径
假设你拿到了一台独占的物理服务器,运行Linux,怎么把资源独占做到位?下面是一套可验证的步骤。
第一步:BIOS与内核启动参数
- 关闭超线程(Hyper-Threading),避免逻辑核争抢物理核资源
- 关闭C-state和P-state,让CPU始终跑在最高频率
- 内核启动参数加入:
isolcpus=2-15隔离出策略专用核nohz_full=2-15让隔离核减少时钟中断rcu_nocbs=2-15把RCU回调移出隔离核default_hugepagesz=1G hugepagesz=1G hugepages=8预留大页内存
第二步:NUMA绑定与内存分配
- 用
numactl --hardware查看NUMA节点 - 用
numactl --cpunodebind=0 --membind=0 ./strategy把进程绑定到同一NUMA节点 - 关闭自动NUMA平衡:
echo 0 > /proc/sys/kernel/numa_balancing - 为策略预分配大页内存,避免运行时缺页中断
第三步:网卡队列与中断亲和性
- 用
ethtool -L eth0 combined 8设置8个队列 - 查看中断号:
grep eth0 /proc/interrupts - 将每个队列的中断绑定到隔离核之外的核,或者用轮询模式
- 关闭irqbalance:
systemctl stop irqbalance && systemctl disable irqbalance - 如果使用DPDK,通过
--lcores和--socket-mem指定核与内存
第四步:内核旁路与协议栈调优
- 安装DPDK或Solarflare Onload
- 配置巨页:
echo 8 > /sys/kernel/mm/hugepages/hugepages-1048576kB/nr_hugepages - 调整TCP参数:
sysctl -w net.ipv4.tcp_low_latency=1,sysctl -w net.core.busy_poll=50 - 关闭透明大页:
echo never > /sys/kernel/mm/transparent_hugepage/enabled
这些操作的核心逻辑是:把策略进程、内存、网卡队列、中断都固定在一组物理核和NUMA节点上,让它们不和其他进程抢资源,共享前置机上,你没法做这些,因为动了全局配置会影响别人。
Q&A:高频交易前置机资源独占常见问题
高频交易为什么不能接受共享前置机的CPU争抢?
共享前置机上,多个策略进程在同一个CPU核上分时运行,Linux调度器的时间片切换会带来上下文切换开销,每次切换可能消耗几微秒,高频做市策略每天报撤单成千上万次,每次多几微秒,累积起来就是可观的滑点,而且共享环境的负载不可预测,邻居策略突然放量,你的延迟就会飙升。
独占前置机是否意味着完全不用共享网络?
不是,独占前置机通常只保证服务器内部的CPU、内存、网卡队列独占,但交换机端口、上行链路、交易所网关仍然是共享的,你可以通过独占交换机端口、使用独立光纤、配置多路由来减少网络层的争抢,有些托管商会提供“独享上联”选项,价格更高,但能进一步降低抖动。
高频交易前置机资源独占的成本是否值得?
这取决于策略的延迟敏感度,如果策略的收益主要来自微秒级抢先,独占资源的成本很容易被滑点减少所覆盖,如果策略持仓周期较长,共享前置机省下的托管费可能更划算,一个简单的判断方法:做回测时,把执行延迟人为增加50微秒,看夏普比率下降多少,如果下降明显,就值得为独占付费,资源独占的偏好本质上是高频交易者对确定性的付费。
高频交易对交易前置机资源独占的偏好,不是追求硬件堆砌,而是用隔离换确定性,在微秒必争的赛道上,可预测的延迟比偶尔的快更重要,把CPU、内存、网卡队列都固定下来,策略的回测才能和实盘对得上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/757468.html