人脑阵列服务器目前没有大规模商用产品,主流形态集中在科研原型机与专用神经形态计算设备两大类,具体代表包括中科院计算所的达尔文系列、清华的天机芯片平台,以及Intel Loihi、IBM TrueNorth等海外方案;选购时必须先搞清楚“仿脑芯片”和“服务器整机”的边界。
人脑阵列服务器有哪些品牌?主流机型全盘点
海外阵营:Intel与IBM是绕不开的起点
Intel的Loihi系列是业内讨论度最高的神经形态计算芯片,自2018年推出Loihi 1以来,Intel在2021年发布了Loihi 2,并以此搭建了Pohoiki Springs系统,那是一台标准机架式设备,内部集成了多颗Loihi芯片,专门用于模拟脉冲神经网络。它最突出的特征是低功耗,在处理某些稀疏编码任务时,功耗比传统GPU低数个量级。

IBM的TrueNorth则是另一个里程碑,2014年IBM公布这颗芯片时,内置了4096个神经核,可模拟100万个神经元和2.56亿个突触,基于TrueNorth构建的服务器原型机主要用于图像识别和听觉感知实验,但IBM后续没有推出大规模商用阵列服务器,更多是向科研机构提供开发板卡。
英国曼彻斯特大学的SpiNNaker系统也值得关注,这是一台由100万颗ARM处理器组成的超大规模脉冲神经网络模拟器,物理体积相当大,目前部署在曼彻斯特大学,并不对外零售,欧洲人脑计划(Human Brain Project)的多项仿真实验都跑在这套系统上。
国内阵营:科研院所与创业公司并进
国内人脑阵列服务器的声量,主要来自两类力量。
第一类是顶尖科研机构。中科院计算所的达尔文系列芯片已经迭代了多个版本,2019年发布的达尔文2代集成了更多神经核,并配套了完整的软件工具链,清华大学的天机芯片(Tianjic)则在2019年登上国际顶刊封面,它把脉冲神经网络和人工神经网络融合在同一个架构里,配套的服务器平台支持FPGA加速卡插接,属于典型的科研定制硬件。
第二类是商业创业公司,目前公开信息较多的包括灵汐科技、时识科技(SynSense)和脑虎科技等,灵汐科技的类脑芯片已迭代至第二代,主要面向边缘计算场景;时识科技主打低功耗视觉和音频处理方案,有成熟的评估板卡在售,这些公司多数提供的是芯片模组或单板计算机,而非标准意义上的“阵列服务器整机”。
选购前的认知:原型多、量产少
行业共识认为,全球人脑阵列服务器市场仍处在原型验证阶段,截至近两年,没有哪家厂商公开宣布过“万人脑阵列服务器量产交付”,如果你在企业采购系统里搜索“人脑阵列服务器”,大概率找不到现成的SKU(库存单位),更多情况下,厂商会按你的具体需求定制:芯片数量、存储结构、散热方式、配套驱动,全部单独谈。把“人脑阵列服务器”理解成一套定制化科研设备,比理解成普通服务器更准确。
人脑阵列服务器和传统服务器有什么区别
计算方式:脉冲驱动VS矩阵乘法
传统GPU服务器靠的是冯·诺依曼架构,数据在内存和计算单元之间来回搬运,用矩阵乘法完成神经网络推理,人脑阵列服务器则完全不同,它模拟的是生物神经元的脉冲发放机制信息以离散的“尖峰”形式在神经元之间传递,只有某个神经元的电位累积到阈值时,它才“放电”一次。
这个差异带来一个直接结果:在人脑阵列服务器上跑传统的深度学习框架(比如PyTorch、TensorFlow)并不顺畅,甚至可以说“英雄无用武之地”,你需要把模型转写成脉冲神经网络(SNN)格式,再用厂商提供的SDK做映射。软件生态的成熟度,是制约其普及的最大瓶颈。
能效比:特定任务下优势巨大
业内专家指出,在稀疏事件驱动型任务上,人脑阵列服务器的能效比是传统服务器的数十倍甚至更高,一块监控摄像头画面持续传入GPU服务器,GPU每一帧都在做全量矩阵运算;而人脑阵列服务器只在画面变化时产生脉冲,静止画面几乎不耗电。
但你也要清醒:在密集的、需要高吞吐的任务上,人脑阵列服务器并没有优势,它擅长的是低带宽、高稀疏、事件驱动的场景,而不是“大力出奇迹”的稠密计算。
部署方式:从机箱到集群都有
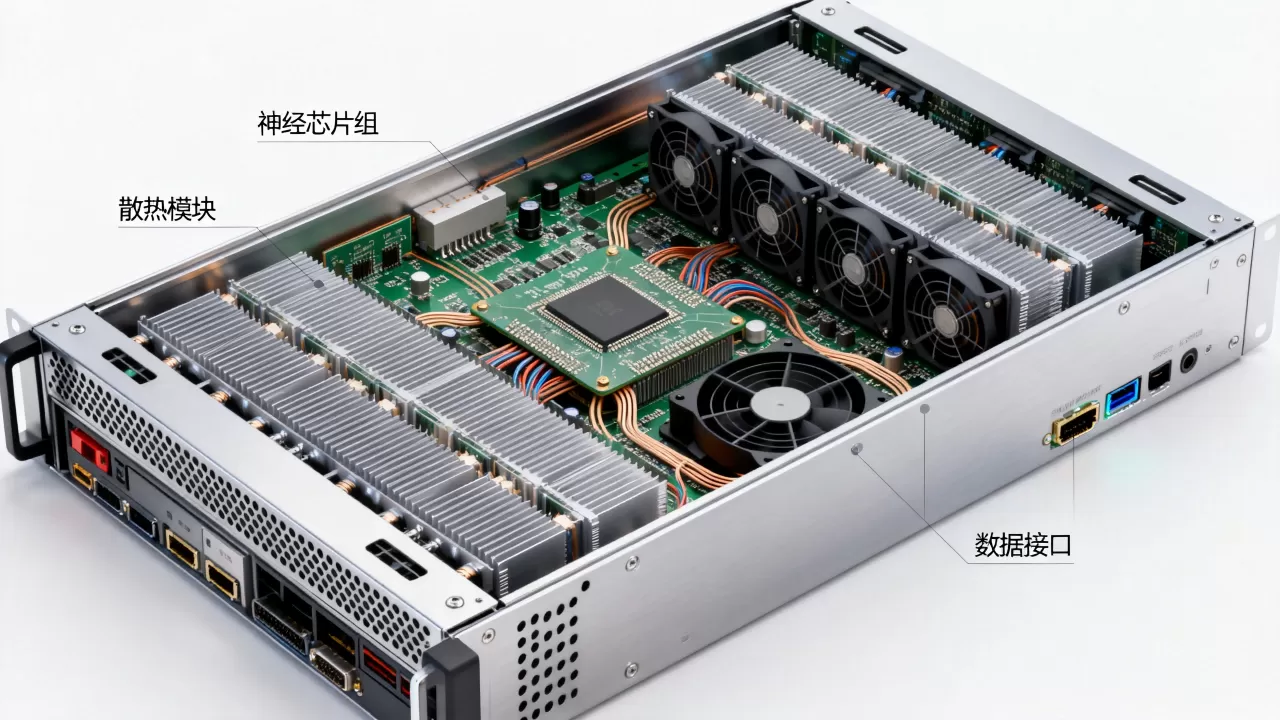
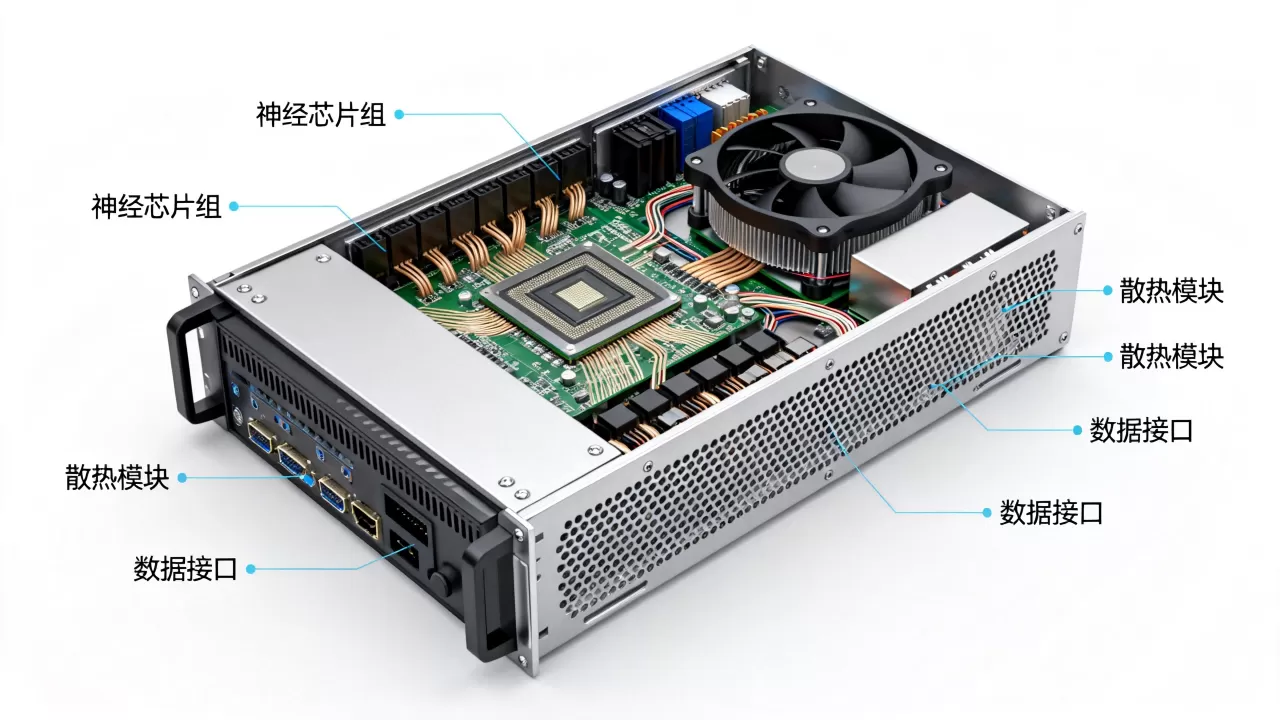
人脑阵列服务器的物理形态跨度很大,小到一张PCIe加速卡(插进普通工作站就能跑),大到一台独立机柜(内含几十块类脑板卡,通过高速总线互联),如果你在实验室看到一台“移动工作站外形”的类脑设备,那通常是开发套件;如果是机架式设备,那才是真正意义上的“阵列”。
人脑阵列服务器多少钱一套
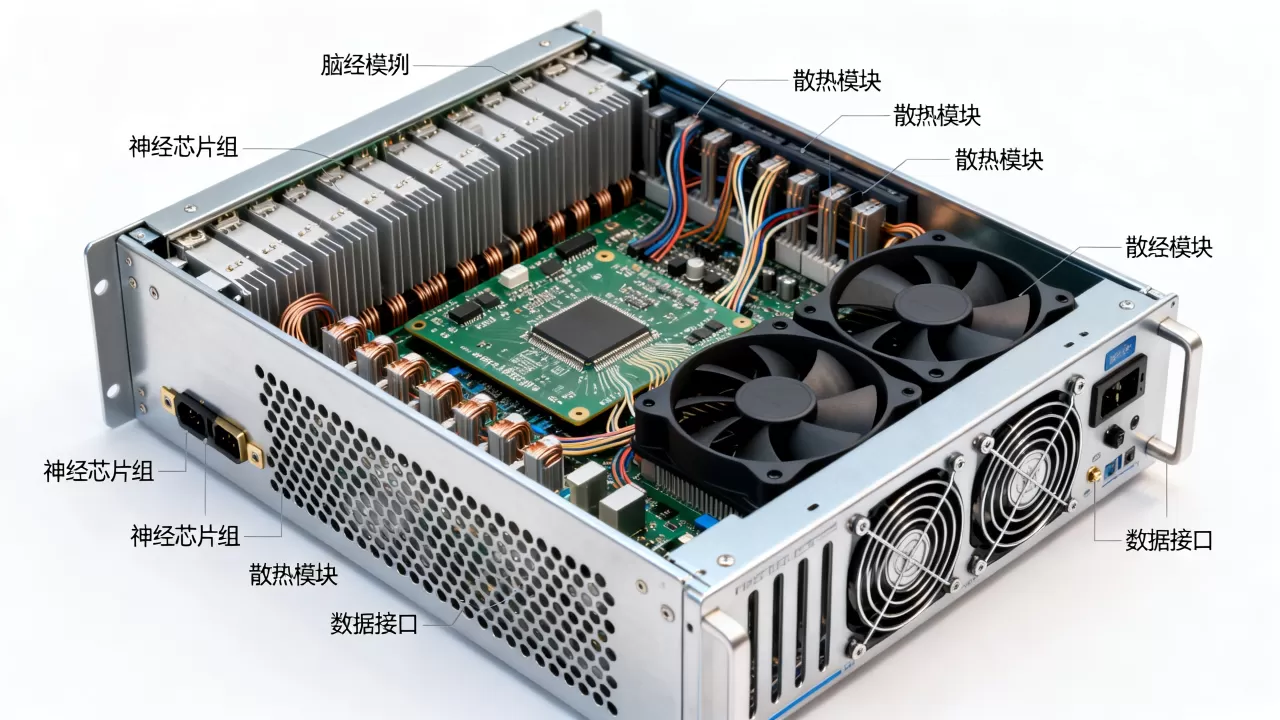
价格没有公开的“标准报价单”,因为几乎都是定制合同,从公开渠道的采购信息和招投标公告来看,大致可以分三个档位:
- 开发套件级:单块类脑芯片的评估板,售价在万元到十万元区间,适合高校实验室做算法验证。
- 科研定制级:集成了数十颗类脑芯片的服务器整机,配合软件环境部署,通常报价在百万元级别。
- 集群级:用于模拟亿级神经元规模的系统,比如SpiNNaker这类,造价达到千万元甚至更高。
影响报价的因素主要有四个:第一,芯片型号和颗数,这是成本大头;第二,互联架构,芯片之间的通信拓扑直接影响性能,复杂拓扑的布线成本和调试成本都很高;第三,配套软件栈,厂商会根据你的模型需求做适配,这部分人力费用往往超过硬件本身;第四,售后维护,由于不是成熟产品线,工程师驻场服务的成本也会体现在合同里。
如果你只是“想试试”,建议先买开发板;如果是为了申报科研项目,就直接按“整机定制”做预算。
人脑阵列服务器适合什么场景
科研仿真:从大脑建模到类脑算法
绝大多数现有人脑阵列服务器都待在高校和研究所里,中科院、清华、北大等机构利用它们做脉冲神经网络训练机制研究、生物神经回路仿真、类脑强化学习等课题,这类场景对功耗不敏感,但对“逼近生物真实度”有极高要求,传统GPU服务器无法胜任。
边缘端低功耗识别:语音、振动与视觉事件
目前比较有落地苗头的方向是边缘智能,在工业设备上部署一台小型人脑阵列服务器,持续监听轴承振动信号,传统方案需要24小时开机采算,而类脑方案在设备运转正常时几乎“休眠”,只有异常振动触发脉冲时才会激活计算,据相关行业信息,这类应用在电力状态监测、矿井安全预警等场景已有试点案例。
机器人实时决策:摆脱云端依赖
机器人如果依赖云端GPU做推理,通信延迟和环境断网都是风险,人脑阵列服务器因为低功耗、低延迟,可以直接嵌入机器人本体,实现实时的脉冲神经网络控制,目前有较大比例的国内高校机器人实验室,在为四足机器人、无人机集群采购小规模类脑计算模组。
不合适的场景:大模型训练与通用云计算
必须明确划出边界:如果你想训练一个千亿参数的大语言模型,请老老实实买NVIDIA的加速卡,人脑阵列服务器的编程模型、存储带宽和并行规模,目前完全不适合通用大模型训练,它不是一个“替代品”,而是一个“互补品”。
最后说一个现实问题
如果你真正关注人脑阵列服务器,最值得追踪的信号不是某家公司的宣传稿,而是有没有高校或企业公开中标公告,在各省的政府采购网搜索“类脑计算服务器”“神经形态计算平台”,能直观看到实际成交型号和价格带。真实需求从来都是等出来的,而不是听出来的,在2026年这个时间窗口,人脑阵列服务器依然是一个“向科研倾斜”的窄众市场,但它代表的计算范式,比GPU更接近未来智能硬件的底层逻辑。
如果你预算有限,可以从国产单卡方案入手;如果预算充足且目标明确,直接找厂商谈整机定制;如果只是关注趋势,重点观察国家级实验室的采购清单即可。
Q&A:关于人脑阵列服务器的三个高频疑问
人脑阵列服务器是哪家公司生产的?
没有唯一答案,海外看Intel和IBM,国内看中科院计算所、清华大学以及灵汐科技、时识科技等企业,不同厂商的芯片架构和软件接口完全不同,不存在“通用兼容”的人脑阵列服务器,采购前先确认自己团队的算法是基于哪个芯片生态开发的。
买一台人脑阵列服务器能跑现有的Python代码吗?
部分能跑,但效率不高,厂商通常在服务器里预装Linux系统和Python接口,你可以用Python调用脉冲神经网络模拟器,但无法直接运行标准的深度学习训练脚本,多数情况下,你需要重写模型结构,把CNN或Transformer转换成SNN表示。
人脑阵列服务器的使用寿命和维护成本怎么样?
这类设备采用低功耗芯片,发热量小,硬件寿命较长,但软件维护成本高,由于依赖厂商持续更新驱动和编译工具,一旦厂商停止适配,设备可能沦为“吃灰机器”,采购时建议在合同里明确软件支持期限和源代码交付范围,不要只看硬件参数。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/757826.html