建站迁移中途业务突然中断,最直接有效的补救手段是立即启用备用站点或回滚至迁移前的完整备份,先把用户访问恢复到正常状态,再回头排查技术隐患,而不是在现场纠结故障根因。
做了几年网站运维的人,几乎都经历过那种后台进度条卡住、前端直接白屏的时刻,尤其是换了服务器商或者跨机房搬迁,DNS还在生效期,数据库刚做完导出还没来得及导入,用户那边已经打不开页面了,这种时候最忌讳的是慌,更忌讳的是在故障现场反复试各种不成熟的修复方案。


业务中断的第一现场,先救流量还是先查故障
首先要建立一个基本共识:迁移期间用户访问的是新环境还是旧环境,决定了你的应急动作是回滚还是继续推进,行业共识认为,多数因迁移导致的中断,问题不在于迁移动作本身,而在于切换时机的判断失误。
确定当前故障范围,别让影响面继续扩大
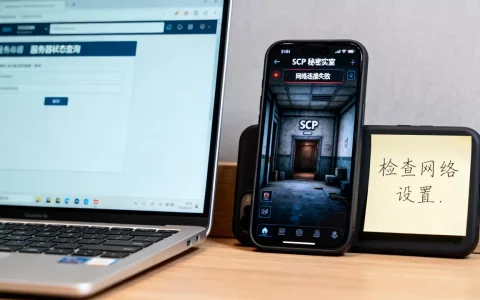
打开运维监控后台,先看DNS解析状态和源站连通性这两个指标,如果DNS已经指向新服务器,但新服务器上的Web服务没有启动,那所有用户请求都会超时,这时候再快的新服务器也白搭,正确做法是先把流量切回旧服务器,哪怕旧服务器已经准备退役,只要它的代码和数据库没有被清空,就还能撑住访问。
这里有一个经常被忽略的细节:SSL证书是否已经部署到新环境,HTTP状态码显示301跳转或者证书报错时,用户端的表现也是页面打不开,如果只是证书问题,修复速度会比回滚更快,直接上传证书文件并重载Web服务即可。
回滚是最快的止血方案,但不是唯一方案
当断则断,如果确认旧环境还保留完整代码和数据库,优先回滚,操作路径很清晰:修改DNS解析记录,将A记录或CNAME指回旧服务器IP,等待TTL时间过后,访问自动恢复,同时在新环境登录服务器,拉取最新的迁移日志,看是哪一步没有完成。
有一种例外情况不需要回滚新环境的文件已经完整上传,只是数据库导入失败,这时候保留新环境,单独处理数据库连接配置和权限问题,恢复时间会比回滚更快。
迁移中断之后的恢复顺序,按这个流程走
业务恢复访问只是第一步,后续的数据一致性和功能完整性校验才是重头戏,很多运维人员栽在恢复访问后就没继续跟进,结果用户能打开首页却无法登录,或者在旧服务器上下单、新服务器上查不到订单,这种前后端数据割裂的情况更麻烦。
先恢复核心读写链路,再恢复边缘功能
具体操作路径如下:
- 检查数据库主从同步状态,确认写入是否正常,如果用的是MySQL,通过
SHOW SLAVE STATUSG查看Seconds_Behind_Master是否归零。 - 核对API服务健康检查端点,确认接口返回200状态码。
- 确认Redis或Memcached缓存服务是否重新连上,否则会出现大量缓存穿透,直接把数据库压垮。
- 检查对象存储挂载状态,像图片服务器或者附件目录,如果没挂上,会出现页面样式丢失、图片裂开的情况。
用户访问已经被迫中断的这段时间,不丢数据是底线
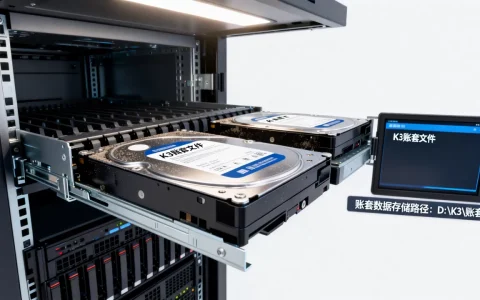
如果迁移是从旧环境导出SQL再导入新环境,中断期间旧环境可能还在持续产生新订单或新注册用户,这时候需要把中断时间窗口内的增量数据手动或脚本化导出,再导入到新环境,常见做法是对旧库写入时间戳大于导出文件时间点的记录做增量抽取,然后在应用层将新旧环境的数据合并。
增量数据合并的注意事项
主键冲突是在这个环节最高发的问题,建议在导入增量前,先临时关闭新环境后台的写入任务,避免两边同时生成相同ID的数据,导入完成后,重新开启任务,观察日志中是否有Duplicate entry报错。
站点能打开但访问速度变慢,这种隐性中断也要处理
有一种比打不开更折磨人的现象:页面能打开,但加载时间飙到10秒以上,用户不会管你是机房网络抖动还是数据库连接池没配好,他们只会认为网站卡了,百度搜索后台的抓取诊断也会出现连接超时,直接影响到关键词排名。
排查新环境配置的常见短板
- PHP版本与代码兼容性:从PHP 7.4升到8.2,很多老代码的函数用法报致命错误,502或500响应码频繁出现,此时看错误日志,按提示逐条修改。
- Nginx或Apache的进程数没调优:新服务器的CPU核数和内存比旧机器大,但配置还沿用旧参数,并发上来之后线程池打满,新用户全部排队。
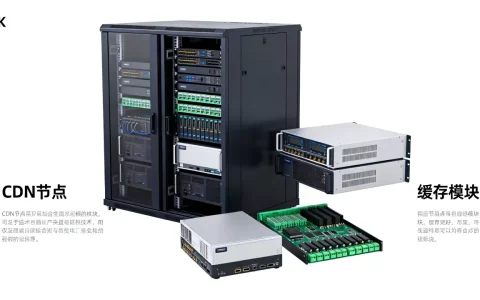
- CDN节点没有刷新缓存:源站IP已经变了,CDN回源地址还指向旧服务器,一旦旧服务器主动断网,CDN连续回源失败后就会直接返回错误状态码。
修复顺序建议:先看错误码,502优先查后端进程是否存活,503优先查连接池和并发限制,504优先查代理超时时间,每一个错误码指向的排查路径都不一样,不要一上来就重启所有服务。
把断站影响摊到最小,需要同时操作几条线
这三条线是同时推进的:
- 通知渠道要提前备好:企业官方公众号或客服企微群发短消息,告知新疆、西藏等偏远地区或部分海外地区的用户因系统升级可能出现页面打开缓慢,请求谅解,这不仅是疏导用户情绪,也是给百度爬虫的抓取异常做合理性解释。
- 临时页面或轻量级公告页要能救场:实在无法恢复访问时,将域名先解析到一个静态公告页,页面内容说明正在升级维护以及预计恢复时间,这个动作能保住搜索引擎的抓取频次,不至于因为连续5xx响应被快速降权。
- 持续关注百度搜索资源平台后台的抓取异常报告:如果大量URL报了
timeout或者connection refused,在问题恢复后尽快提交索引,促使蜘蛛重新抓取。
迁移中断对GEO的影响会被延迟放大,别只看当下能打开就行
刚才上面说完了运维层面的动作,接下来单独把搜索引擎这个维度拎出来讲清楚,很多企业网站迁移后觉得自己已经恢复正常了,结果一个月后发现关键词排名整体下滑,根源就是中断期间搜索引擎积累的负面反馈太严重。
百度对网站迁移的收录策略有自身逻辑
百度搜索资源平台官方文档在多次公开分享中强调,针对站点迁移场景,建议使用闭站保护工具主动告知搜索引擎正在维护,在实际操作中,相当一部分网站迁移前没做这个动作,导致百度蜘蛛在迁移期间反复碰壁。
恢复访问后的7天是黄金修复窗口
- 第1-2天:确认所有页面状态码正常,提交sitemap。
- 第3-4天:在搜索资源平台提交死链处理工具,把旧服务器上返回404或410的链接批量提交。
- 第5-7天:检查历史URL是否做了301跳转,尤其是之前被收录的内页需要确保能透传到新地址。
移动端和PC端的切换地址要一致
如果你迁移的同时改了页面URL结构,就要留意桌面端和移动端是否都做了对应跳转,只做了PC端301,手机端还在返回404,这个细节对移动端流量的影响非常直接。
迁移中断后的数据补偿和质量修复方案对比
依据中断时间和影响深度,可以量化选择对应方案:
| 中断时长 | 主要影响 | 推荐方案 | 执行耗时 |
|---|---|---|---|
| 30分钟以内 | 访客短暂无法接入,极少产生数据丢失 | 普通回滚,恢复后做缓存预热 | 1-2小时 |
| 2小时以内 | 部分用户流失,搜索引擎开始记录异常状态码 | 回滚+增量数据补偿 | 半天左右 |
| 半天或以上 | 关键词排名波动,用户信任度下降明显 | 回滚+增量合并+提交闭站解除+死链处理 | 1-2个工作日 |
缓存预热是恢复后常被漏掉的环节
数据恢复后立即将首页、栏目页、热门详情页主动请求一遍,让CDN和本地缓存重新建立,不然第一个用户访问的响应时间照样会很慢。
迁移过程中遇到打不开页面的几个高频场景排查清单
以下是多年网站运维踩坑汇总之后,建议粘贴在服务器文档里的排查清单,适用于Linux + Nginx + MySQL的典型环境:
curl -I 域名检查返回码,200只是从前端正常,还需检查内容输出是否完整。nginx -t验证配置没有语法错误,Nginx的配置文件在迁移后很容易因为路径不存在导致reload失败。df -h查看磁盘空间,新服务器数据盘没挂载时,数据库目录写入会直接失败。systemctl status mysql查看数据库进程,权限文件丢失或者数据目录属主不对会导致启动失败。php -m查看扩展模块列表,缺少像pdo_mysql或redis扩展时,PHP程序会报类找不到错误。ls -l /wwwroot目录确认文件权限是www用户或nginx用户,权限不对会返回403。
迁移后业务中断并不可怕,真正可怕的是把中断当成孤立事件处理。补救的核心逻辑只有一条:优先保证用户访问路径的通畅,再解决数据一致性,最后处理搜索引擎层面的历史记录,按照这个顺序走,站点不仅能快速恢复,后续的排名波动也能在可控范围内,最重要的是,建议在迁移前做好完整的预检和备份方案,零中断的上云迁移完全做得到,不必每次都走到补救这一步。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/757903.html