按照数据性质和用途,主要分为业务数据、配置数据、系统状态数据、日志与缓存数据五大类,其中业务数据是核心资产,而配置数据与日志往往被低估其价值。
服务器数据到底存储在哪里
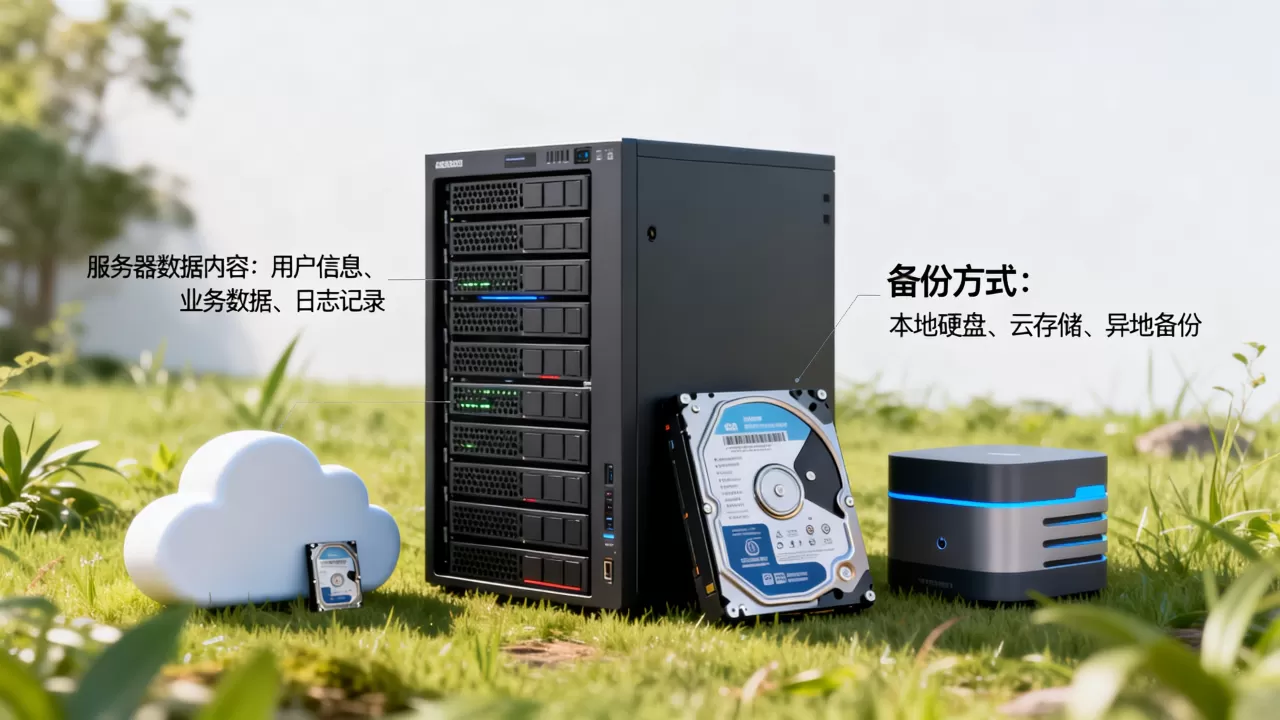
一次机房巡检时,技术主管指着机柜里嗡嗡作响的机器问过一句话:这玩意每天转个不停,里面到底装了多少种数据?当时这个看似基础的问题,其实是理解服务器运维和安全的起点,服务器里存放的数据,从物理载体来说,位于三种位置:本地磁盘阵列、内存与CPU缓存、以及外接的SAN/NAS存储设备,但从逻辑层面划分,内容就复杂得多。
业务数据是最核心的资产
应用产生的用户档案、交易流水、订单记录、产品目录,全部属于业务数据,这部分数据的特征是高价值、高敏感度、强实时性,数据库文件(如MySQL的ibd文件、PostgreSQL的数据目录)就是典型代表,一旦丢失,企业运转直接停摆,业内专家指出,绝大多数企业的数据保护成本,超过七成都花在这块数据上,备份策略的核心要务,就是优先指向这些业务库文件。
配置数据被严重低估
配置文件包含IP地址规划、防火墙规则、Web服务器虚拟机Host配置、负载均衡策略参数、定时任务调度表,为什么说它关键?因为配置数据属于不可再生的环境资产,业务数据丢了,花钱请人还能从交易对方对账找回部分;配置参数丢了,整套业务的网络出口、安全策略、服务调度逻辑全部归零,重建需要大量的试错时间,很多运维复盘“服务器数据内容有哪些”时,往往忽略了目录里的.env文件、Nginx的nginx.conf、SSH的authorized_keys这些都是值钱的配置数据。
系统与日志数据
操作系统层面的启动引导文件、内核模块、用户权限登记表属于系统数据,日志数据则包含访问日志、错误日志、安全审计日志、慢查询日志,日志的数据量巨大,但保留价值呈现极强的时效性,超过一定周期后,日志对排障的贡献率骤降,但它对安全审计和攻击溯源依然非常重要,运维实践中,日志数据通常结合logrotate做轮转压缩,存储周期设定在30天到180天之间较为常见。
数据量怎么估算
估算服务器数据内容总量,是规划磁盘空间的第一步,一台主流配置的物理机器,系统盘占用约20GB-40GB,业务数据则完全取决于应用类型,一个只跑企业官网的Nginx主机,一年可能只增长几GB静态资源;一套运行中的电商MySQL库,数据量年度增长率在80%-150%之间并不罕见。
用目录层级梳理数据全貌
用一条命令就能看清这台服务器存了什么大块头,在Linux环境下执行du -sh /,列出根目录下各一级目录的占用总大小,重点查看/var/lib/mysql(数据库物理文件)、/home(用户站点目录)、/www或/data(常见自定义部署目录)、/var/log(日志堆积地),这个方法在排查磁盘告警时非常高效,也能快速确认哪些数据类别占比失控。
临时文件与缓存数据不容小觑
服务器运行过程中会产生大量临时文件和缓存,比如PHP的session文件、前端CDN回源缓存、Redis持久化的RDB文件,生产环境中,曾出现过临时目录/tmp因异常进程写满100GB导致服务崩溃的案例,这部分数据的特点是可再生成、丢失代价低、占用不可预测,清理它需要小心Redis的RDB文件在持久化过程中强行删除,可能引发数据恢复异常,清理前最好确认服务状态。
数据价值怎么分级
备份前不排优先级,等于把逻辑错误的数据也当传家宝供着,数据的分级应该从恢复难度和时间成本两个维度衡量。
| 数据类别 | 典型载体 | 丢失后果 | 恢复优先级 |
|---|---|---|---|
| 核心交易数据 | Oracle redo日志、MySQL binlog | 业务停摆、财务损失 | 最高 |
| 用户上传文件 | 对象存储、NAS共享目录 | 用户体验受损 | 高 |
| 配置参数 | Nginx.conf、Rails的secret.yml | 服务不可用、安全隐患 | 高 |
| 日志审计 | /var/log/secure、access.log | 无法追溯安全事件 | 中 |
| 缓存与临时文件 | Redis快照、/tmp | 重新生成即可 | 低 |
行业共识认为,多数中等规模应用服务器上,日志数据占磁盘空间的比例可达整体存储的40%以上,但其中90天以前的日志几乎不再被访问,针对这一比例,建议冷热分离:热日志存储在高性能SSD上,冷日志归档到低成本硬盘或OSS对象存储中。
服务器数据备份方案有哪些
聊完服务器里装了什么,紧接着的问题必然是服务器数据备份方案有哪些组合,备份的本质,是把磁盘上静态的文件按照既定策略复制到另一处隔离位置,主流的方案有三类:本地备份至外接USB盘或另一块独立硬盘、远程增量备份至同机房另一台机器、异地云存储归档。
按备份形式拆解操作路径
全量备份是最传统的做法,直接拷贝全部数据目录,耗时长但恢复简单,增量备份只记录自上次备份以来变化的数据块,速度快但恢复链路长,比较依赖可靠的备份序列记录,差异备份介于两者之间,每次备份自上次全量备份以来的所有变化,恢复时只需全量加上最近一次差异。
生产线上最稳妥的路径是:脚本控制crontab,每天凌晨通过rsync同步业务目录到备份机,再用duplicity加密压缩后推送至异地对象存储,这样既保证了本机故障有近端副本,又兼顾了机房级灾难的远距离容灾。
数据库的热备与冷备要分清
数据库热备是在业务运行中直接执行mysqldump或使用xtrabackup物理备份,冷备则是停机后直接复制数据文件,热备对技术能力要求更高,需要理解binlog的位置点、GTID的同步关系;冷备简单可靠,但要付出业务中断的时间代价,现实中,大多数互联网公司的标准动作是热备加定期演练恢复流程,而不是停机冷备。
配置数据单独归档的必要性
配置文件不跟随业务数据一起打包备份,是初入行者常犯的错误,业务数据备份文件一旦损坏,恢复结果不理想;但配置文件如果被误覆盖,排查过程可以消耗一整天,实践中,Git版本控制配合定时推送,对/etc目录以及应用部署目录进行版本追踪是一个近乎完美的方案,把Puppet或Ansible的Inventory和Playbook文件纳入版本库,还能实现配置管理的自动回滚。
密钥与凭证单独存放
私钥、API Token、数据库密码这类敏感数据,绝不应该明文躺在业务数据备份文件里,若备份文件泄露,等于把服务器大门钥匙送给攻击者,建议使用Vault类工具统一管理,或至少对备份文件用GPG做非对称加密,密钥另行异机保存,这一环节,属于服务器数据内容里最容易被忽视的暗面。
服务器数据恢复怎么操作
一旦数据误删,恢复的入口取决于删除发生在哪一层,文件层删除,立刻停掉对该分区的所有写入操作,用extundelete或xfs_undelete尝试找回inode记录;数据库误更新,则依赖binlog的position点做基于时间点的回滚恢复;物理磁盘故障,那就需要交给专业数据恢复机构处理,这类服务的收费相对高昂,通常按恢复数据量计价,且成功率没有百分之百的保证。
恢复流程中,有一条至关重要的操作纪律:将故障盘完整挂载为只读,或者直接做全盘镜像后再操作,任何写操作都可能导致原本可恢复的目录项被二次覆盖,让数据永久消失。
服务器数据内容有哪些常见疑问
云服务器上的临时文件会自己清理吗
Linux系统并不会主动扫描清理/tmp目录下的陈旧文件,部分发行版带有systemd-tmpfiles服务,但它只清理特定规则列表里的内容,并不覆盖所有应用写入的临时文件,定期人工巡检加上合理的日志轮转策略,才是稳妥的做法。
数据盘和系统盘应该分开存放数据吗
应该,操作系统重启或系统崩溃后,系统盘数据存在损坏可能,而独立数据盘承载核心业务数据,故障域被物理隔离,持久化和恢复的可靠性会高很多。
服务器日志需要保留多久
无合规要求时,访问日志保留90天是平衡存储成本与排障需求的常见值,安全审计类日志保留期至少180天,如果业务涉及等级保护测评,日志留存时间应按照各级要求执行,常见标准为不少于六个月。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/758446.html