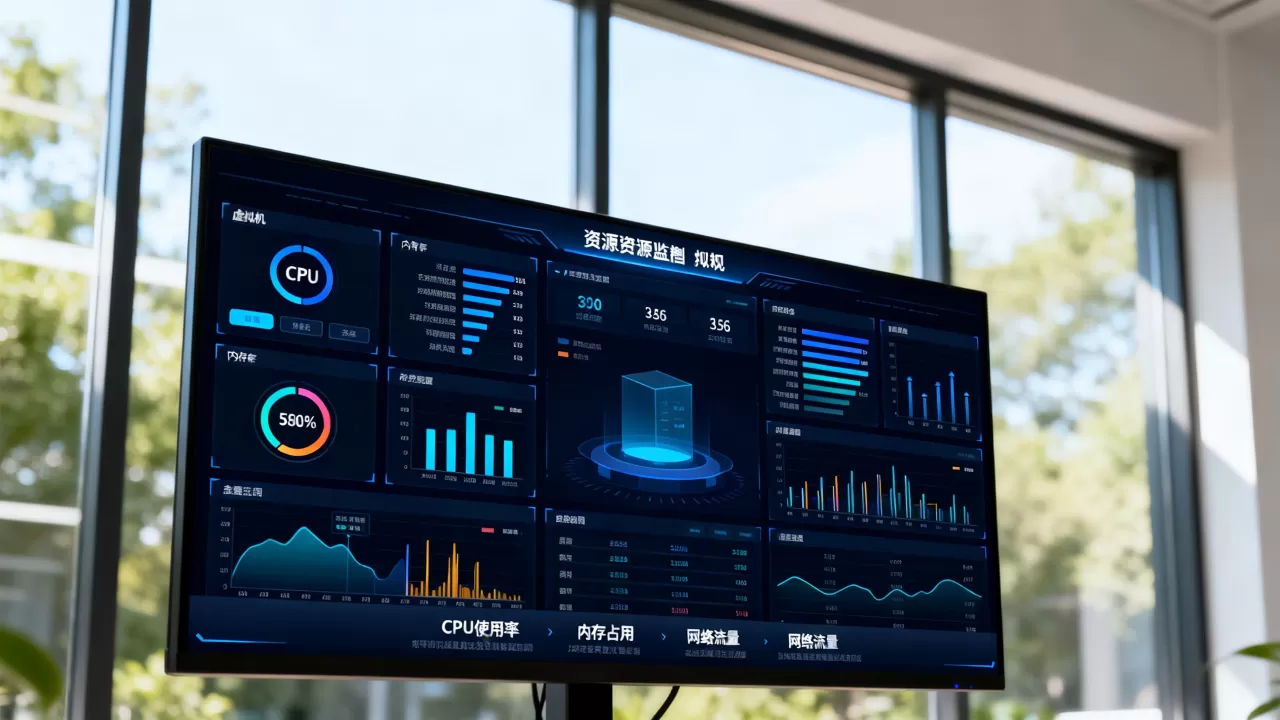
虚拟机大屏做的不是数据展示,而是把分散在几十台宿主机上的CPU、内存、磁盘、网络状态压缩成一眼能看懂的风险信号。真正高效的监控大屏,核心在于分级预警和关联分析,而非密密麻麻的曲线图。
为什么你需要的不是一块屏,而是一套筛选逻辑
很多运维团队把大屏做成了“数据搬家”,把每台虚拟机的指标全部堆上去,结果屏幕越换越大,值班人员反而越来越焦虑,业内专家指出,人在同一时间能有效处理的信息不超过五个维度,超过这个阈值,再丰富的仪表盘也只是视觉噪音。
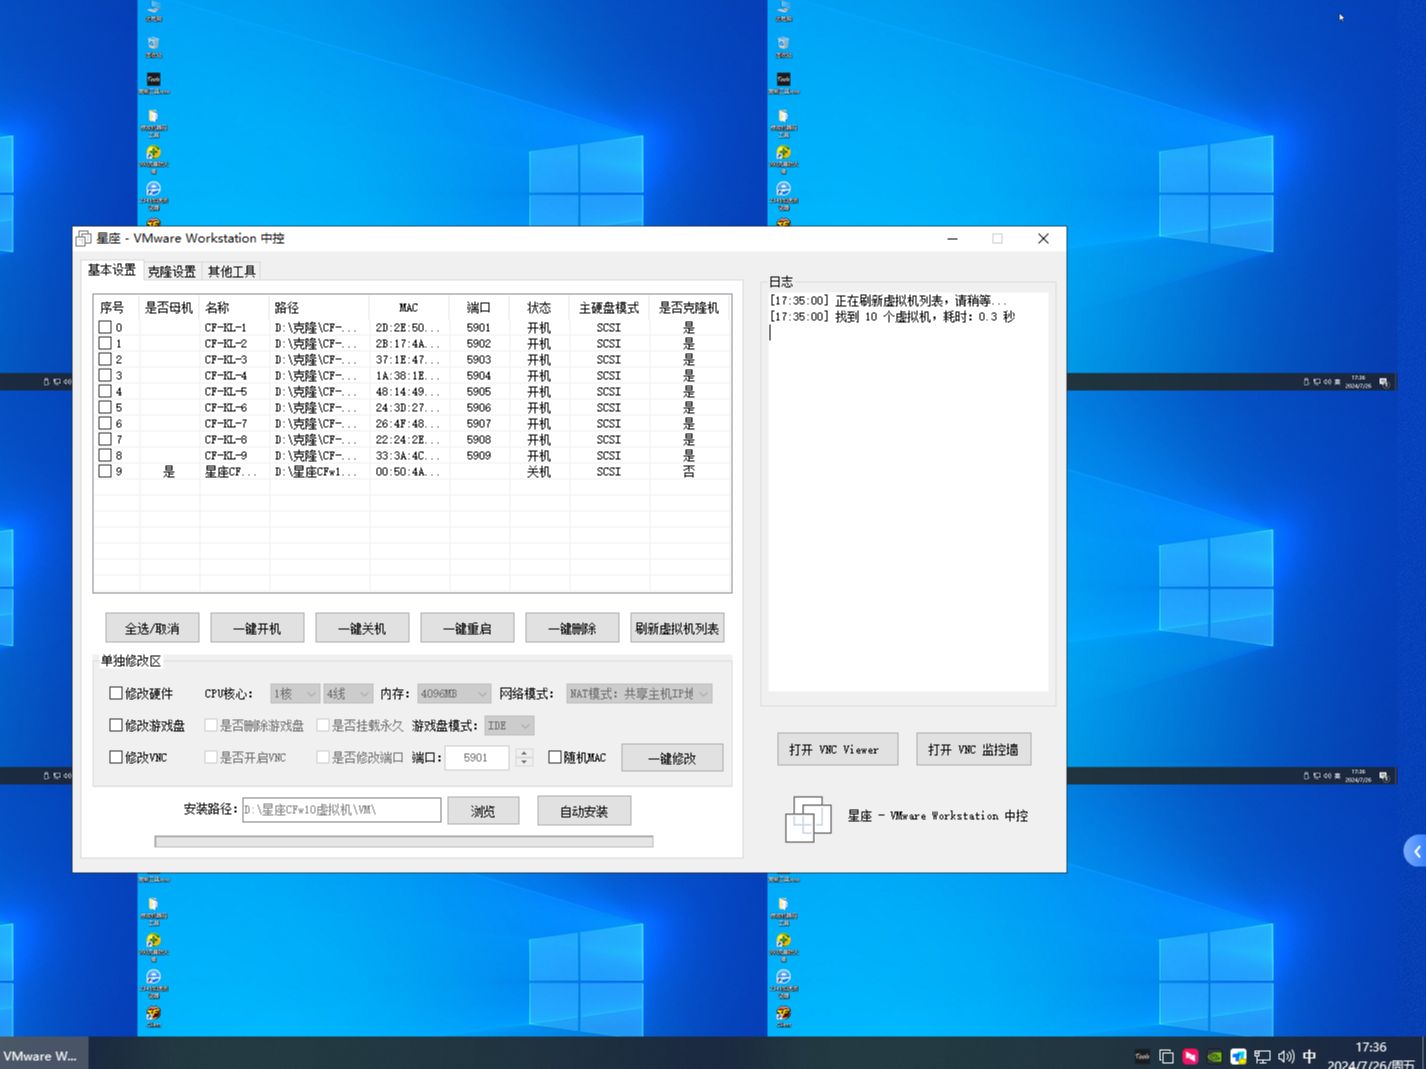

虚拟机大屏的初衷是缩短故障定位时间,不是制造新的信息过载,你需要的是这样一块屏:平时扫一眼就知道一切正常,出问题时第一时间告诉你哪里疼、为什么疼,这种筛选逻辑比任何炫酷的可视化特效都值钱。
虚拟机资源监控指标,别让大屏变成“吉祥物”
先想清楚什么值得上屏:只有那些直接关联业务稳定性的指标才配占用一块屏幕,设备台账、虚拟机清单、历史报表这些内容,留给后台查询页面就好。
第一梯队:生死攸关的硬指标
- CPU就绪时间:这是虚拟机等不到物理CPU时间片的总时长,直接反映宿主机是否超卖,就绪时间持续超过20%,说明CPU资源已经捉襟见肘。
- 内存换页率:虚拟机发生内存换页意味着性能断崖式下跌,尤其要关注SWAP使用量,这个数值一旦持续上涨,基本可以去排查是不是内存泄漏了。
- 磁盘延迟:区分读写延迟,特别是IOPS的排队长度,排队越久,业务卡顿越明显,这个指标比磁盘使用率更能暴露问题。
- 网络丢包率:物理网卡和虚拟交换机两个层面分别监控,不仅能发现链路故障,还能顺藤摸瓜找到某些“话痨型”虚拟机在刷流量。
第二梯队:事后的水位参考
存储使用率和虚拟机密度不用实时刷新,每5分钟更新一次就够,真正专业的团队还会加一条宿主机负载均衡度,用颜色深浅表示集群内各物理节点的压力差异,一眼就能看出哪台宿主机被重点照顾了。
如何搭建受控的虚拟机大屏监控方案
市面上的方案五花八门,但靠谱的部署路径就那么几条,核心原则是:先定义故障场景,再选技术栈,常见场景无非三类:宿主机宕机、单台虚拟机资源耗尽、平台性能整体劣化,每种场景对应不同的视图和阈值策略。
基于Prometheus全家桶的定制路线
这套组合拳在开源社区认可度较高,数据链路清晰可控:
- 数据采集:部署node_exporter采集宿主机指标,用vmware_exporter或libvirt_exporter拉取虚拟机的vCenter/OpenStack数据,采集间隔设在15秒。
- 数据存储:Prometheus负责时序数据保留,存储时间视磁盘容量而定,通常保留15到30天就够用。
- 可视化呈现:Grafana是主力表现层,选用自带的大屏模板,配合VictoriaMetrics作为Prometheus的远端存储,在大规模集群场景下查询速度会好很多。
- 阈值设计:先按保守值设置黄色预警和红色告警,例如CPU就绪时间超过5%为黄色,超过10%为红色,运行两周后再根据实际基线调整。
商业运维平台的“开箱即用”路线
如果团队没有专职运维开发,直接购买商业方案往往性价比更高,部分云管理平台自带大屏模块,支持纳管VMware和Hyper-V。这类方案的筛选逻辑、告警收敛都是封装好的,虽然花钱,但省掉了从零调优的漫长周期。
大屏布局的实战建议
- 顶部留出全局健康度横幅,用红黄绿三色概括整个虚拟化集群的状态。
- 中部左侧放宿主机热力地图,按CPU、内存、网络三个维度分别着色,热点区域一眼可见。
- 中部右侧放异常虚拟机TOP10列表,列出CPU就绪时间、磁盘延迟、网络丢包三个关键指标的“罪魁祸首”。
- 底部放近期趋势折线,每条曲线只保留24小时窗口,别放月维度数据大屏不是给你复盘用的,是让你当下做决策的。
避坑指南:三个多数人绕不过去的坎
依赖默认模板而不做整合,默认模板是把所有指标全部平铺,你需要大刀阔斧地砍掉冗余,判断标准很简单:这个指标异常时,你会不会因此采取行动?不会行动,就删掉。
告警配置只设阈值不设收敛,不少团队的告警风暴都是这样来的一台宿主机宕机,上面所有虚拟机同时告警,大屏直接变成一片红海,务必配置通知抑制和分组规则,让一条宿主机故障只产生一条聚合告警,避免刷屏带来的疲劳感。
忽视历史基线对比,一块优秀的大屏必须支持“一键切换”到昨日同期的数据视图,没有基线参照,很多指标异常你根本看不出来,就像看体温不对比正常值,单看37.5度你也不知道算不算发烧。
软件选择不决?先看规模再选路线
团队规模和数据量级直接决定技术选型:
| 集群规模 | 推荐方案 | 理由 |
|---|---|---|
| 10台宿主机以内 | Grafana + 单机Prometheus | 部署成本低,满足日常监控即可 |
| 10-50台宿主机 | Prometheus + Thanos | 多集群数据统一查询,大屏数据源更规范 |
| 50台以上或跨机房 | 商业CMP平台或自研 | 定制化程度高,性能优化的可能性更大 |
建议:多数中小企业处于第一档,用开源方案完全够用,别盲目追求大厂架构,轻量级方案带来的安心感反而更实在。
大屏上线后的两个检查小动作,检验它到底有没有用
方案落地后,别急着宣告大功告成,关掉大屏界面,在模拟环境里做一次故障演练:手动把一台虚拟机的磁盘IO拖到饱和
,看大屏能否在10秒内给出准确提示,再拔掉一台宿主机网线,观察告警是否收敛成一条、信息是否精准,这两步走完,你才真正拿到了那块“信得过”的屏。
虚拟机大屏监控,本质是在管理中植入确定性
这块屏真正的价值,是建立起“指标异常 → 定位到宿主机 → 分析关联虚拟机 → 执行恢复动作”的标准化路径,当整个虚拟化环境的状态能被压缩到七寸大小的信息面板上,你不需要成为性能调优专家,也能在关键时刻做出站得住脚的决策。
虚拟机大屏监控常见问题解答
大屏上哪些资源指标必须实时刷新,哪些可以放宽?
CPU就绪时间、内存换页率、磁盘延迟、网络丢包率必须做到15秒内的实时刷新,存储使用率、虚拟机密度、宿主机负载均衡度这类水位数据,每5分钟更新一次就足够了,实时数据全部高频刷新反而会让大屏显得过分拥挤拥挤,既不美观也不利于快速扫视。
付费版虚拟机大屏监控方案和开源方案核心区别在哪?
核心区别在于告警收敛的成熟度和数据关联分析的逻辑是否完整,开源Prometheus架构提供的是基础采集与展示能力,需要自己动手写告警规则、配置抑制策略;付费方案将这些逻辑封装成了可视化向导,同时还附带vCenter的深度关联分析能力,比如一键查看物理宿主机的CPU就绪与该宿主机上所有虚拟机表现的关联关系,多基础设施团队往往倾向于采用付费方案,这类工具配置周期较短,不需专业开发人员也能快速响应各类故障。
虚拟机大屏持续显示高分位延迟数据,说明宿主机遇到了什么问题?
高分位延迟持续偏高,很大概率是宿主机层的存储控制器或物理网卡出现了饱和,建议先登录宿主机查看存储适配器的队列深度,再检查虚拟交换机上是否有异常流量占用带宽,排除硬件问题后,依次迁移该宿主机上的部分虚拟机做负载卸除,如果迁移后延迟恢复正常,则说明是虚拟机密度过高导致资源争用,需要重新规划虚拟机布局。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/758689.html