因子计算悄悄占走的内存带宽账本,核心答案就一句话:多数情况下,真正的瓶颈不在CPU算得慢,而在数据从内存到处理器的搬运过程拥堵不堪。跑因子时系统卡顿,算法工程师往往盯着CPU占用率,却忽略了内存带宽这位“送货员”早已累得气喘吁吁,账本里每一笔数据搬运都被记在了因子计算的头上。
因子计算内存占用高在哪:内存带宽账本的三个秘密
内存带宽的消耗不来自单次运算,而来自对同一批数据的反复读取,因子计算恰恰是一个疯狂“翻旧账”的过程,业内专家指出,多因子模型跑得慢的原因,约八成出在存储层级的数据搬运,而非浮点运算本身。

滚动窗口的历史包袱
以最常见的20日均线因子为例,计算某个交易日当天的均线值,需要回溯前19天的收盘价,每一只股票的每一次计算,都相当于把20个数据点从头到尾读一遍,如果一件商品在超市货架上被取了20次,仓库的出货记录自然多20行。
滚动窗口的规模放大效应远未被多数人察觉,全市场5000只股票,每只股票做30日滚动窗口的动量因子,一次因子截面计算就要触发150万次独立读取操作,窗口越长,历史包袱越重,内存被反复翻动的次数呈线性增长,带宽账本从底稿开始就填满了数字。
数据对齐的临时仓库积压
因子计算很少只面对单张表,日线数据、月线数据、财报数据、行业分类表,每一样都以独立DataFrame或数组形式存在,做一次频率转换或表关联,系统先要为结果分配一块临时内存,再把两侧数据按匹配键复制到新地址。
最典型的场景是把日频因子降采样成月频,或者把行业分类映射到每只股票上,中间生成的临时对象如果比源数据还大,内存带宽就变成了一个临时工:一边接收旧数据,一边搬往新仓库,两边同时占道,相比之下,真正的分组聚合运算反而只消耗少量带宽,大头全部耗在搬运布局上。
协方差矩阵的全量读盘行为
Barra风格因子或自定义多因子模型的风险分析中,协方差矩阵是不可绕过的步骤,该矩阵的维度等于因子个数,矩阵里每个元素都要通过读取历史收益率序列计算得出,因子数量从10扩到50,矩阵元素数量从100成长到2500,每个元素背后又是一整段历史数据的读取。
就算矩阵已经构建完成,后续的特征分解或求逆操作,同样需要反复扫描整个矩阵,内存带宽的账本上,这一项不仅字迹潦草,而且金额巨大,行业共识认为,把协方差矩阵的更新频率从每日一次降低到每周一次,能明显缓解多因子模型计算速度慢的焦虑。
多因子模型计算速度慢的根源,从内存搬运说起
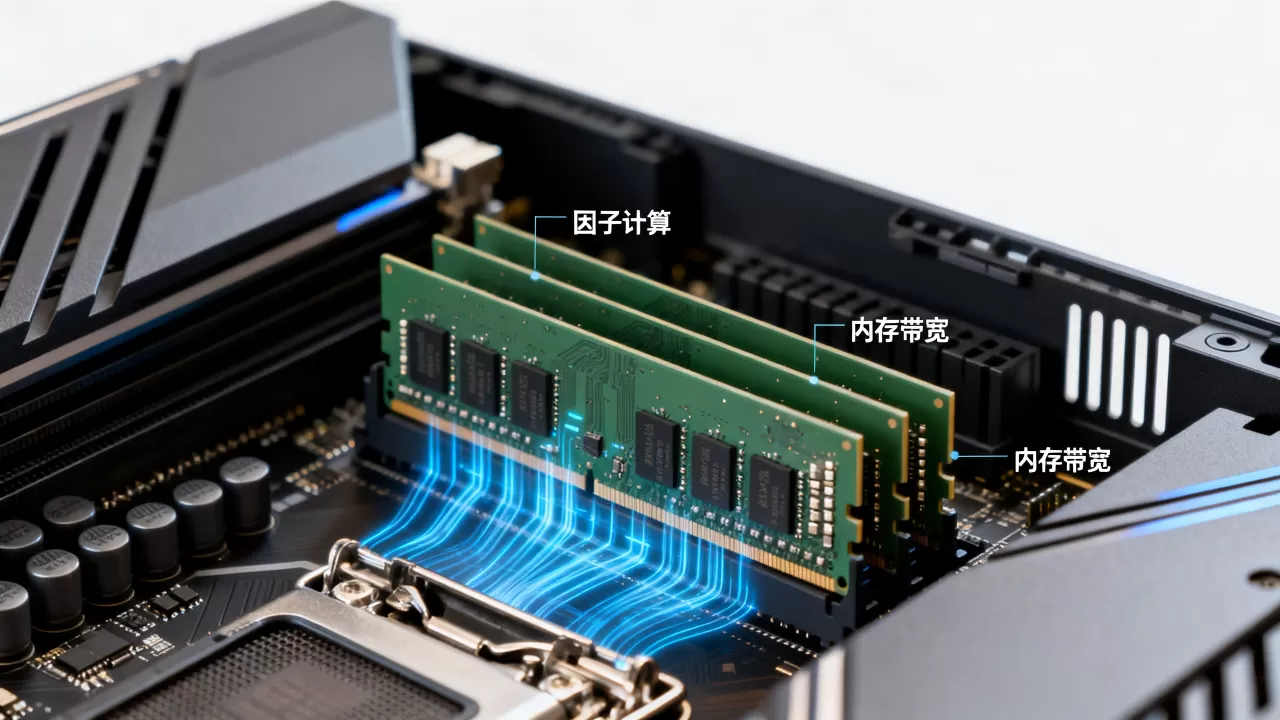
一台服务器的内存带宽是固定大小的,数据从DRAM被搬运到CPU缓存,每秒钟能通过的车流量就那么多,因子计算的任务总量不变,带宽需求却随着数据规模和市场复杂度的增加持续膨胀,许多量化团队把大量预算花在核心数更多的CPU上,结果收效甚微。
CPU占用率低但程序卡顿的怪象
打开任务管理器,会发现CPU利用率只有30%到40%,内存占用也不高,但因子计算流程就是迟迟跑不完,这不是死锁,也不是算法退化,而是处理器核心大部分时间处于等待数据状态,所有执行单元都在干瞪眼。
计算1000只股票、50个因子每日暴露度的典型任务中,线程不断向内存控制器发出读取请求,但内存总线的繁忙程度已经接近极限,CPU核心一个时钟周期能完成几十次浮点运算,内存通道一个周期却只能送出几笔数据,比例失衡的结果就是CPU“等货上门”,多因子模型计算速度慢到让人误判为死机。
缓存命中率是隐形账单
内存带宽的消耗与缓存命中率密切相关,循环嵌套遍历DataFrame的行,每访问一个单元格就触发一次地址跳转,CPU的L1缓存被反复冲掉,数据不得不频繁回到DRAM主存重新领取,缓存存不住,内存带宽就变成了唯一的数据来源。
内行人早已形成共识:同样的因子逻辑,用列式存储和批量向量化实现,与逐行遍历的写法相比,访存量可以差出多个数量级,有些人写因子时喜欢用for循环遍历每一行,表面看代码清晰,实际上是在给内存带宽的账本上疯狂记赤字。
算术强度低,搬运工却满负荷
因子计算中相当一部分操作属于低算术强度任务,比如取一段收盘价算均值,做一次截面排序,把两个序列错位相减,这些操作本身几乎不消耗CPU算力,但涉及的数据量极其庞大。
把CPU比作高速机械臂,一次抓取和处理只需1秒,内存带宽却是单车道传送带,每一秒只能送过来一个包裹,机械臂经常空转等待包裹抵达,整体产出完全取决于传送带速度,多因子模型计算速度慢的根源,正在于搬运工与机械臂之间的速度错配。
释放内存带宽压力的实操优化与长效方案
既然账本已经摊开,优化思路就清楚明确:要么少搬数据,要么让单次搬运的性价比更高,以下是经过真实场景检验的因子计算优化方法,直接照着做就能看到效果。
向量化改造与数据布局调整
- 用NumPy数组替代DataFrame的行级循环,把整列数据一次性送入CPU缓存处理
- pandas操作底层尽量走C-level的矢量化路径,避开Python解释器逐元素处理
- 数据存储统一按列式排列,保证读取连续内存地址,提高缓存行利用率
实操路径:把原始日线行情加载后先转换为float32类型的NumPy矩阵,再做滚动窗口计算,数据存储容量减半,内存带宽消耗同步缩减,因为每个数据点占用字节数变少,单位时间能搬运更多有效信息。
减少临时对象与复制次数
- 读Parquet文件时,通过
columns参数只加载实际用到的字段,不碰整张宽表 - merge操作之前,先按股票代码分组切片,把大表关联拆成小表关联,避免笛卡尔积爆炸
- 查看代码里是否有
copy()调用,很多情况下的复制根本没有必要,直接删掉即可
另有更细一层:对因子值做去极值、标准化时,尽量避免在原地反复创建新数组,用np.subtract、np.divide的out参数写入预分配缓冲区,一次内存写回完成多步运算。
mmap映射与分块计算
面对五年甚至十年的全市场日频数据,一次性载入内存既不经济也没必要,改用内存映射文件方式加载数据,操作系统按需从磁盘调页,不用的历史数据自动淘汰,内存带宽的压力大幅降低。
实操步骤:
- 将日线行情按交易所和股票代码拆分为独立二进制文件,例如每股一个
.npy或.bin - 计算时逐个映射对应股票文件,数据窗口内只保留当段K线序列
- 全部算完后再汇总结果,写回Parquet或数据库
这种方法尤其契合滚动窗口类因子:每次只用读入目标区间的那一小段数据,前面的历史区块不参与搬运,跑全市场5000只股票的长期因子时,多因子模型计算速度慢的问题在这一步就能解决大半。
优先级治理与错峰运行
内存带宽是共享资源,同一台服务器上若还有其他行情落地脚本、风控扫描任务,它们会与因子计算争抢带宽,优化方式不只在代码层面,还可以在任务调度上做文章。
在Linux服务器上,将频繁触发因子计算的定时任务绑定到空闲CPU核心,防止其漂移抢占关键计算线程,或者把行情落地时间安排在因子批处理完成之后,让每个时段只有一名“搬运工”在场,带宽账本就能保持收支平衡。
硬件升级可不可行
软件优化解决效率问题,硬件升级解决天花板问题,选购新机器时,优先关注内存通道数和内存频率,而非单纯看核心数量,双通道内存是底线,四通道更好,内存主频越高,单位时间搬运的数据量就越可观。
以下是不同配置的直观差异参考:
| 内存配置 | 相对带宽表现 | 适用场景 |
|---|---|---|
| 单通道DDR4 2666 | 入门级,狭小单行道 | 少量股票分钟级因子 |
| 双通道DDR4 3200 | 双车道,冗余度尚可 | 常规全市场日频因子 |
| 双通道DDR5 4800+ | 明显宽裕,高速路 | 多因子模型频繁迭代 |
| 四通道DDR5服务器配置 | 开阔干线,吞吐充足 | 协方差矩阵高频更新 |
如果云服务器跑量化交易因子计算,选实例时不要只盯着内存容量,更要看规格说明里的内存带宽指标,同样的价格,高带宽实例对纯因子计算任务往往带来更显著的提速效果。
内存带宽账本并不会主动消失,只会随数据规模的膨胀越记越厚,想解决因子计算内存占用高的问题,核心思路永远是压缩搬运次数、提升单次搬运效率,把带宽留给真正需要读入的数据,多因子模型计算速度慢的体验就会自然好转。
Q&A
因子计算内存占用高怎么办?
先排查三处:滚动窗口内部是否存在整段历史数据反复扫描,表关联是否产生了大量临时中间对象,因子遍历是否以逐行循环方式触碰所有列,把这三处优化掉,内存带宽压力通常能下降明显,监控工具方面,Linux下用perf stat查看缓存未命中率,或在任务管理器性能页签观察内存带宽占用曲线。
多因子模型计算速度慢和内存带宽有关系吗?
关系非常直接,多因子计算涉及大量矩阵运算、滚动窗口和表对齐操作,数据搬运量远超算法本身的指数量级,处理器运算速度远高于内存传输速度,访存密集的任务中计算单元大多在等待数据抵达,瓶颈落在内存总线的吞吐能力上,CPU核心数再多也难以缓解。
量化交易因子计算用什么配置更合适?
自建主机优先考虑双通道以上DDR5高频内存,搭配大缓存处理器,系统盘用NVMe固态存放行情源文件,云服务器则重点参考实例规格的带宽参数量级和NUMA拓扑,通过numactl --hardware确认内存与CPU的亲和性后绑定运行,比单纯加内存容量更能提升因子回测效率。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/759232.html